
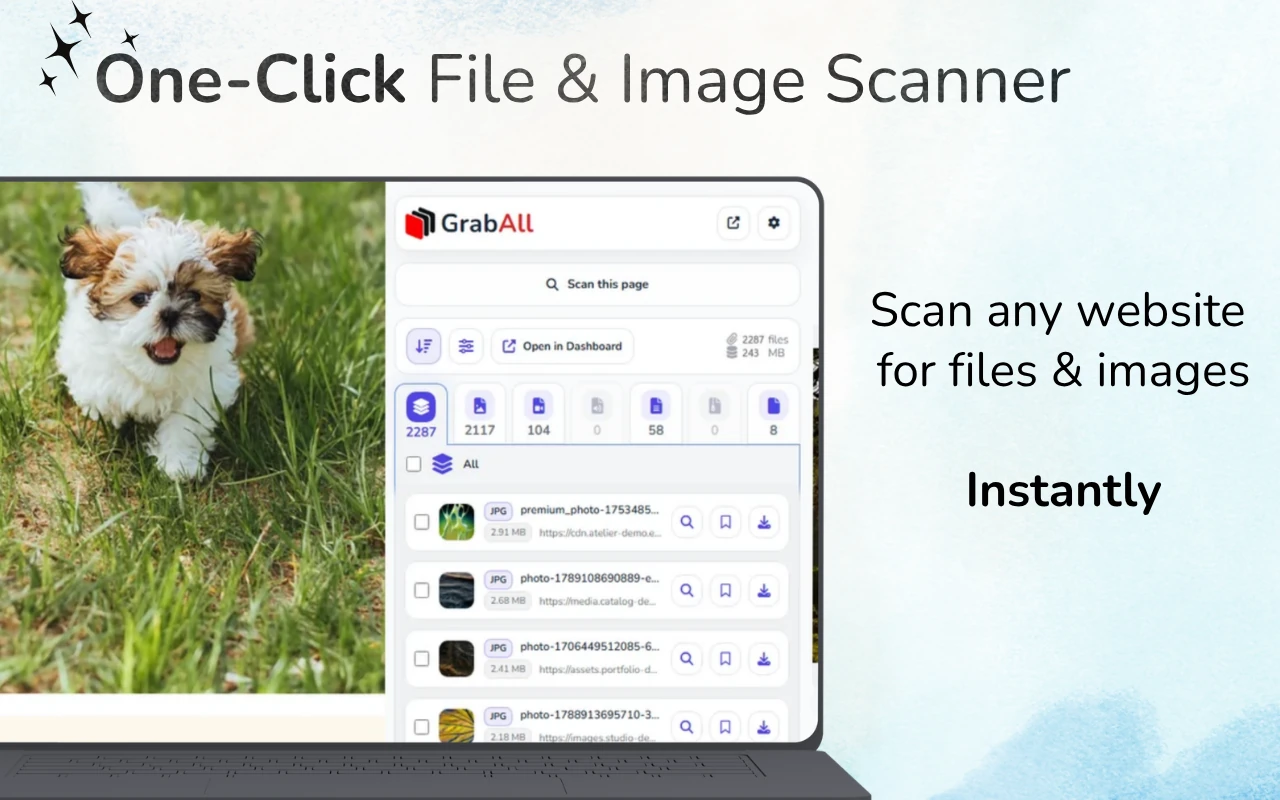
Hurtigt svar: For en live-webside skal du scanne med GrabAll og kopiere de fundne fillinks. For gemt HTML eller kopieret kildekode skal du indsætte den i Bulk File URL Extractor. Angiv en basis-URL, når kilden indeholder relative links.
Vælg mellem at scanne en side og parse indsat HTML
Scanning af en indlæst webside kan finde filer, der er tilgængelige online eller i browseren, mens du kun læser de filer, der er tilgængelige online eller i browseren. Vælg den metode, der matcher dit udgangspunkt, og gennemgå derefter de resulterende URL'er, før du bruger dem til downloads.
Hvor fil-URL'er vises i HTML
Almindelige links bruger href, mens billeder og medier normalt bruger src. Responsive billeder kan liste flere kandidater i srcset. Lazy-loading biblioteker gemmer ofte rigtige URL'er i data-src, data-original eller brugerdefinerede dataattributter.
Stilark og inline CSS kan referere til baggrunde gennem url(). Råtekst kan også indeholde komplette URL'er, der ikke er knyttet til et HTML-element.
- href-links
- src og poster attributes
- srcset og data-srcset kandidater
- CSS url()-værdier og rå absolutte URL'er
Løs relative stier korrekt
En værdi som ../files/report.pdf er kun meningsfuld i forhold til den side, hvor HTML'en kom fra. Angiv den originale side-URL som base, så udtrækkeren kan omdanne relative stier til komplette adresser.
Protokol-relative links, der normalt starter med den //S-side. Rod-relative stier, der begynder med/brug den aktuelle hjemmesideoprindelse.
- Behold den originale kildeside-URL
- Brug den som basis-URL
- Normaliser protokol-relative og rod-relative stier
- Gennemgå de løste domæner, før du bruger listen
Filtrer kandidat-URL'er efter hensigt
Ikke alle URL'er i kildekoden er et aktiv, der kan downloades. Sider indeholder navigationslinks, API'er, analyser, skrifttyper, scripts, stylesheets og sporingsparametre. Filtrer efter relevante udvidelser og undersøg tvetydige URL'er.
For billeder skal du inkludere moderne formater som WebP og AVIF. For dokumenter skal du overveje PDF, DOCX, XLSX, CSV, PPTX og arkiver i henhold til opgaven.
HTML-kilde versus den gengivede side
Kopieret kilde repræsenterer kun det, du har leveret. Det kan gå glip af ressourcer indsat efter JavaScript kører, indhold indlæst efter rulning eller URL'er oprettet under interaktion.
Brug offlineudtrækkeren til kildeuddrag, eksporteret HTML, e-mailskabeloner og kodegennemgang. Brug GrabAll-udvidelsen til den livegengivne side og browser-kontekst-arbejdsgange.
Valider før download
Dedupliker listen, inspicer domæner, og test en lille prøve. En matchende udvidelse i en URL garanterer ikke, at svaret er gyldigt, eller at du er autoriseret til at bruge det.
Undgå automatisk at anmode om store ikke-gennemgåede lister. Validering forhindrer ødelagte links, uønskede sporingsendepunkter og unødvendig belastning.
Ofte stillede spørgsmål
Kan udtrækkeren løse ../ relative links?
Ja, når du angiver den originale side-URL som basisadresse.
Inkluderer HTML-udtrækning srcset-billeder?
GrabAll-værktøjet kontrollerer almindelige kilde- og responsive-image-attributter, inklusive srcset-kandidater.
Hvorfor mangler nogle live-side-filer fra kopieret HTML?
JavaScript kan tilføje dem efter den første HTML-indlæsning. Brug live browserudvidelsen til gengivet og dynamisk indlæst sideindhold.
Er alle udpakkede URL'er sikre at downloade?
Nej. Gennemgå domæner, filtyper, tilladelser og en lille prøve, før du bruger en resultatliste.
GrabAll scanner siden og bringer billeder, dokumenter, medier og andre filer, der kan downloades, på én overskuelig liste, så du kan vælge præcis, hvad du vil gemme.