



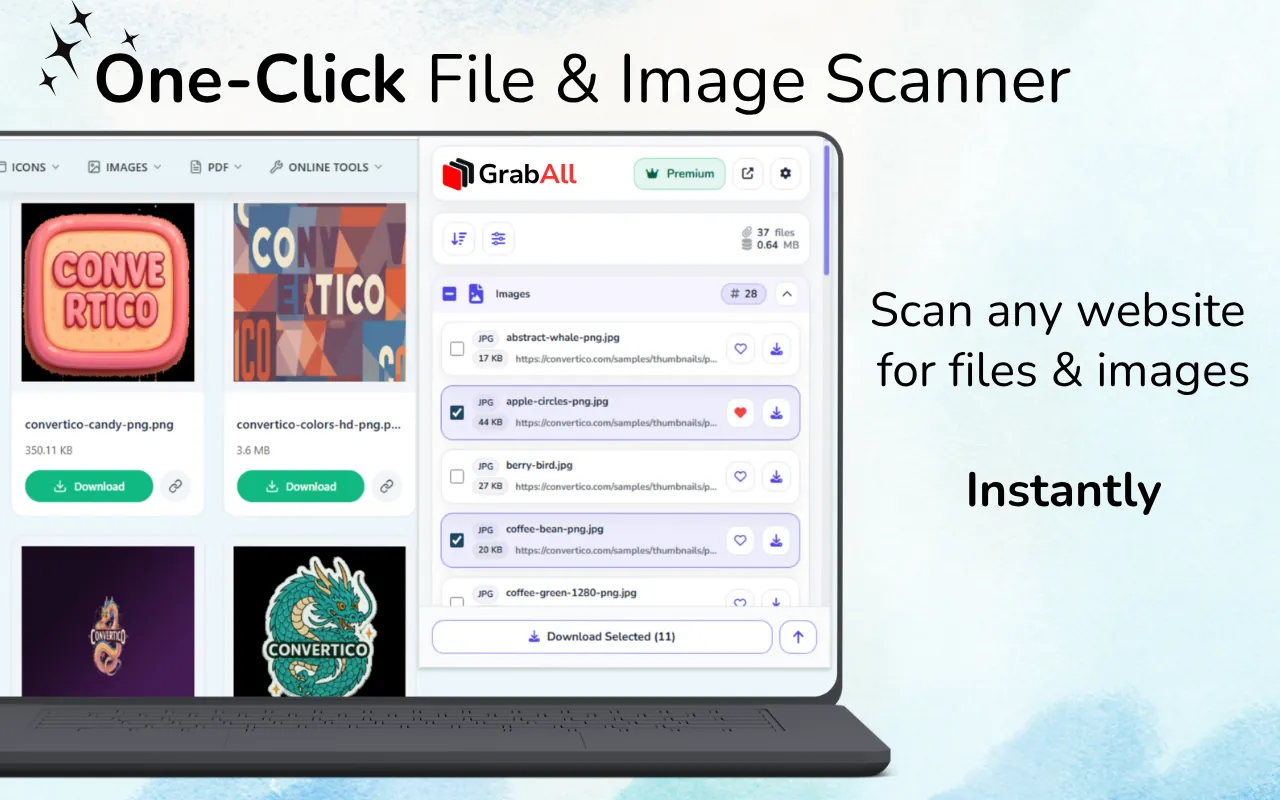
Respuesta rápida: Abre la página web, carga el contenido relevante y escanéalo con GrabAll. Filtra los archivos detectados por tipo o tamaño, revisa las vistas previas y los nombres de archivo, luego guarda o copia los enlaces seleccionados. Algunos recursos aparecen solo después de interactuar con la página.
Busca enlaces de archivos en la página cargada
Los botones de descarga, las listas de documentos, las tarjetas de imágenes y los elementos multimedia pueden exponer archivos. Comienza cargando la sección que contiene los recursos, luego escanea y revisa los resultados. Un escáner solo puede listar los recursos que la página pone a disposición del navegador.
Qué se considera un archivo descargable
Un archivo descargable puede ser un documento vinculado, una fuente de imagen, un elemento multimedia, un archivo, una hoja de cálculo u otro activo público referenciado por la página. El navegador debe saber lo suficiente sobre el recurso para solicitarlo o mostrarlo.
Encontrar archivos en una página no significa explorar el servidor. GrabAll trabaja con las URL que la página actual expone, no con directorios privados ni con contenido oculto del servidor.
- Anclajes a documentos y archivos
- Imagen src, srcset y atributos de carga perezosa
- Video, audio, poster y elementos fuente
- Archivo público URLs presente en el texto de la página o atributos de datos
Un proceso ordenado para encontrar archivos
Escanee la página más relevante primero. Resultados de grupo por tipo, luego inspeccionar las extensiones de archivo, MIME insinúa, dimensiones, tamaños y dominios fuente. Use previsualizaciones donde esté disponible.
Si la página es dinámica, permita que la sección pertinente se cargue antes de escanear. Evite desplazarse por áreas no relacionadas porque eso puede agregar recomendaciones y activos de navegación al conjunto de resultados.
- Elija una página especÃfica
- Cargar el contenido relevante para la tarea
- Resultados del grupo por tipo
- Filtrar, prever y seleccionar los archivos útiles
URL sin una extensión evidente
Algunas descargas utilizan rutas como /download?id=123 en lugar de nombres que terminan en .pdf o .zip. Estos enlaces son más difÃciles de clasificar antes de que responda el servidor. El texto del enlace, los encabezados de respuesta y el comportamiento de descarga del navegador pueden aportar más información.
No asuma cada largo URL es un archivo. Seguimiento, navegación y enlaces API pueden parecer similares.
Cuándo conviene analizar la página en lugar de revisar el código fuente
Viewing HTML source puede ayudar a los usuarios técnicos, pero las páginas modernas suelen agregar contenido después de las cargas iniciales del documento. Una extensión del navegador puede inspeccionar el contexto renderizado y presentar resultados en una interfaz orientada a la revisión.
Para analizar HTML pegado o código fuente guardado, utiliza el Extractor de URL de archivos gratuito. Para la página en vivo, utilice GrabAll para que pueda combinar el descubrimiento con vistas previas y la selección de descargas.
Qué resultados puedes esperar
Los archivos detrás de la autenticación, generados después de las llamadas API protegidas, almacenadas en sistemas privados o entregadas a través de DRM están fuera del alcance de un escáner de página normal. Respetar las reglas de acceso y utilizar los controles oficiales de descarga cuando se disponga.
Los mejores resultados provienen de páginas que exponen deliberadamente enlaces de recursos, galerÃas, archivos adjuntos, documentos o archivos multimedia ordinarios.
Preguntas frecuentes
¿Puede GrabAll encontrar archivos que no están enlazados en la página?
No. Organiza recursos y enlaces disponibles para el navegador; no busca directorios de servidores privados o revela archivos no expuestos.
¿DeberÃa escanear la página principal o una página especÃfica?
Utilice la página más especÃfica posible. Produce menos activos no relacionados y resultados limpios.
¿Qué pasa si un URL no tiene extensión de archivo?
TodavÃa puede producir una descarga, pero la clasificación es menos confiable hasta que el servidor responda. Revise la etiqueta de página y utilice el control oficial cuando sea incierto.
¿Puedo extraer enlaces desde HTML copiado?
SÃ. GrabAll ofrece un Extractor de URL de archivos gratuito para analizar HTML, código fuente y texto pegado.
GrabAll analiza la página y reúne imágenes, documentos, archivos multimedia y otros archivos descargables en una lista clara para que elijas exactamente qué guardar.