



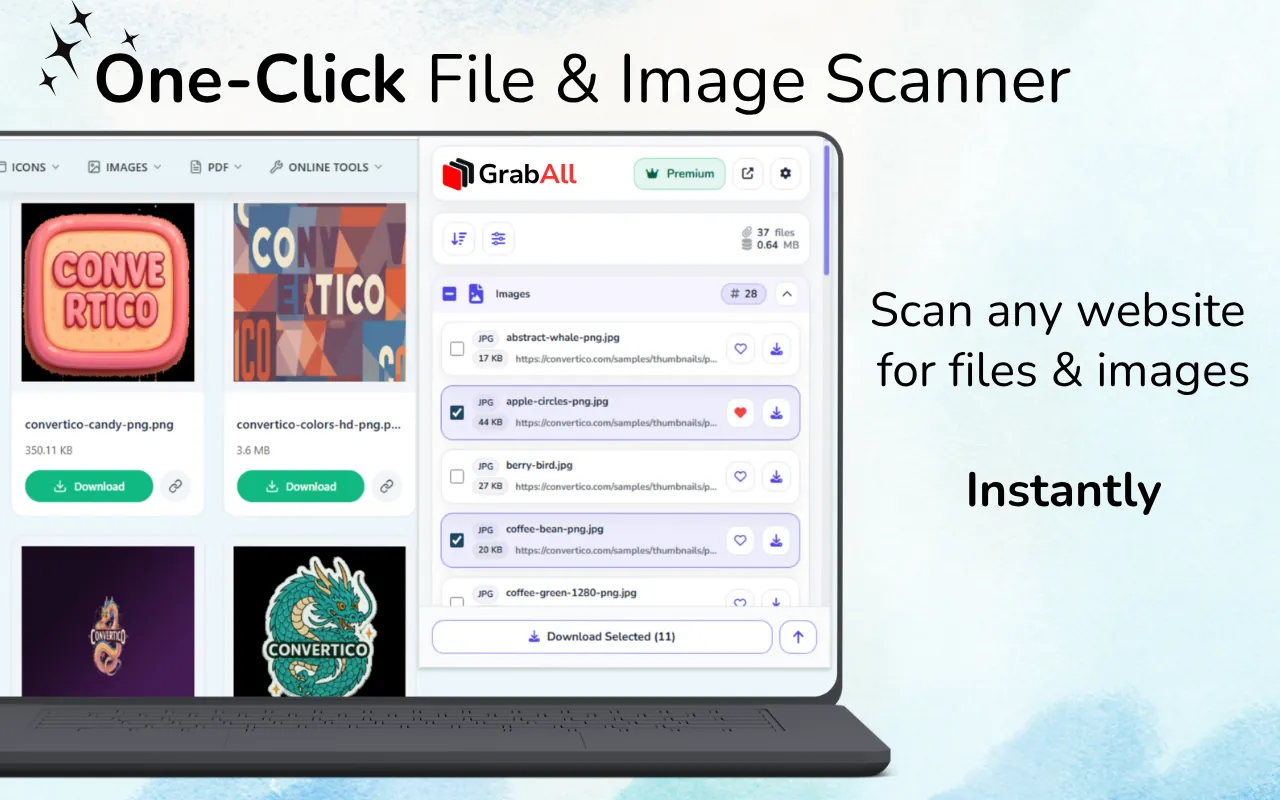
Réponse rapide : Ouvrez la page web, chargez le contenu pertinent et analysez-le avec GrabAll. Filtrez les fichiers détectés par type ou taille, vérifiez les aperçus et les noms de fichiers, puis enregistrez ou copiez les liens sélectionnés. Certaines ressources n'apparaissent qu'après une interaction avec la page.
Recherchez des liens de fichiers dans la page chargée
Les boutons de téléchargement, les listes de documents, les cartes d'images et les éléments multimédias peuvent tous révéler des fichiers. Commencez par charger la section contenant les ressources, puis analysez et examinez les résultats. Un scanner ne peut lister que les ressources que la page met à disposition du navigateur.
Qu'est-ce qu'un fichier téléchargeable ?
Un fichier téléchargeable peut être un document lié, une source d'image, un élément média, une archive, un tableur ou un autre bien public référencé par la page. Le navigateur doit en savoir assez sur la ressource pour la demander ou l'afficher.
La découverte de fichier ne signifie pas exploration de serveur. GrabAll fonctionne avec la page actuelle et fournit URL, pas avec des répertoires privés ou des contenus de serveur non listés.
- Liens d'ancrage vers les documents et archives
- Attributs src, srcset et charge paresseuse
- Ãléments vidéo, audio, affiche et source
- Fichier public URL présent dans le texte de la page ou les attributs de données
Une méthode structurée pour trouver les fichiers
Analysez d'abord la page la plus pertinente. Regroupez les résultats par type, puis inspecter les extensions de fichiers, les conseils MIME, les dimensions, les tailles et les domaines sources. Utilisez les prévisualisations lorsque disponibles.
Si la page est dynamique, laissez la section pertinente se charger avant l'analyse. Ãvitez de faire défiler des zones non reliées parce que cela peut ajouter des recommandations et des ressources de navigation à l'ensemble de résultats.
- Choisissez une page spécifique
- Charger le contenu pertinent à la tâche
- Résultats de l'analyse et du groupe par type
- Filtre, prévisualiser et sélectionner les fichiers utiles
URL sans extension évidente
Certains téléchargements utilisent des itinéraires tels que /download?id=123 au lieu de noms de fichiers se terminant par .pdf ou .zip. Ces liens peuvent être plus difficiles à classifier avant que le serveur ne réponde. Les étiquettes de page, les en-têtes de réponse et le comportement de téléchargement du navigateur peuvent fournir plus d'informations.
Ne présumez pas que chaque longue URL est un fichier. Les liens de suivi, de navigation et de API peuvent être similaires.
Quand analyser la page plutôt que consulter son code source
Affichage de la source HTML peut aider les utilisateurs techniques, mais les pages modernes ajoutent souvent du contenu après le chargement initial du document. Une extension de navigateur peut inspecter le contexte rendu et présenter les résultats dans une interface orientée examen.
Pour coller HTML ou une source hors ligne, utilisez le fichier en masse gratuit URL Extractor. Pour la page en direct, utilisez GrabAll afin de combiner découverte avec prévisualisations et sélection de téléchargement.
Quels résultats attendre
Les fichiers derrière l'authentification, générés après des appels API protégés, stockés dans des systèmes privés ou livrés par DRM sont hors de portée d'un outil d'analyse de page normal. Respecter les règles d'accès et utiliser les contrôles officiels de téléchargement lorsqu'ils sont fournis.
Les meilleurs résultats proviennent de pages qui exposent délibérément des liens de ressources, des galeries, des pièces jointes, des documents ou des fichiers multimédias ordinaires.
Questions fréquentes
GrabAll peut-il trouver des fichiers qui ne sont pas liés sur la page?
Non. Il organise les ressources et les liens disponibles au navigateur; il ne recherche pas les répertoires de serveurs privés ou révèle des fichiers non exposés.
Devrais-je analyser la page d'accueil ou une page spécifique?
Utilisez la page la plus spécifique possible. Il produit moins de ressources sans rapport et des résultats plus propres.
Et si une URL n'a pas d'extension de fichier ?
Il peut encore produire un téléchargement, mais la classification est moins fiable jusqu'à ce que le serveur réponde. Consultez l'étiquette de la page et utilisez le contrôle officiel lorsqu'il est incertain.
Puis-je extraire des liens de HTML copiés à la place ?
Oui. GrabAll fournit gratuitement un fichier en masse URL Extracteur pour HTML collé, code source et texte.
GrabAll analyse la page et rassemble les images, documents, médias et autres fichiers téléchargeables dans une liste claire, afin que vous choisissiez précisément ce que vous souhaitez enregistrer.