

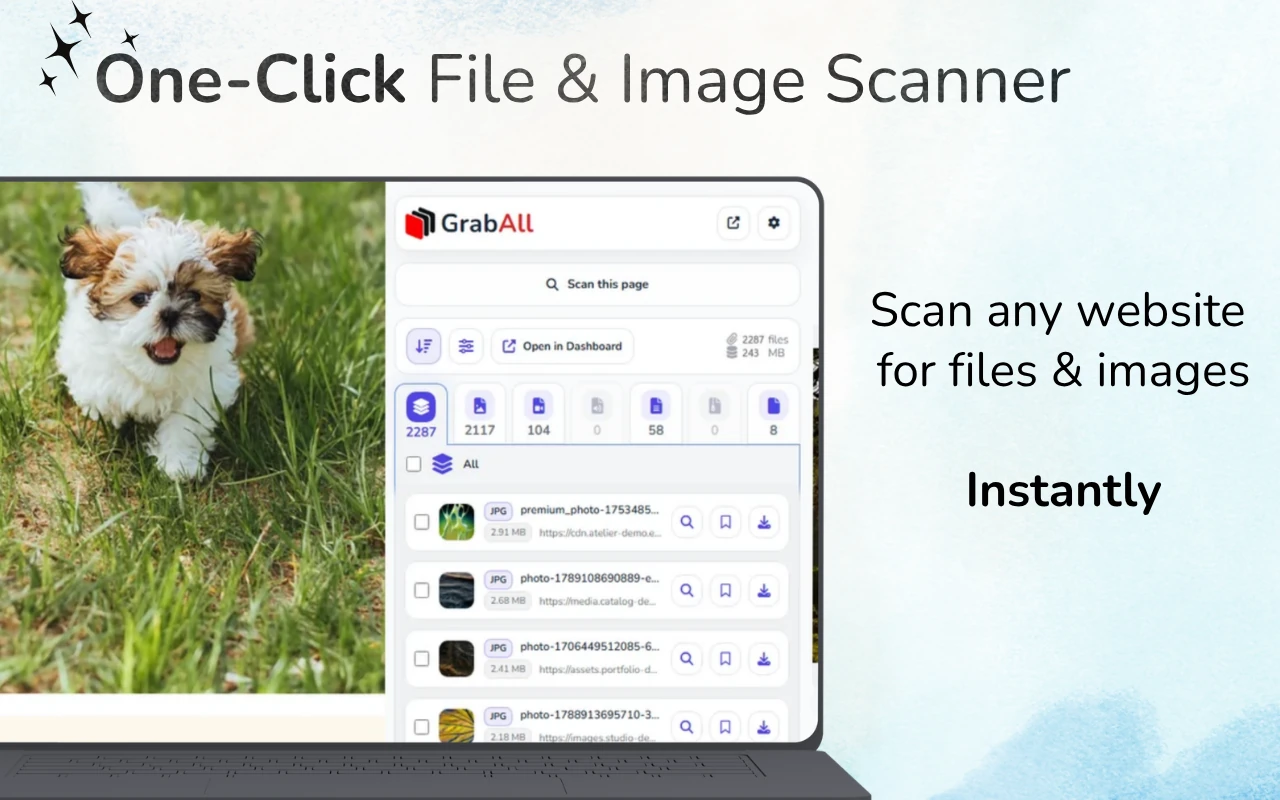
Brzi odgovor: Za aktivnu web stranicu, skenirajte je pomoću GrabAll i kopirajte otkrivene URL-ove datoteka. Za spremljeni HTML ili kopirani izvorni kod, zalijepite ga u Bulk File URL Extractor. Navedite osnovnu URL adresu kada izvor sadrži relativne veze.
Odaberi između skeniranja stranice i parsiranja zalijepljenog HTML-a
Skeniranje učitane web stranice može pronaći datoteke dostupne u pregledniku, dok online ekstraktor čita samo HTML ili tekst koji zalijepite. Odaberite metodu koja odgovara vašoj početnoj točki, a zatim pregledajte dobivene URL-ove prije korištenja za preuzimanje.
Gdje se URL-ovi datoteka pojavljuju u HTML-u
Obične poveznice koriste href, dok slike i mediji često koriste src. Odgovorne slike mogu navesti nekoliko kandidata u srcset. Biblioteke za odgođeno učitavanje često pohranjuju stvarne URL-ove u data-src, data-original ili prilagođene podatkovne atribute.
Stilske tablice i ugrađeni CSS mogu referencirati pozadine putem url(). Sirovi tekst također može sadržavati potpune URL-ove koji nisu pridruženi HTML elementu.
- poveznice href
- atributi src i poster
- kandidati srcset i data-srcset
- Vrijednosti CSS url() i neobrađeni apsolutni URL-ovi
Ispravno rješavanje relativnih putanja
Vrijednost poput ../files/report.pdf ima značenje samo u odnosu na stranicu odakle je HTML došao. Navedite originalni URL stranice kao osnovu kako bi ekstraktor mogao pretvoriti relativne putove u potpune adrese.
Poveznice relativne prema protokolu koje počinju s // obično nasljeđuju HTTPS na sigurnoj stranici. Putanje relativne prema korijenu koje počinju s / koriste trenutni početak web-mjesta.
- Zadrži izvorni URL stranice
- Koristite ga kao osnovni URL
- Normalizirati protokol-relativne i korijen-relativne putove
- Pregledajte riješene domene prije korištenja popisa
Filtriraj potencijalne URL-ove po namjeri
Nije svaki URL u izvornom kodu resurs za preuzimanje. Stranice sadrže navigacijske poveznice, API-je, analitiku, fontove, skripte, stilove i parametre praćenja. Filtrirajte prema relevantnim ekstenzijama i pregledajte dvosmislene URL-ove.
Za slike uključite moderne formate kao što su WebP i AVIF. Za dokumente, razmotrite PDF, DOCX, XLSX, CSV, PPTX i arhive prema zadatku.
Izvor HTML-a u odnosu na prikazanu stranicu
Kopirana izvornik prikazuje samo ono što ste dostavili. Može nedostajati resursa umetnutih nakon pokretanja JavaScripta, sadržaja učitanog nakon pomicanja ili URL-ova kreiranih tijekom interakcije.
Za izvore isječaka, izvezenu HTML, predloške e-pošte i pregled koda koristite offline ekstraktor. Za živo prikazanu stranicu i radne tokove u kontekstu preglednika koristite GrabAll dodatak.
Potvrdite prije preuzimanja
Uklonite duplicirane stavke s liste, pregledajte domene i testirajte mali uzorak. Podudaranje ekstenzije u URL-u ne jamči da je odgovor valjan niti da imate ovlaštenje za korištenje.
Izbjegavajte automatsko traženje velikih nepregledanih popisa. Validacija sprječava neispravne poveznice, neželjene krajnje točke za praćenje i nepotrebno opterećenje.
Često postavljana pitanja
Može li extractor riješiti ../ relativne veze?
Da, kada navedete izvorni URL stranice kao osnovnu adresu.
Uključuje li HTML ekstrakcija srcset slike?
Alat GrabAll provjerava uobičajene atribute izvora i responzivnih slika, uključujući srcset kandidate.
Zašto neke datoteke s uživo stranica nedostaju u kopiranom HTML-u?
JavaScript ih može dodati nakon početnog učitavanja HTML-a. Koristite ekstenziju live preglednika za renderirani i dinamički učitani sadržaj stranice.
Jesu li svi izdvojeni URL-ovi sigurni za preuzimanje?
Ne. Pregledajte domene, vrste datoteka, dozvole i mali uzorak prije korištenja popisa rezultata.
GrabAll skenira stranicu i okuplja slike, dokumente, medije i druge datoteke za preuzimanje u jedan jasan popis, tako da možete točno odabrati što želite spremiti.