

Gyors válasz: Egy élő weboldal esetén szkenneld a GrabAll-lal, és másold ki a talált fájl linkeket. Mentett HTML vagy másolt forráskód esetén illeszd be a Bulk File URL Extractor-be. Adj meg egy alap URL-t, ha a forrás relatív linkeket tartalmaz.
Válassz az oldal szkennelése vagy a beillesztett HTML elemzése között
Egy betöltött weboldal beolvasása után megtalálhatod a böngészőben elérhető fájlokat, míg az online kihúzó csak a beillesztett HTML-t vagy szöveget olvassa. Válaszd ki a kiindulási pontodnak megfelelő módszert, majd nézd át a letölthető URL-eket, mielőtt letöltenéd őket.
Hol jelennek meg a fájl URL-ek a HTML-ben
A sima linkek href-et használnak, míg a képek és média gyakran src-t. A reszponzív képek több jelöltet is tartalmazhatnak a srcset-ben. A lazy-loading könyvtárak gyakran tárolják a valós URL-eket data-src, data-original vagy egyéni data attribútumokban.
Stíluslapok és inline CSS hivatkozhatnak háttérekre url() segítségével. A nyers szöveg tartalmazhat teljes URL-eket is, amelyek nem kapcsolódnak HTML elemhez.
- href linkek
- src és posztolói attribútumok
- srcset és data-srcset jelöltek
- CSS url() értékek és nyers abszolút URL-ek
Relatív utak helyesen oldható fel.
Egy érték, például ../files/report.pdf, csak az oldalhoz viszonyítva értelmezhető, ahonnan az HTML származik. Adjuk meg az eredeti oldal URL-jét alapként, hogy az adatkinyerő a relatív útvonalakat teljes címekké alakíthassa.
Protokoll-relatív linkek, amelyek //-val kezdődnek, általában öröklik a HTTPS-t egy biztonságos oldalon. Gyökér-releváns útvonalak, amelyek /-val kezdődnek, az aktuális webhely eredetét használják.
- Az eredeti forrás oldal URL-jének megtartása
- Használd alap URL-ként
- Normalizáld a protokoll-relatív és gyökér-relatív útvonalakat
- Az oldallisták használata előtt ellenőrizze a feloldott domaineket
Jelölt URL-ek szűrése szándék alapján
Nem minden URL a forráskódban letölthető tartalom. Az oldalak navigációs linkeket, API-kat, elemzőket, betűtípusokat, szkripteket, stíluslapokat és követési paramétereket tartalmaznak. Szűrd a releváns kiterjesztések szerint és vizsgáld meg a kétértelmű URL-eket.
Képek esetén vegyél figyelembe modern formátumokat, mint a WebP és AVIF. Dokumentumok esetén fontold meg a PDF, DOCX, XLSX, CSV, PPTX fájlokat és archívumokat a feladat szerint.
HTML forrás a renderelt oldalhoz képest
A másolt forrás csak az Ön által megadottakat tartalmazza. Hiányozhat belőle a JavaScript futása után beillesztett erőforrás, a görgetés után betöltött tartalom, vagy a felhasználói interakció során létrehozott URL.
Használja az offline kinyerőt forráskód részletekhez, exportált HTML-hez, e-mail sablonokhoz és kódellenőrzéshez. A GrabAll kiterjesztést használja az élő renderelt oldalhoz és a böngésző-környezet folyamatokhoz.
Érvényesítse letöltés előtt
Távolítsa el a duplikátumokat a listából, vizsgálja meg a domaineket, és teszteljen egy kis mintát. Egy URL-ben található kiterjesztés egyezése nem garantálja, hogy a válasz érvényes vagy hogy jogosult annak használatára.
Kerülje a nagyméretű, ellenőrizetlen listák automatikus lekérését. Az érvényesítés megakadályozza a megszakadt linkeket, a nem kívánt követési végpontokat és a felesleges terhelést.
Gyakran ismételt kérdések
A kihúzó képes feloldani .. / relatív kapcsolatokat?
Igen, amikor a forrásoldal URL-jét adja meg alapcímként.
A HTML-kinyerés tartalmazza a srcset képeket?
A GrabAll eszköz ellenőrzi a közös forrás- és reszponzív kép attribútumokat, beleértve az srcset jelölteket is.
Miért hiányoznak egyes élő oldal fájlok a másolt HTML-ből?
A JavaScript hozzáadhatja őket az első HTML betöltés után. Használja az élő böngészőbővítményt a renderelt és dinamikusan betöltött oldal tartalmához.
Biztonságosak letöltésre az összes kinyert URL-ek?
Nem. A használat előtt ellenőrizd a domaineket, fájltípusokat, jogosultságokat és egy kis mintát az eredménylistából.
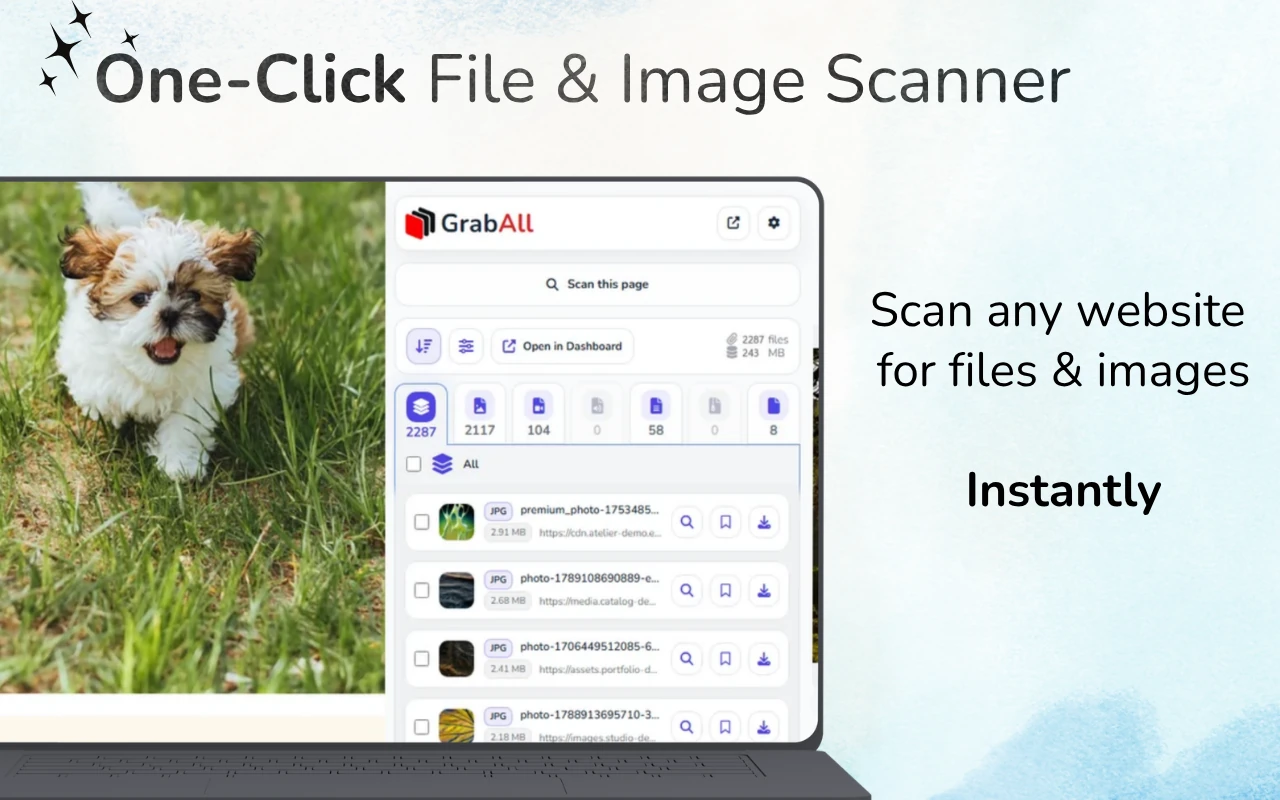
A GrabAll átvizsgálja az oldalt, és a képeket, dokumentumokat, médiákat és egyéb letölthető fájlokat egyértelmű listába rendezi, így pontosan kiválaszthatja, mit szeretne menteni.