



ã¾ãçµè«: 文書を一覧表示しているページをスキャンし、結果をPDFまたはその他の文書形式にフィルタリングして、必要なファイルを選択してダウンロードします。Mass Scanを使用すると、複数の開いているページから文書リンクを収集できます。ページURLのリストをインポートするには、Premiumが必要です。
ウェブページ上のPDF、Word、およびスプレッドシートのダウンロードを探します
ドキュメントリンクを含むリソースリスト、レポートアーカイブ、またはコースページから開始します。GrabAllは、アクセス可能なPDF、DOCX、XLSX、CSVなどのファイルURLを1つのリストにまとめて収集できます。複数の文書を保存する前に、ファイル名とソースリンクを確認してください。
ããã¥ã¡ã³ããªã³ã¯ã¯é常表示ãããå ´æ
PDFã¨ãªãã£ã¹ã®ææ¸ã¯ããªã½ã¼ã¹ãªã¹ãããã¼ãã«ããã¦ã³ãã¼ããã¿ã³ãã«ã¼ããããããã¼ããã¢ã¼ã«ã¤ããã¼ã¸ããä¸è¬çã«ãªã³ã¯ããã¦ãã¾ããä¸é¨ã®ãã¼ã¸ã§ã¯ãä¸è¬çãªãã¿ã³ã ããå ¬éããªãããè¨è¿°çãªã¢ã³ã«ã¼ããã¹ãã使ç¨ãã¾ãã
GrabAllã¯ãã¡ã¤ã«ãªã³ã¯ã1ã¤ã®ã¬ãã¥ã¼è¡¨é¢ã«ã¾ã¨ãã¦ãã¾ããããã«ãããåããã¥ã¡ã³ããå¥ã®ã¿ãã§éãããããååã¨å½¢å¼ãç°¡åã«æ¯è¼ã§ãã¾ãã
- PDFã¬ãã¼ãã¨ããã¥ã¢ã«
- DOCXãODTãRTFææ¸
- XLSXã¹ãã¬ããã·ã¼ãã¨CSVãã¼ã¿
- PPTXãã¬ã¼ã³ãã¼ã·ã§ã³ã¨ZIPã¢ã¼ã«ã¤ã
ã¯ãªã¼ã³ãªããã¥ã¡ã³ãåéã¯ã¼ã¯ããã¼
å¿ è¦ãªææ¸ãå«ãæãçããã¼ã¸ãéãã¾ããã¹ãã£ã³ãã¦ãããã¥ã¡ã³ãå½¢å¼ã«ãã£ã«ã¿ãªã³ã°ããé¢é£ãããã¡ã¤ã«åãä¸ç·ã«ä¿æãããããã«ãªã¹ããã½ã¼ããã¾ãã
PDFããã¬ãã¥ã¼ãã¦ããã¦ã³ãã¼ãåã«ãã¡ã¤ã«åã調ã¹ã¾ããååãä¸è¬çãªå ´åã¯ããªã³ã¯ããã¹ãã¾ãã¯ã½ã¼ã¹ãã¼ã¸ã®å¥ã®ã¬ã³ã¼ããä¿æãã¦ããã¡ã¤ã«ãå¾ã§ç解ã§ããããã«ãã¾ãã
- ãªã½ã¼ã¹ã¾ãã¯ã¢ã¼ã«ã¤ããã¼ã¸ãã¹ãã£ã³ãã
- PDFããã³ææ¸ã®å»¶é·ã«ãã£ã«ã¿ã¼ãããã¦ä¸ãã
- ãã¡ã¤ã«åãéè¤ããã¡ã¤ã«ãµã¤ãºã®ã¬ãã¥ã¼
- é¸æããããããå°ç¨ã®ããã¸ã§ã¯ããã©ã«ãã«ãã¦ã³ãã¼ã
åãè¾¼ã¾ããPDFã®è¦è´è ã¯ç´æ¥ãªã³ã¯ã¨ç°ãªã£ã¦ãã¾ã
ãã©ã¦ã¶PDFãã¥ã¼ã¢ã¯ãå ¬éPDF URLã表示ãããã¨ãã§ãã¾ãããä¸é¨ã®ã¦ã§ããµã¤ããã¥ã¼ã¢ã¯ãã¹ã¯ãªãããä¸æçãªãã¼ã¯ã³ãã¾ãã¯èªè¨¼ãããAPIãä»ãã¦ãã¼ã¸ããã¼ããã¾ãããã®å ´åãå¯è¦ãã¥ã¼ã¢ã¯ãæ°¸ç¶çãªå ¬éãã¡ã¤ã«ãªã³ã¯ãåå¨ããã¨ãã証æ ã§ã¯ããã¾ããã
éè¤ãå¤ãææ¸ãé²æ¢
ã¢ã¼ã«ã¤ãã¯ãããã¤ãã®ããã²ã¼ã·ã§ã³ã¨ãªã¢ããå¤æ´ãããã¨ãã£ã·ã§ã³ãè¨èªã® variantãä»é²ãããã³éè¤ãªã³ã¯ããªã¹ããããã¨ãã§ãã¾ãããã¡ã¤ã«åãæ¥ä»ããã¡ã¤ã«ãµã¤ãºãããã³è¿ãã®ãã¼ã¸ã©ãã«ãå ¨ã¦ä¿åããåã«æ¯è¼ãã¾ãã
URLã®ãã¼ã¸ã¨ã¢ã¯ã»ã¹æ¥æãè¨é²ãã¾ããURL ãå¤æ´ããã¦ããªãå ´åã§ããReport-final.pdf ã¨ããååã®ãã¡ã¤ã«ãå¾ã§ç½®ãæãããã¾ãã
ãã¦ã³ãã¼ãããã»ãããæ´çãã
ç·¨éãããã³ãã¼ããã½ã¼ã¹ãã¡ã¤ã«ãåé¢ãã¾ããããã¸ã§ã¯ããå¹´ãããã¥ã¡ã³ãã¿ã¤ããã¾ãã¯ãããªãã·ã£ã¼ç¨ã®ãã©ã«ãã使ç¨ãã¦ãå ã®ååãã©ããã«ä¿åããã¾ã§ãã¡ã¤ã«ãååãå¤æ´ããªãã§ãã ããã
ãããã質å
GrabAllã¯1ãã¼ã¸ããè¤æ°ã®PDFããã¦ã³ãã¼ãã§ãã¾ãã?
ã¯ãããã¼ã¸ãã¢ã¯ã»ã¹å¯è½ãªPDFãªã³ã¯ãå ¬éããå ´åãPDFçµæã«ã¹ãã£ã³ããã£ã«ã¿ãªã³ã°ããé¢é£ãããã¡ã¤ã«ãé¸æãããããããã¦ã³ãã¼ããã¾ãã
ãªãåãè¾¼ã¾ããææ¸ãæ¬ è½ãã¦ãã¾ãã?
ãã¥ã¼ã¢ã¼ã¯ãç´æ¥å ¬éãã¡ã¤ã«URLã®ä»£ããã«ãä¸æçãèªè¨¼ãã¹ã¯ãªããåããããã¾ãã¯ã»ã°ã¡ã³ãåãããé éæ¹æ³ã使ç¨ããå ´åãããã¾ãã
ã¹ãã¬ããã·ã¼ãããã¬ã¼ã³ãã¼ã·ã§ã³ã®åéã¯å¯è½ã§ãã?
ã¯ããGrabAllã¯ãä¸è¬çãªææ¸ãã¹ãã¬ããã·ã¼ãããã¬ã¼ã³ãã¼ã·ã§ã³ãCSVãããã³ãã©ã¦ã¶ã«å©ç¨å¯è½ãªã¢ã¼ã«ã¤ããªã³ã¯ãæ´çãããã¨ãã§ãã¾ãã
éè¤ããã¬ãã¼ããå¦çããæ¹æ³ã¯?
ãã¡ã¤ã«åãã©ãã«ãæ¥ä»ãURLããã¡ã¤ã«ãµã¤ãºãæ¯è¼ããããªãã®ä½åã«é¢é£ããã¨ãã£ã·ã§ã³ãç¶æãã¾ãã
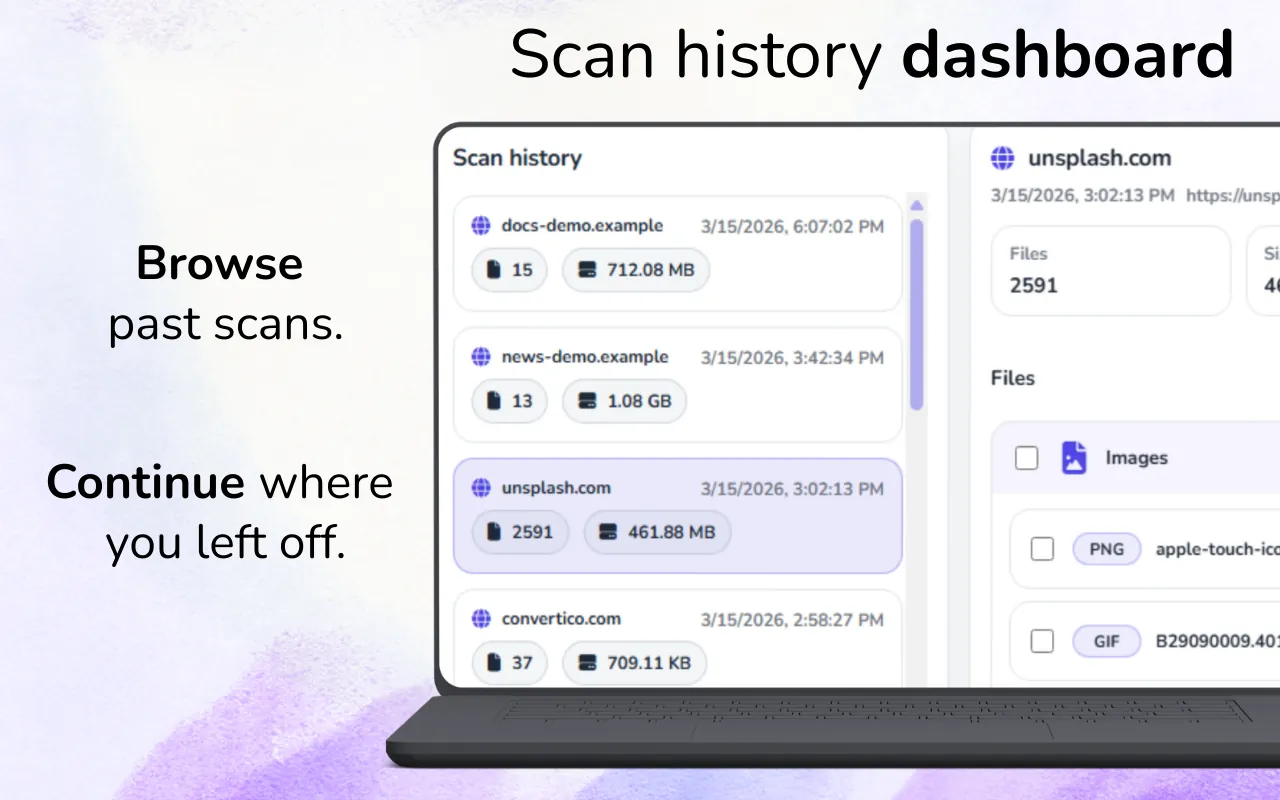
GrabAll はページをスキャンし、画像、ドキュメント、メディア、その他のダウンロード可能なファイルを見やすい一覧にまとめます。保存したいものだけを簡単に選べます。