
ã¾ãçµè«: スキャンしたいページのURLを準備し、それをGrabAll PremiumにインポートしてMass Scanを実行します。これらのページで見つかったファイルリンクを確認し、結果をフィルタリングして選択したものをダウンロードします。提供されたリストは、どのページをスキャンするかを制御します。
バッチスキャン用のページURLのリストを使用します
ページURLはスキャンするウェブページを指し、直接ファイルのURLはファイル自体を指します。必要なリソースを含むページを中心にリストを準備してください。GrabAllはドメイン上のすべてのページを自動で検出しないため、関連するページを明示的に含める必要があります。
ããããªURLãªã¹ãããå§ãã
空ç½è¡ãéè¤ããã©ã°ã¡ã³ãããã©ããã³ã°ãã©ã¡ã¼ã¿ãããã³æãããªããã²ã¼ã·ã§ã³URLãåé¤ãã¾ããURL ã1è¡ãããHTTPS ã¢ãã¬ã¹ã使ããããã«ãã¾ãã
GrabAllã®ç¡æURLãªã¹ãã¯ãªã¼ãã¼ã¯ããã大ããªã¯ã¼ã¯ããã¼ã§ä½¿ç¨ãããåã«ãéå»ã®ãªã¹ããè¤è£½ããã³ã½ã¼ãã§ãã¾ãã
- ã©ã¤ã³ãã¨ã®1ã¤ã®å®å ¨ãªURL
- éè¤ã¾ãã¯é¢é£ãããã¼ã¸ããªã
- ä¸è²«æ§ã®ãããããã³ã«ã¨ãã¡ã¤ã³å½¢å¼
大è¦æ¨¡ãªããã¸ã§ã¯ããè«ççãªãããã«åå²
ã¦ã§ããµã¤ããã«ãã´ãªãã¯ã©ã¤ã¢ã³ããæ¥ä»ãã¾ãã¯è³ç£ã¿ã¤ãã«ããã°ã«ã¼ãURLãé¢é£ãããã¼ã¸ã®ãããã¯ãå¤ãã®é¢é£ã®ãªãã½ã¼ã¹ãã1ã¤ã®æ··åãªã¹ãããããã£ã«ã¿ãªã³ã°ãããããªãçµæãçã¿åºãã¾ãã
æ³å®ãããã¡ã¤ã«ãå ¬éãããã¼ã¸ã確èªããããã®å°ããªãµã³ãã«ããå§ã¾ãã¾ãããµã³ãã«ãæç¨ãªçµæãçæããå¾ã«ã®ã¿ããããã縮å°ãã¾ãã
- å°ãã代表çãªãµã³ãã«ããã¹ããã¦ä¸ãã
- åãã°ã«ã¼ã URL ä¸ç·ã«
- å®ç¨çãªããããµã¤ãºãè¨å®ãã
- 失æããã¬ã³ã¼ãããã¼ã¸ãå¥ã ã«ãªãã¤ã¬ã¯ã
ãªãã¤ã¬ã¯ããã¨ã©ã¼ãåçãã¼ã¸ã¸ã®å¯¾å¿
ä¸é¨ã®URLãªãã¤ã¬ã¯ã, èªè¨¼ãå¿ è¦ã¨ãã, ã¨ã©ã¼ãè¿ã, ã¾ãã¯ã¤ã³ã¿ã©ã¯ã·ã§ã³å¾ã«éè¦ãªã³ã³ãã³ãããã¼ã. ãªã¹ãå ¨ä½ãç¹°ãè¿ãã¹ãã£ã³ããã®ã§ã¯ãªãä¾å¤ã¨ãã¦æ±ãã¾ãã
ããã¥ã¢ã«ã»ãã·ã§ã³ããã¸ã¥ã¢ã«ç¢ºèªãå¿ è¦ãªå ´åã¯ãéãã¦ããã¿ãã¯ã¼ã¯ããã¼ã«ç§»åãã¾ããã¤ã³ãã¼ããããã¹ãã£ã³ã¯ãå®å®ããç´æ¥ã¢ã¯ã»ã¹å¯è½ãªãã¼ã¸ã§æå¼·ã§ãã
è¤æ°ã®ãã¼ã¸ããéãããã¡ã¤ã«ã確èªãã
çµåãããçµæã¯ãè¤æ°ã®ãã¼ã¸ãããªã³ã¯ãããå ±æãã´ãç¹°ãè¿ãã®ãã¦ã³ãã¼ãããµã ãã¤ã«ãããã³åãææ¸ãå«ããã¨ãã§ãã¾ããåã¨ãµã¤ãºã§ãã£ã«ã¿ãªã³ã°ããURLã¨è¡¨ç¤ºãããã¡ã¿ãã¼ã¿ã§éè¤ãã¾ãã
å ¥åãªã¹ãã®ã³ãã¼ãä¿åãããã¦ã³ãã¼ãããåã«ãªã³ã¯ãã¨ã¯ã¹ãã¼ããã¾ããããããå¾ã§ãã§ãã¯ããå¿ è¦ãããå ´åã¯ãç¹°ãè¿ãã¬ã³ã¼ããä½æãã¾ãã
èªååãããããããèæ ®ãã¦
大è¦æ¨¡ãªã¹ãã£ã³ã«ãããã¦ã§ããµã¤ãã¸ã®ãªã¯ã¨ã¹ããä½æããã¾ããããããåççã«ä¿ã¡ãä¸å¿ è¦ãªç¹°ãè¿ããé¿ãããµã¤ããã¬ã¼ãå¶éã示ãããå¥ã®ã¢ã¯ã»ã¹æ¹æ³ã使ç¨ããããã«ä¾é ¼ããå ´åãåæ¢ãã¾ãã
ãããã質å
ã¤ã³ãã¼ãããURLãªã¹ããå½¢å¼ããã«ã¯ã©ãããã°ããã§ãã?
1 è¡ã«ã¤ã 1 ã¤ã®å®å ¨ãª HTTP ã HTTPS URL ã使ç¨ãã¦ä¸ãããéè¤ãåé¤ãããªã¹ãã 1 ã¤ã®ã¿ã¹ã¯ã«é¢é£ãããã¼ã¸ã§éä¸ããä¿ã¡ã¾ãã
å°ããªãµã³ãã«ãæåã«ãã¹ãããã®ã¯ãªãã§ãã?
ãµã³ãã«ã¯ããã¼ã¸ã¿ã¤ããæç¨ãªãã¡ã¤ã«ãé²åºãããã大ããªããããå¦çããåã«ãã£ã«ã¿ãé¸æããã®ã«å½¹ç«ã¡ã¾ãã
ããåããå¿ è¦ãªãã¼ã¸ã§ã¯ã©ãããã°ããã§ãã?
ã¹ãã£ã³ããåã«æåã§ã³ã³ãã³ãããã¼ããã¦ç¢ºèªã§ããéãã¦ããã¿ãã¯ã¼ã¯ããã¼ã«ç§»åãã¾ãã
URLã¹ãã£ã³ã¯èªè¨¼ããã¤ãã¹ãã¾ãã?
ãããã許å¯ããããã©ã¦ã¶ã¯ã¼ã¯ããã¼ã§å©ç¨ã§ãããã¼ã¸ããã¡ã¤ã«ã®ã¿ã§åä½ãã¾ãã
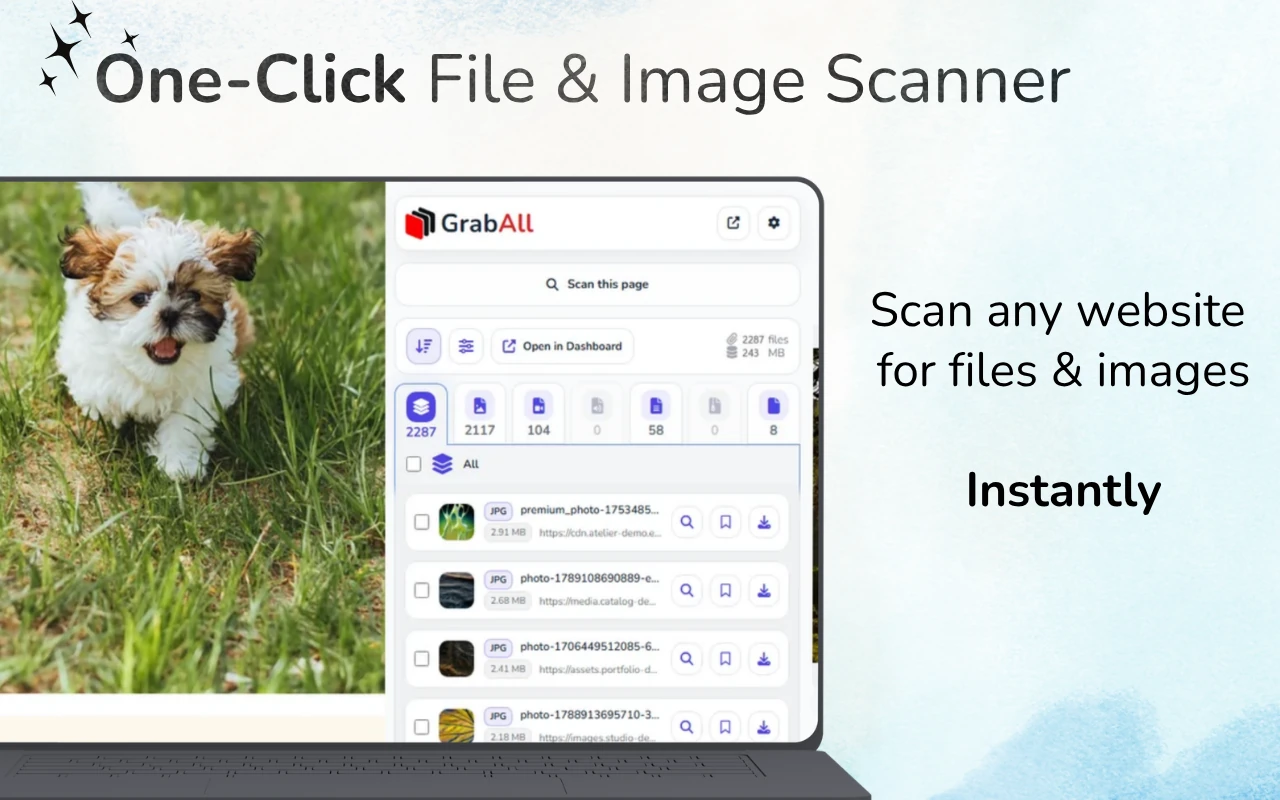
GrabAll はページをスキャンし、画像、ドキュメント、メディア、その他のダウンロード可能なファイルを見やすい一覧にまとめます。保存したいものだけを簡単に選べます。