
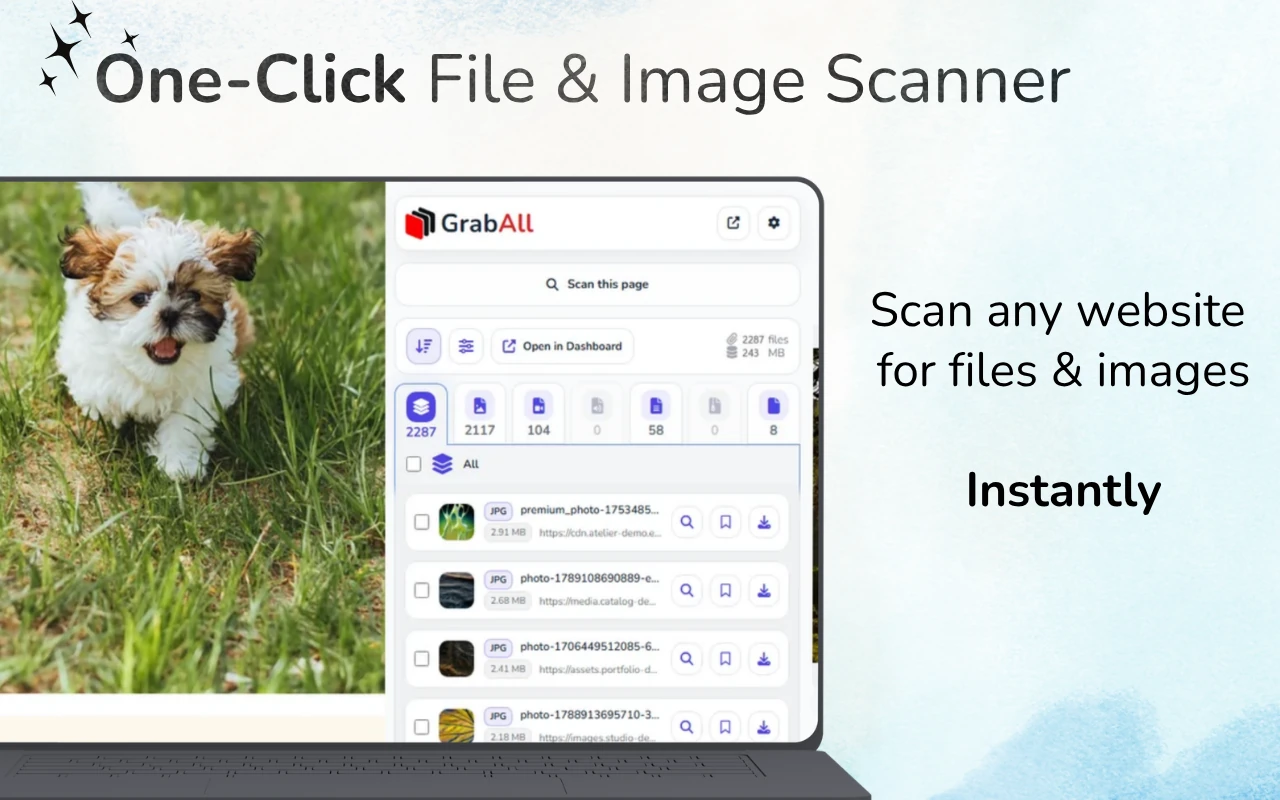
ತ್ವರಿತ ಉತ್ತರ: ಜೈವ ವೆಬ್ಪೇಜ್ಗಾಗಿ, GrabAll ಬಳಸಿ ಸ್ಕ್ಯಾನ್ ಮಾಡಿ ಮತ್ತು ಪತ್ತೆಯಾಗಿರುವ ಫೈಲ್ ಲಿಂಕ್ಗಳನ್ನು ಕಾಪಿ ಮಾಡಿ. ಉಳಿಸಿರುವ HTML ಅಥವಾ ನಕಲಾದ ಮೂಲ ಕೋಡ್ಗಾಗಿ, ಅದನ್ನು ಬ್ಯಾಚ್ ಫೈಲ್ URL ಎಕ್ಸ್ಟ್ರಾಕ್ಟರ್ಗೆ ಪೇಸ್ಟ್ ಮಾಡಿ. ಮೂಲದಲ್ಲಿ ಅಸಂಬಂಧಿತ ಲಿಂಕ್ಗಳಿದ್ದರೆ ಮೂಲ URL ಒದಗಿಸಿ.
ಪುಟವನ್ನು ಸ್ಕ್ಯಾನ್ ಮಾಡುವುದು ಮತ್ತು ಅಂಟಿಸಲಾದ HTML ಅನ್ನು ಪಾರ್ಸ್ ಮಾಡುವುದರ ನಡುವೆ ಆಯ್ಕೆಮಾಡಿ
ಲೋಡ್ ಮಾಡಿದ ವೆಬ್ ಪುಟವನ್ನು ಸ್ಕ್ಯಾನ್ ಮಾಡುವುದರಿಂದ ಬ್ರೌಸರ್ ನಲ್ಲಿ ಲಭ್ಯವಿರುವ ಫೈಲ್ ಗಳನ್ನು ಹುಡುಕಬಹುದು, ಆದರೆ ಆನ್ ಲೈನ್ ಎಕ್ಸ್ ಟ್ರಾಕ್ಟರ್ ನೀವು ಅಂಟಿಸಿದ HTML ಅಥವಾ ಪಠ್ಯವನ್ನು ಮಾತ್ರ ಓದುತ್ತದೆ. ನಿಮ್ಮ ಆರಂಭಿಕ ಹಂತಕ್ಕೆ ಹೊಂದಿಕೆಯಾಗುವ ವಿಧಾನವನ್ನು ಆರಿಸಿ, ನಂತರ ಡೌನ್ ಲೋಡ್ ಗಳಿಗಾಗಿ ಅವುಗಳನ್ನು ಬಳಸುವ ಮೊದಲು ಪರಿಣಾಮವಾಗಿ URL ಗಳನ್ನು ಪರಿಶೀಲಿಸಿ.
HTML ನಲ್ಲಿ ಫೈಲ್ URLಗಳು ಎಲ್ಲಿ ಕಾಣಿಸುತ್ತವೆ
ಸಾಮಾನ್ಯ ಲಿಂಕ್ ಗಳು ಎಚ್ ಆರ್ ಎಫ್ ಅನ್ನು ಬಳಸುತ್ತವೆ, ಆದರೆ ಚಿತ್ರಗಳು ಮತ್ತು ಮಾಧ್ಯಮಗಳು ಸಾಮಾನ್ಯವಾಗಿ ಎಸ್ ಆರ್ ಸಿಯನ್ನು ಬಳಸುತ್ತವೆ. ಸ್ಪಂದಿಸುವ ಚಿತ್ರಗಳು ಎಸ್ ಆರ್ ಸಿಸೆಟ್ ನಲ್ಲಿ ಹಲವಾರು ಅಭ್ಯರ್ಥಿಗಳನ್ನು ಪಟ್ಟಿ ಮಾಡಬಹುದು. ಸೋಮಾರಿ-ಲೋಡಿಂಗ್ ಗ್ರಂಥಾಲಯಗಳು ಸಾಮಾನ್ಯವಾಗಿ ಡೇಟಾ-ಎಸ್ ಆರ್ ಸಿ, ಡೇಟಾ-ಒರಿಜಿನಲ್ ಅಥವಾ ಕಸ್ಟಮ್ ಡೇಟಾ ಗುಣಲಕ್ಷಣಗಳಲ್ಲಿ ನಿಜವಾದ ಯುಆರ್ ಎಲ್ ಗಳನ್ನು ಸಂಗ್ರಹಿಸುತ್ತವೆ.
ಸ್ಟೈಲ್ ಶೀಟ್ ಗಳು ಮತ್ತು ಇನ್ ಲೈನ್ ಸಿಎಸ್ ಎಸ್ ಯುಆರ್ ಎಲ್ () ಮೂಲಕ ಹಿನ್ನೆಲೆಗಳನ್ನು ಉಲ್ಲೇಖಿಸಬಹುದು. ಕಚ್ಚಾ ಪಠ್ಯವು ಎಚ್ ಟಿಎಂಎಲ್ ಅಂಶಕ್ಕೆ ಲಗತ್ತಿಸದ ಸಂಪೂರ್ಣ ಯುಆರ್ ಎಲ್ ಗಳನ್ನು ಸಹ ಹೊಂದಿರಬಹುದು.
- href ಲಿಂಕ್ಗಳು
- src ಮತ್ತು ಪೋಸ್ಟರ್ ಗುಣಲಕ್ಷಣಗಳು
- srcset ಮತ್ತು ಡೇಟಾ-srcset ಅಭ್ಯರ್ಥಿಗಳು
- CSS url() ಮೌಲ್ಯಗಳು ಮತ್ತು ಕಚ್ಚಾ ಸಂಪೂರ್ಣ URL ಗಳು
ಸಾಪೇಕ್ಷ ಮಾರ್ಗಗಳನ್ನು ಸರಿಯಾಗಿ ಪರಿಹರಿಸಿ
ಎಂಬಂತಹ ಮೌಲ್ಯ .. /files/report.pdf HTML ಬಂದ ಪುಟಕ್ಕೆ ಸಂಬಂಧಿಸಿದಂತೆ ಮಾತ್ರ ಅರ್ಥಪೂರ್ಣವಾಗಿದೆ. ಮೂಲ ಪುಟದ URL ಅನ್ನು ಮೂಲವಾಗಿ ಒದಗಿಸಿ ಆದ್ದರಿಂದ ಎಕ್ಸ್ಟ್ರಾಕ್ಟರ್ ಸಾಪೇಕ್ಷ ಮಾರ್ಗಗಳನ್ನು ಸಂಪೂರ್ಣ ವಿಳಾಸಗಳಾಗಿ ಪರಿವರ್ತಿಸಬಹುದು.
// ಮೂಲಕ ಪ್ರಾರಂಭವಾಗುವ ಪ್ರೋಟೋಕಾಲ್-Relative ಲಿಂಕ್ಸ್ ಸಾಮಾನ್ಯವಾಗಿ ಸುರಕ್ಷಿತ ಪುಟದಲ್ಲಿ HTTPS ಅನ್ನು ಪರಂಪರಾ ಮಾಡುತ್ತವೆ. / ಮೂಲಕ ಪ್ರಾರಂಭವಾಗುವ ರೂಟ್-Relative ಮಾರ್ಗಗಳು ಪ್ರಸ್ತುತ ವೆಬ್ಸೈಟ್ ಅಸ್ತಿತ್ವವನ್ನು ಬಳಸುತ್ತವೆ.
- ಮೂಲ ಪುಟ URL ಅನ್ನು ಪಟ್ಟಿ ಮಾಡಿ
- ಇದನ್ನು ಮೂಲ URL ಆಗಿ ಬಳಸಿ
- ಪ್ರೋಟೋಕಾಲ್-ಸಾಪೇಕ್ಷ ಮತ್ತು ರೂಟ್-ಸಾಪೇಕ್ಷ ಮಾರ್ಗಗಳನ್ನು ಸಮಾನಗೊಳಿಸಿ
- ಪಟ್ಟಿಯನ್ನು ಬಳಸುವ ಮೊದಲು ಪರಿಹರಿಸಿದ ಡೊಮೇನ್ ಗಳನ್ನು ಪರಿಶೀಲಿಸಿ
ಉದ್ದೇಶದ ಮೂಲಕ ಅಭ್ಯರ್ಥಿ URL ಗಳನ್ನು ಫಿಲ್ಟರ್ ಮಾಡಿ
ಸೋರ್ಸ್ ಕೋಡ್ನ ಪ್ರತಿ URL ಡೌನ್ಲೋಡ್ ಮಾಡಬಹುದಾದ ಆಸ್ತಿ ಅಲ್ಲ. ಪುಟಗಳಲ್ಲಿ ನ್ಯಾವಿಗೇಶನ್ ಲಿಂಕ್ಗಳು, APIಗಳು, ಅನ್ಲಿಸ್ಟಿಕ್ಸ್, ಫಾಂಟ್ಗಳು, ಸ್ಕ್ರಿಪ್ಟ್ಗಳು, ಶೈಲಿಪತ್ರಗಳು, ಮತ್ತು ಟ್ರ್ಯಾಕಿಂಗ್ ಪರಿಮಾಣಗಳಿರುತ್ತವೆ. ಸಂಬಂಧಿಸಿದ ವಿಸ್ತರಣೆಗಳ ಮೂಲಕ ಫಿಲ್ಟರ್ ಮಾಡಿ ಮತ್ತು ಅಸ್ಪಷ್ಟ URLಗಳ ಪರಿಶೀಲನೆ ಮಾಡಿ.
ಚಿತ್ರಗಳಿಗಾಗಿ, WebP ಮತ್ತು AVIF ನಂತಹ ಆಧುನಿಕ ಸ್ವರೂಪಗಳನ್ನು ಸೇರಿಸಿ. ದಾಖಲೆಗಳಿಗಾಗಿ, ಕಾರ್ಯಕ್ಕೆ ಅನುಗುಣವಾಗಿ PDF, DOCX, XLSX, CSV, PPTX ಮತ್ತು ಆರ್ಕೈವ್ ಗಳನ್ನು ಪರಿಗಣಿಸಿ.
HTML ಮೂಲ ಮತ್ತು ರೆಂಡರ್ ಮಾಡಿದ ಪುಟ
ನಕಲಿಸಿದ ಮೂಲವು ನೀವು ಒದಗಿಸಿದ್ದನ್ನು ಮಾತ್ರ ಪ್ರತಿನಿಧಿಸುತ್ತದೆ. ಜಾವಾಸ್ಕ್ರಿಪ್ಟ್ ಚಲಾಯಿಸಿದ ನಂತರ ಸೇರಿಸಲಾದ ಸಂಪನ್ಮೂಲಗಳು, ಸ್ಕ್ರೋಲಿಂಗ್ ನಂತರ ಲೋಡ್ ಮಾಡಿದ ವಿಷಯ ಅಥವಾ ಸಂವಹನದ ಸಮಯದಲ್ಲಿ ರಚಿಸಲಾದ URL ಗಳನ್ನು ಇದು ಕಳೆದುಕೊಳ್ಳಬಹುದು.
ಮೂಲ ಸ್ನಿಪ್ಪೆ, ರಫ್ತು ಮಾಡಲಾದ HTML, ಇಮೇಲ್ ಟೆಂಪ್ಲೇಟುಗಳು ಮತ್ತು ಕೋಡ್ ವಿಮರ್ಶೆಗೆ ಆಫ್ಲೈನ್ ಎಕ್ಸ್ಟ್ರಾಕ್ಟರ್ ಬಳಸಿ. ಲೈವ್ ರೆಂಡರಿಂಗ್ ಪುಟ ಮತ್ತು ಬ್ರೌಸರ್-ಕಾಂಟೆಕ್ಸ್ಟ್ ವರ್ಕ್ಫ್ಲೋಗಳಿಗಾಗಿ GrabAll ವಿಸ್ತರಣೆ ಬಳಸಿ.
ಡೌನ್ಲೋಡ್ ಮಾಡುವ ಮೊದಲು ಮೌಲ್ಯೀಕರಿಸಿ
ಪಟ್ಟಿಯನ್ನು ಡಿಡುಪ್ಲಿಕೇಟ್ ಮಾಡಿ, ಡೊಮೇನ್ ಗಳನ್ನು ಪರಿಶೀಲಿಸಿ ಮತ್ತು ಸಣ್ಣ ಮಾದರಿಯನ್ನು ಪರೀಕ್ಷಿಸಿ. URL ನಲ್ಲಿನ ಹೊಂದಾಣಿಕೆಯ ವಿಸ್ತರಣೆಯು ಪ್ರತಿಕ್ರಿಯೆಯು ಮಾನ್ಯವಾಗಿದೆ ಅಥವಾ ಅದನ್ನು ಬಳಸಲು ನಿಮಗೆ ಅಧಿಕಾರವಿದೆ ಎಂದು ಖಾತರಿಪಡಿಸುವುದಿಲ್ಲ.
ದೊಡ್ಡ ಪರಿಶೀಲಿಸದ ಪಟ್ಟಿಗಳನ್ನು ಸ್ವಯಂಚಾಲಿತವಾಗಿ ವಿನಂತಿಸುವುದನ್ನು ತಪ್ಪಿಸಿ. ಮೌಲ್ಯೀಕರಣವು ಮುರಿದ ಲಿಂಕ್ಗಳು, ಅನಗತ್ಯ ಟ್ರ್ಯಾಕಿಂಗ್ ಎಂಡ್ ಪಾಯಿಂಟ್ ಗಳು ಮತ್ತು ಅನಗತ್ಯ ಹೊರೆಯನ್ನು ತಡೆಯುತ್ತದೆ.
ಆಗಾಗ್ಗೆ ಕೇಳಲಾಗುವ ಪ್ರಶ್ನೆಗಳು
ಎಕ್ಸ್ಟ್ರಾಕ್ಟರ್ ಪರಿಹರಿಸಬಹುದೇ .. / ಸಾಪೇಕ್ಷ ಲಿಂಕ್ಗಳು?
ಹೌದು, ನೀವು ಮೂಲ ಪುಟದ URL ಅನ್ನು ಮೂಲ ವಿಳಾಸವಾಗಿ ಒದಗಿಸಿದಾಗ.
HTML ಹೊರತೆಗೆಯುವಿಕೆಯು srcset ಚಿತ್ರಗಳನ್ನು ಒಳಗೊಂಡಿದೆಯೇ?
GrabAll ಸಾಧನೆಯು ಸಾಮಾನ್ಯ ಮೂಲ ಮತ್ತು ಪ್ರತಿಕ್ರಿಯಾಶೀಲ-ಚಿತ್ರ ಗುಣಲಕ್ಷಣಗಳನ್ನು ಪರಿಶೀಲಿಸುತ್ತದೆ, srcset ಅಭ್ಯರ್ಥಿಗಳನ್ನು ಸೇರಿ.
ಕ್ಲೋನ್ ಮಾಡಿದ HTML ನಲ್ಲಿ ಕೆಲವು ಲೈವ್ ಪುಟದ ಫೈಲ್ಗಳು ಇಲ್ಲದೇ ಇರುವ ಕಾರಣ ಏನು?
ಆರಂಭಿಕ HTML ಲೋಡ್ ಆದ ನಂತರ JavaScript ಅವುಗಳನ್ನು ಸೇರಿಸಬಹುದು. ಲೈವ್ ಬ್ರೌಸರ್ ವಿಸ್ತರಣೆಯನ್ನು ಹೂಡಿಕೆಯಾಗಿರುವ ಮತ್ತು ಡೈನಾಮಿಕ್ ಲೋಡ್ ಪುಟ ವಿಷಯಕ್ಕಾಗಿ ಬಳಸಿ.
ಎಲ್ಲಾ ಹೊರತೆಗೆದ URL ಗಳು ಡೌನ್ ಲೋಡ್ ಮಾಡಲು ಸುರಕ್ಷಿತವೇ?
ಇಲ್ಲ. ಫಲಿತಾಂಶ ಪಟ್ಟಿಯನ್ನು ಬಳಸುವ ಮುನ್ನ ಡೊಮೇನ್ಗಳು, ಫೈಲ್ ಪ್ರಕಾರಗಳು, ಅನುಮತಿಗಳು, ಮತ್ತು ಒಂದು ಸಣ್ಣ ಮಾದರಿಯನ್ನು ಪರಿಶೀಲಿಸಿ.
GrabAll ಸ್ಕ್ಯಾನ್ ಮಾಡುತ್ತದೆ ಮತ್ತು ಚಿತ್ರಗಳು, ದಾಖಲೆಗಳು, ಮಾಧ್ಯಮ ಮತ್ತು ಇತರ ಡೌನ್ ಲೋಡ್ ಮಾಡಬಹುದಾದ ಫೈಲ್ ಗಳನ್ನು ಒಂದು ಸ್ಪಷ್ಟ ಪಟ್ಟಿಗೆ ತರುತ್ತದೆ, ಆದ್ದರಿಂದ ನೀವು ನಿಖರವಾಗಿ ಏನನ್ನು ಉಳಿಸಬೇಕೆಂದು ಆಯ್ಕೆ ಮಾಡಬಹುದು.