



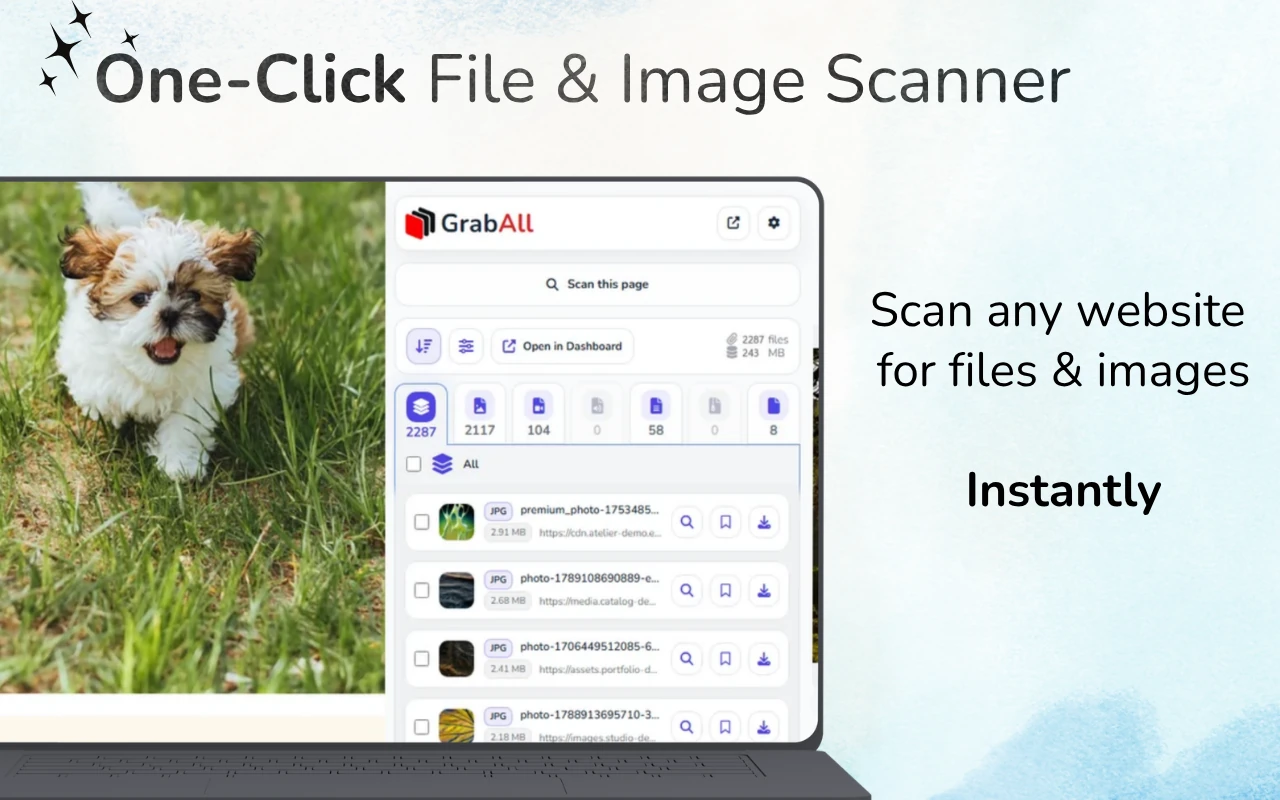
ഷീഘ്ര ഉപാധി: വെബ്പേജ് തുറക്കുക, ബന്ധപ്പെട്ട ഉള്ളടക്കം ലോഡ് ചെയ്യുക, തുടർന്ന് GrabAll ഉപയോഗിച്ച് സ്കാൻ ചെയ്യുക. കണ്ടെത്തിയ ഫയലുകൾ തരം അല്ലെങ്കിൽ വലിപ്പം പ്രകാരം ഫിൽട്ടർ ചെയ്ത ശേഷം, പ്രിവ്യൂകളും ഫയൽനാമങ്ങളും പരിശോധിച്ച്, തിരഞ്ഞെടുക്കപ്പെട്ട ലിങ്കുകൾ സേവ് ചെയ്യുക അല്ലെങ്കിൽ കോപ്പി ചെയ്യുക. ചില വിഭവങ്ങൾ പേജുമായി ഇവന്റുകൾ നടത്തി മാത്രമേ പ്രത്യക്ഷപ്പെടൂ.
ലോഡ് ചെയ്ത പേജിൽ ഫയൽ ലിങ്കുകൾ തിരയുക
ഡൗൺലോഡ് ബട്ടണുകൾ, ഡോക്യുമെന്റ് ലിസ്റ്റുകൾ, ഇമേജ് കാർഡുകൾ, മീഡിയ ഘടകങ്ങൾ എന്നിവയെല്ലാം ഫയലുകൾ തുറന്നുകാട്ടാൻ കഴിയും. വിഭവങ്ങൾ അടങ്ങിയ വിഭാഗം ലോഡ് ചെയ്തുകൊണ്ട് ആരംഭിക്കുക, തുടർന്ന് ഫലങ്ങൾ സ്കാൻ ചെയ്ത് അവലോകനം ചെയ്യുക. ഒരു സ്കാനറിന് പേജ് ബ്രൗസറിലേക്ക് ലഭ്യമാക്കുന്ന വിഭവങ്ങൾ മാത്രമേ പട്ടികപ്പെടുത്താൻ കഴിയൂ.
ഡൗൺലോഡ് ചെയ്യാവുന്ന ഫയൽ എന്ന് എന്താണ് കണക്കാക്കുന്നത്
ഡൗൺലോഡ് ചെയ്യാവുന്ന ഫയൽ ഒരു ലിങ്കുചെയ്ത ഡോക്യുമെന്റ്, ഒരു ചിത്രം സ്രോത്ത്, ഒരു മീഡിയ എലമെന്റ്, ഒരു ആർക്കൈവ്, ഒരു സ്പ്രെഡ്ഷീറ്റ്, അല്ലെങ്കിൽ പേജ് ഉദ്ദ്ദേശിക്കുന്ന മറ്റൊരു പൊതു ആസ്തി ആയിരിക്കാം. ബ്രൗസർ അതിനെ അഭ്യർത്ഥിക്കുകയോ പ്രദർശിപ്പിക്കുകയോ ചെയ്യാൻ സ്രോത്തെക്കുറിച്ച് വേണ്ടത്ര അറിവ് ഉണ്ടാകണം.
ഫയൽ കണ്ടെത്തലെന്ന് സേച്വർ എക്സ്പ്ലോറേഷൻ അല്ല. GrabAll നിലവിലെ പേജ് അല്ലെങ്കിൽ നൽകിയ URL ൽ മാത്രമേ പ്രവർത്തിക്കുകയുള്ളൂ, പ്രൈവറ്റ് ഡയറക്ടറികളിലും ലിസ്റ്റ് ചെയ്യാത്ത സെർവർ ഉള്ളടക്കത്തിലുമല്ല.
- പ്രമാണങ്ങളിലേക്കും ആർക്കൈവുകളിലേക്കും ആങ്കർ ലിങ്കുകൾ
- ചിത്രത്തിനുള്ള src, srcset, lazy-load ഗുണങ്ങള്ക്കൾ
- വീഡിയോ, ഓഡിയോ, പോസ്റ്റർ, ഉറവിട ഘടകങ്ങൾ
- പേജ് ടെക്സ്റ്റിലോ ഡാറ്റാ ആട്രിബ്യൂട്ടുകളിലോ ഉള്ള പൊതു ഫയൽ URL-കൾ
സങ്കേതപരവും ഘടനാപരവുമായ കണ്ടെത്തൽ പ്രക്രിയ
ഏറ്റവും പ്രസക്തമായ പേജ് ആദ്യം സ്കാൻ ചെയ്യുക. തരം അനുസരിച്ച് ഫലങ്ങൾ ഗ്രൂപ്പ് ചെയ്യുക, തുടർന്ന് ഫയൽ വിപുലീകരണങ്ങൾ, MIME സൂചനകൾ, അളവുകൾ, വലുപ്പങ്ങൾ, ഉറവിട ഡൊമെയ്നുകൾ എന്നിവ പരിശോധിക്കുക. ലഭ്യമുള്ളിടത്ത് പ്രിവ്യൂകൾ ഉപയോഗിക്കുക.
പേജ് ഡൈനാമിക് ആണെങ്കിൽ, അനുയോജ്യമായ വിഭാഗം ലോഡ് ആകാൻ അനുവദിച്ച് ശേഷം സ്കാൻ ചെയ്യുക. സംബന്ധമില്ലാത്ത ഭാഗങ്ങൾ സ്ക്രോൾ ചെയ്യാൻ ഒഴിവാക്കുക, കാരണം അത് ശുപാർശകളും നാവിഗേഷൻ അപ്സറ്റുകളും ഫലം സെറ്റിലേക്ക് ചേർക്കാം.
- ഒരു നിർദ്ദിഷ്ട പേജ് തിരഞ്ഞെടുക്കുക
- പ്രവൃത്തി സംബന്ധമായ ഉള്ളടക്കം ലോഡ് ചെയ്യുക
- തരം അനുസരിച്ച് സ്കാനും ഗ്രൂപ്പ് ഫലങ്ങളും
- ഉപയോഗപ്രദമായ ഫയലുകൾ ഫിൽട്ടർ ചെയ്യുക, പ്രിവ്യൂ ചെയ്യുക, തിരഞ്ഞെടുക്കുക
URL കൾ
ചില ഡൗൺലോഡുകൾ .pdf അല്ലെങ്കിൽ .zip ൽ അവസാനിക്കുന്ന ഫയൽ നാമങ്ങൾക്ക് പകരം /download?id=123 പോലുള്ള റൂട്ടുകൾ ഉപയോഗിക്കുന്നു. സെർവർ പ്രതികരിക്കുന്നതിന് മുമ്പ് ഈ ലിങ്കുകൾ തരംതിരിക്കാൻ ബുദ്ധിമുട്ടാണ്. പേജ് ലേബലുകൾ, പ്രതികരണ തലക്കെട്ടുകൾ, ബ്രൗസർ ഡൗൺലോഡ് സ്വഭാവം എന്നിവ കൂടുതൽ വിവരങ്ങൾ നൽകിയേക്കാം.
ഓരോ നീണ്ട URL ഒരു ഫയലാണെന്ന് കരുതരുത്. ട്രാക്കിംഗ്, നാവിഗേഷൻ, API ലിങ്കുകൾ എന്നിവ സമാനമായി കാണപ്പെടാം.
സോഴ്സ് കാണുന്നത് തികച്ചും സ്കാനിംഗ് ഉൽക്കൃഷ്ടമാകുമ്പോൾ
എച്ച്ടിഎംഎൽ ഉറവിടം കാണുന്നത് സാങ്കേതിക ഉപയോക്താക്കളെ സഹായിക്കും, പക്ഷേ ആധുനിക പേജുകൾ പ്രാരംഭ ഡോക്യുമെന്റ് ലോഡുചെയ്തതിന് ശേഷം പതിവായി ഉള്ളടക്കം ചേർക്കുന്നു. ഒരു ബ്രൗസർ വിപുലീകരണത്തിന് റെൻഡർ ചെയ്ത സന്ദർഭം പരിശോധിക്കാനും അവലോകന അധിഷ്ഠിത ഇന്റർഫേസിൽ ഫലങ്ങൾ അവതരിപ്പിക്കാനും കഴിയും.
പേസ്റ്റ് ചെയ്ത HTML അല്ലെങ്കിൽ ഓഫ്ലൈൻ സോഴ്സ് ഉപയോഗിക്കുന്നതിന് സൗജന്യ ബൾക് ഫയൽ URL എക്സ്ട്രാക്ടർ ഉപയോഗിക്കുക. ലൈവ് പേജിനായി, കണ്ടെത്തലുകൾ പ്രിവ്യൂസും ഡൗൺലോഡ് സെലക്ഷനും ചേർത്ത് ഉപയോഗിക്കാൻ GrabAll ഉപയോഗിക്കുക.
യാഥാർത്ഥ്യബോധമുള്ള പ്രതീക്ഷകൾ സജ്ജമാക്കുക
ആധികാരികതയ്ക്ക് പിന്നിലുള്ള ഫയലുകൾ, സംരക്ഷിത API കോളുകൾക്ക് ശേഷം സൃഷ്ടിക്കപ്പെട്ട, സ്വകാര്യ സിസ്റ്റങ്ങളിൽ സംഭരിച്ചതോ DRM വഴി വിതരണം ചെയ്തതോ ആധികാരികതയ്ക്ക് പിന്നിലെ ഫയലുകൾ ഒരു സാധാരണ പേജ് സ്കാനറിന്റെ പരിധിക്ക് പുറത്താണ്. ആക്സസ് നിയമങ്ങളെ മാനിക്കുക, നൽകിയിടത്ത് ഔദ്യോഗിക ഡൗൺലോഡ് നിയന്ത്രണങ്ങൾ ഉപയോഗിക്കുക.
അഭ്യന്തര മൂല്യങ്ങൾ, ഗാലറികൾ, അറ്റാച്ച്മെന്റുകൾ, ഡോക്യുമെന്റുകൾ അല്ലെങ്കിൽ സാധാരണ മീഡിയ ഫയലുകൾ വ്യക്തമായി പ്രദർശിപ്പിക്കുന്ന പേജുകളിൽ നിന്ന് മികച്ച ഫലങ്ങൾ ലഭിക്കുന്നു.
പതിവായി ചോദിക്കുന്ന ചോദ്യങ്ങൾ
പേജിൽ ലിങ്കുചെയ്യാത്ത ഫയലുകൾ കണ്ടെത്താൻ GrabAll?
ഇല്ല. ഇത് ബ്രൗസറിലേക്ക് ലഭ്യമായ വിഭവങ്ങളും ലിങ്കുകളും സംഘടിപ്പിക്കുന്നു; ഇത് സ്വകാര്യ സെർവർ ഡയറക്ടറികൾ തിരയുകയോ തുറന്നുകാട്ടാത്ത ഫയലുകൾ വെളിപ്പെടുത്തുകയോ ചെയ്യുന്നില്ല.
ഞാൻ ഹോംപേജ് അല്ലെങ്കിൽ ഒരു നിർദ്ദിഷ്ട പേജ് സ്കാൻ ചെയ്യണോ?
സാധ്യമായ ഏറ്റവും നിർദ്ദിഷ്ട പേജ് ഉപയോഗിക്കുക. ഇത് കുറച്ച് ബന്ധമില്ലാത്ത ആസ്തികളും ശുദ്ധമായ ഫലങ്ങളും സൃഷ്ടിക്കുന്നു.
ഒരു URL-യ്ക്ക് ഫയൽ എക്സ്റ്റൻഷൻ ഇല്ലെങ്കിൽ എന്ത് സംഭവിക്കും?
ഇത് എങ്കിലും ഡൗൺലോഡ് സൃഷ്ടിക്കാം, എന്നാൽ സെർവർ പ്രതികരിക്കുന്നതു വരെ വർഗ്ഗീകരണം കുറഞ്ഞ വിശ്വാസ്യതയുള്ളതാണ്. പേജിന്റെ ലേബൽ പരിശോധന നടത്തി സംശയമുണ്ടെങ്കിൽ ഔദ്യോഗിക നിയന്ത്രണം ഉപയോഗിക്കുക.
പകരം പകർത്തിയ എച്ച്ടിഎംഎല്ലിൽ നിന്ന് എനിക്ക് ലിങ്കുകൾ വേർതിരിച്ചെടുക്കാൻ കഴിയുമോ?
അതെ. GrabAll പേസ് ചെയ്ത HTML, സോഴ്സ് കോഡ്, ടെക്സ്റ്റ് എന്നിവയ്ക്കായി ഒരു സൗജന്യ ബൾക് ഫയൽ URL എക്സ്ട്രാക്ടർ നൽകുന്നു.
GrabAll സ്കാൻ ചെയ്യുകയും ചിത്രങ്ങൾ, പ്രമാണങ്ങൾ, മീഡിയ, മറ്റ് ഡൗൺലോഡ് ചെയ്യാവുന്ന ഫയലുകൾ എന്നിവ ഒരു വ്യക്തമായ പട്ടികയിലേക്ക് കൊണ്ടുവരികയും ചെയ്യുന്നു, അതിനാൽ എന്താണ് സംരക്ഷിക്കേണ്ടതെന്ന് നിങ്ങൾക്ക് തിരഞ്ഞെടുക്കാം.