
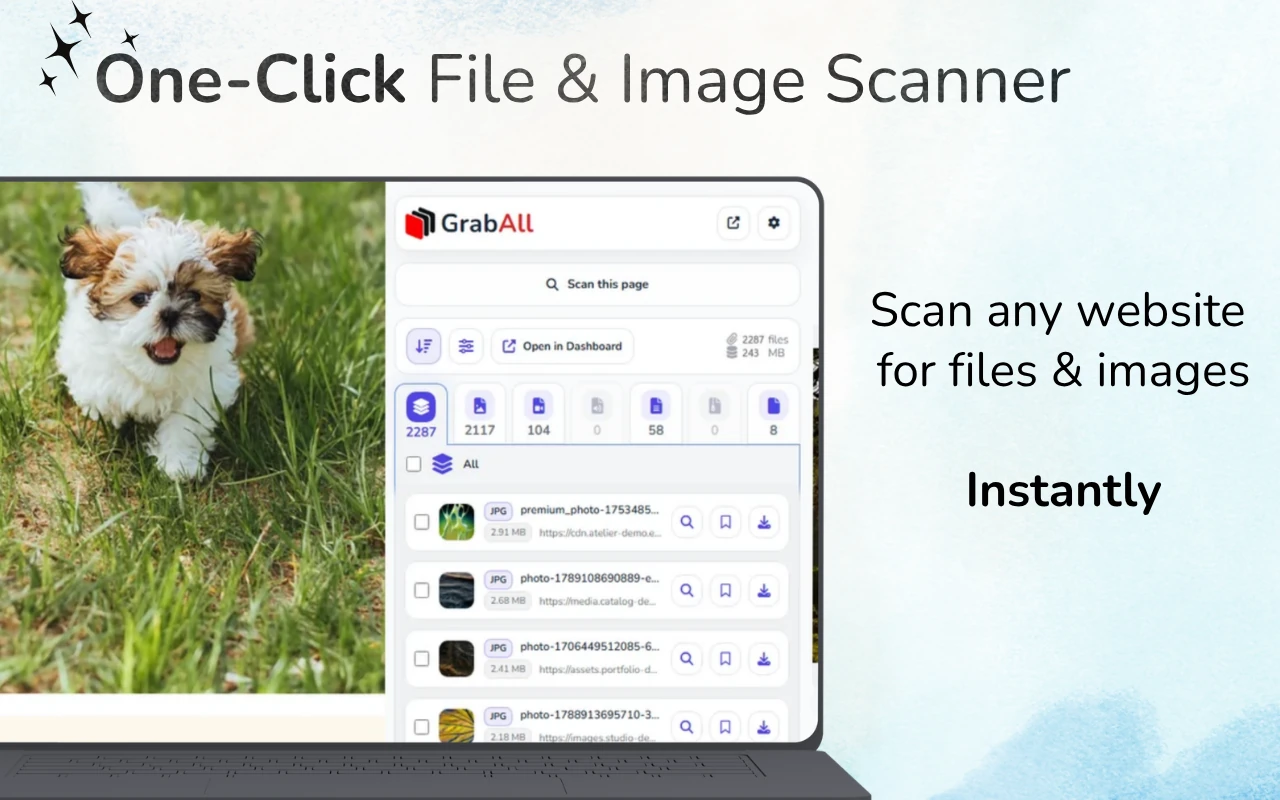
जलद उत्तर: वेबपृष्ठ उघडा, संबंधित सामग्री लोड करा आणि GrabAll ने स्कॅन करा. शोधलेल्या फायलींचे प्रकार किंवा आकारानुसार फिल्टर करा, पूर्वावलोकने आणि फाइल नावे तपासा, नंतर निवडलेल्या लिंक जतन करा किंवा कॉपी करा. काही संसाधने फक्त पृष्ठावर इंटरऍक्शन केल्यावर दिसतात.
लोड केलेल्या पृष्ठात फाइल लिंक शोधा
डाउनलोड बटणे, दस्तऐवज यादी, इमेज कार्ड्स आणि मीडिया घटक हे सर्व फाइल्स उघड करू शकतात. संसाधन असलेला विभाग लोड करून सुरू करा, नंतर परिणाम स्कॅन करा आणि पुनरावलोकन करा. स्कॅनर फक्त ती संसाधने सूचीबद्ध करू शकतो जी पृष्ठ ब्राउझरला उपलब्ध करून देते.
डाउनलोड करण्यायोग्य फाइल म्हणून काय मोजले जाते
डाउनलोड करण्यायोग्य फाईल एक दुवा साधलेला दस्तऐवज, एक प्रतिमा स्त्रोत, एक मीडिया घटक, एक संग्रह, एक स्प्रेडशीट किंवा पृष्ठाद्वारे संदर्भित इतर सार्वजनिक मालमत्ता असू शकते. ब्राउझरला विनंती करण्यासाठी किंवा प्रदर्शित करण्यासाठी संसाधनाबद्दल पुरेसे माहिती असणे आवश्यक आहे.
फाइल शोधणे म्हणजे सर्व्हरची तपासणी करणे नसते. GrabAll चालू पेज आणि दिलेल्या URL सह काम करते, खाजगी निर्देशिका किंवा सूचीबद्ध नसलेल्या सर्व्हर कंटेंटसह नाही.
- दस्तऐवज आणि आर्काइवकडे अँकर लिंक
- प्रतिमा src, srcset, आणि लेझी-लोड गुणधर्म
- व्हिडिओ, ऑडिओ, पोस्टर, आणि स्रोत घटक
- पृष्ठ मजकूर किंवा डेटा अॅट्रीब्यूट्समध्ये असलेले सार्वजनिक फाइल URL
एक संरचित शोध प्रक्रिया
प्रथम सर्वात संबंधित पृष्ठ स्कॅन करा. प्रकारानुसार परिणाम गटबद्ध करा, नंतर फाइल विस्तार, एमआयएमई संकेत, परिमाण, आकार आणि स्त्रोत डोमेनची तपासणी करा. जेथे उपलब्ध असेल तेथे पूर्वावलोकने वापरा.
जर पृष्ठ डायनॅमिक असेल, तर स्कॅन करण्यापूर्वी संबंधित विभाग लोड होऊ द्या. अवांछित भागांवर स्क्रोल करणे टाळा कारण यामुळे परिणामामध्ये शिफारसी आणि नेव्हिगेशन साधने जोडली जाऊ शकतात.
- एखादे विशिष्ट पृष्ठ निवडा
- कार्याशी संबंधित सामग्री लोड करा
- प्रकारानुसार स्कॅन आणि गट परिणाम
- फिल्टर करा, पूर्वदृश्य करा आणि उपयोगी फायली निवडा
स्पष्ट विस्ताराविना URLs
काही डाउनलोड /download?id=123 सारख्या मार्गांचा वापर करतात, जे .pdf किंवा .zip ने समाप्त होणाऱ्या फाइल नावाऐवजी असते. सर्व्हर प्रतिसाद देण्यापूर्वी या लिंक वर्गीकृत करणे कठीण असू शकते. पृष्ठ लेबल, प्रतिसाद हेडर्स आणि ब्राउजर डाउनलोड वर्तन अधिक माहिती प्रदान करू शकतात.
प्रत्येक लांब URL ही फाइल असल्याचे गृहीत धरू नका. ट्रॅकिंग, नेव्हिगेशन आणि API लिंक्स यांसारखे दिसू शकतात.
जेव्हा स्कॅनिंग स्त्रोत पाहण्यापेक्षा चांगले असते
HTML स्रोत पाहणे तांत्रिक वापरकर्त्यांसाठी उपयुक्त आहे, पण आधुनिक पृष्ठे सुरुवातीच्या दस्तऐवज लोड केल्यानंतर सामग्री जोडतात. ब्राउझर एक्स्टेंशन रेंडर केलेल्या संदर्भाची तपासणी करू शकते आणि पुनरावलोकन-आधारित इंटरफेसमध्ये निकाल सादर करू शकते.
पेस्ट केलेल्या HTML किंवा ऑफलाइन स्रोतासाठी, फ्री Bulk File URL Extractor वापरा. लाइव्ह पृष्ठासाठी, GrabAll वापरा जेणेकरून शोधणे, प्रिव्ह्यू आणि डाउनलोड निवड एकत्र करू शकता.
वास्तविक अपेक्षा ठेवा
प्रमाणीकरणाखालील फायली, संरक्षित API कॉलनंतर तयार झालेल्या, खाजगी प्रणालीमध्ये संग्रहित किंवा DRM माध्यमातून वितरित केल्या जाणार्या फायली सामान्य पेज स्कॅनरच्या व्याप्तीबाहेर आहेत. प्रवेश नियमांहेरवे करा आणि जिथे देण्यात आलेले अधिकृत डाउनलोड नियंत्रण आहे तिथे वापरा.
सर्वोत्तम परिणाम त्या पृष्ठांपासून येतात जे जाणूनबुजून स्त्रोत दुवे, गॅलरी, जोडणी, दस्तऐवज, किंवा सामान्य मीडिया फाइल्स उघडतात.
वारंवार विचारले जाणारे प्रश्न
GrabAll पृष्ठावर लिंक नसलेल्या फाइल्स शोधू शकतो का?
नाही. हे ब्राउझरसाठी उपलब्ध संसाधने आणि दुवे आयोजित करते; हे खाजगी सर्व्हर निर्देशिका शोधत नाही किंवा उघडकीस न आलेल्या फायली प्रकट करत नाही.
मला होमपेज स्कॅन करायचा आहे की एखादे विशिष्ट पृष्ठ?
सर्वात विशिष्ट पृष्ठ वापरा. हे कमी अप्रासंगिक साधने निर्माण करते आणि स्वच्छ परिणाम मिळवून देते.
URL मध्ये फाइल विस्तार नसल्यास काय करावे?
हे अद्याप डाउनलोड तयार करू शकते, परंतु सर्व्हर प्रतिसाद देईपर्यंत वर्गीकरण कमी विश्वासार्ह आहे. पृष्ठ लेबलचे पुनरावलोकन करा आणि अनिश्चित असताना अधिकृत नियंत्रण वापरा.
मी कॉपी केलेल्या HTML मधून लिंक काढू शकतो का?
होय. GrabAll पेस्ट केलेल्या HTML, स्त्रोत कोड आणि मजकूरासाठी एक विनामूल्य बल्क फाइल URL एक्सट्रॅक्टर प्रदान करते.
GrabAll पृष्ठ स्कॅन करते आणि प्रतिमा, दस्तऐवज, मीडिया आणि इतर डाउनलोड होण्याजोग्या फाईल्स एका स्पष्ट यादीत आणते, जेणेकरून आपण नेमके काय जतन करायचे आहे ते निवडू शकता.