
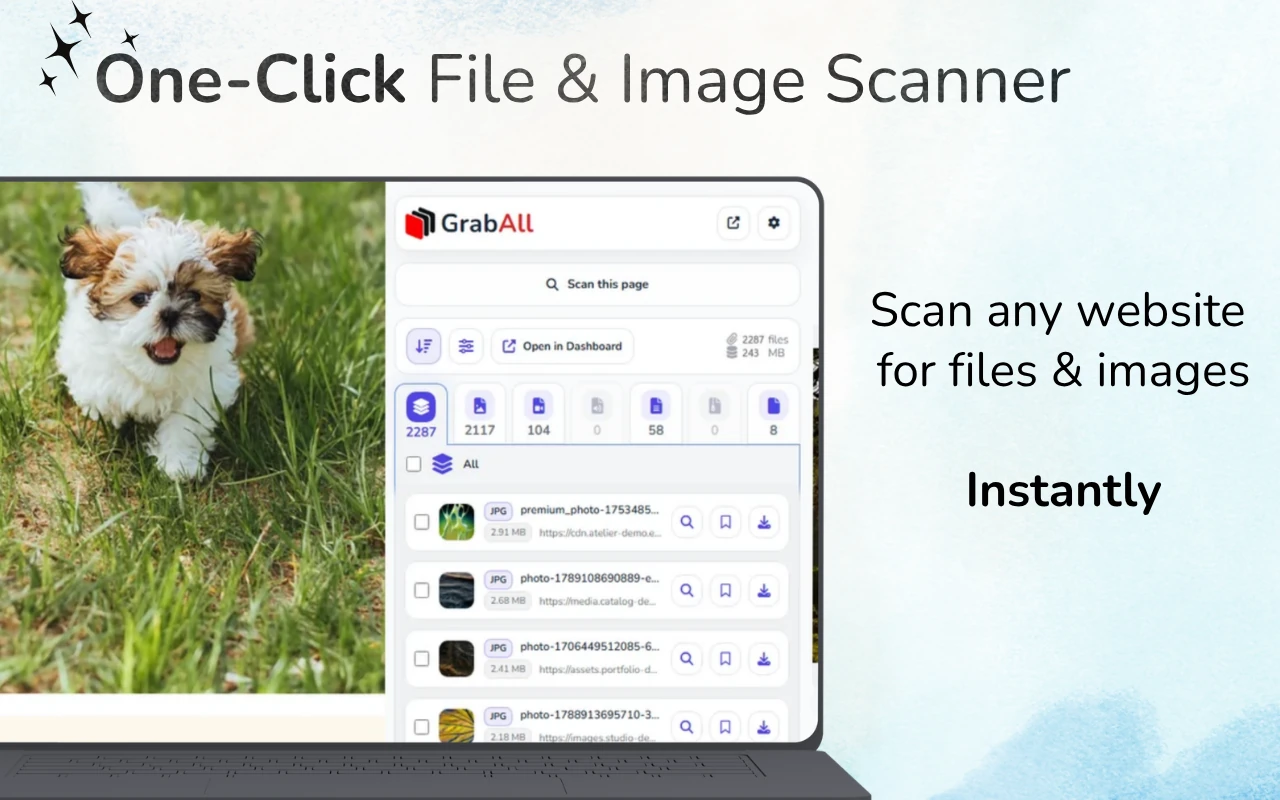
Jawapan pantas: Untuk laman web langsung, imbas dengan GrabAll dan salin pautan fail yang dikesan. Untuk HTML yang disimpan atau kod sumber yang disalin, tampalkan ke dalam Bulk File URL Extractor. Sediakan URL asas apabila sumber mengandungi pautan relatif.
Pilih antara mengimbas halaman dan menafsir HTML yang disalin
Mengimbas laman web yang dimuatkan boleh menemui fail yang tersedia di pelayar, manakala pengekstrak dalam talian hanya membaca HTML atau teks yang anda tampal. Pilih kaedah yang sepadan dengan titik permulaan anda, kemudian semak URL yang terhasil sebelum menggunakannya untuk muat turun.
Di mana URL fail muncul dalam HTML
Pautan biasa menggunakan href, manakala gambar dan media biasanya menggunakan src. Gambar responsif boleh menyenaraikan beberapa calon dalam srcset. Pustaka pemuatan malas sering menyimpan URL sebenar dalam data-src, data-original, atau atribut data tersuai.
Gaya lembaran dan CSS sebaris boleh merujuk latar belakang melalui url(). Teks mentah juga boleh mengandungi URL lengkap yang tidak disertakan pada elemen HTML.
- pautan href
- atribut src dan poster
- calon srcset dan data-srcset
- Nilai url() CSS dan URL mutlak mentah
Selesaikan laluan relatif dengan betul
Nilai seperti ../files/report.pdf hanya bermakna relatif kepada halaman di mana HTML berasal. Sediakan URL halaman asal sebagai asas supaya pengekstrak dapat menukar laluan relatif menjadi alamat lengkap.
Pautan relatif protokol yang bermula dengan // biasanya mewarisi HTTPS pada halaman selamat. Laluan relatif akar yang bermula dengan / menggunakan asal laman web semasa.
- Simpan URL halaman sumber asal
- Gunakan ini sebagai URL asas
- Normalkan protokol relatif dan laluan relatif root
- Semak domain yang telah diselesaikan sebelum menggunakan senarai
Tapis URL calon mengikut niat
Tidak setiap URL dalam kod sumber adalah aset boleh dimuat turun. Halaman mengandungi pautan navigasi, API, analitik, fon, skrip, helaian gaya, dan parameter penjejakan. Tapis mengikut sambungan yang berkaitan dan periksa URL yang samar.
Untuk imej, sertakan format moden seperti WebP dan AVIF. Untuk dokumen, pertimbangkan PDF, DOCX, XLSX, CSV, PPTX, dan arkib mengikut tugasan.
sumber HTML berbanding halaman yang dihasilkan
Sumber yang disalin hanya mewakili apa yang anda sediakan. Ia mungkin tidak termasuk sumber yang dimasukkan selepas JavaScript dijalankan, kandungan yang dimuat selepas menatal, atau URL yang dibuat semasa interaksi.
Gunakan pengekstrak luar talian untuk petikan sumber, HTML yang dieksport, templat e-mel, dan semakan kod. Gunakan sambungan GrabAll untuk halaman yang dirender secara langsung dan aliran kerja berasaskan penyemak imbas.
Sahkan sebelum memuat turun
Duplikatkan senarai, periksa domain, dan uji sampel kecil. Sambungan yang sepadan dalam URL tidak menjamin bahawa respons adalah sah atau bahawa anda dibenarkan menggunakannya.
Elakkan meminta senarai besar yang belum disemak secara automatik. Pengesahan menghalang pautan rosak, titik penjejakan yang tidak diingini, dan beban yang tidak perlu.
Soalan Lazim
Bolehkah pengekstrak menyelesaikan pautan relatif ../ ?
Ya, apabila anda memberikan URL halaman asal sebagai alamat asas.
Adakah pengekstrakan HTML termasuk imej srcset?
Alat GrabAll memeriksa atribut sumber biasa dan imej responsif, termasuk calon srcset.
Mengapa beberapa fail halaman langsung hilang daripada HTML yang disalin?
JavaScript mungkin menambahkannya selepas HTML awal dimuat. Gunakan sambungan pelayar langsung untuk kandungan halaman yang dirender dan dimuat secara dinamik.
Adakah semua URL yang diekstrak selamat untuk dimuat turun?
Tidak. Semak domain, jenis fail, kebenaran, dan sampel kecil sebelum menggunakan senarai hasil.
GrabAll mengimbas halaman dan membawa imej, dokumen, media, dan fail boleh dimuat turun lain ke dalam satu senarai jelas, supaya anda boleh memilih dengan tepat apa yang hendak disimpan.