
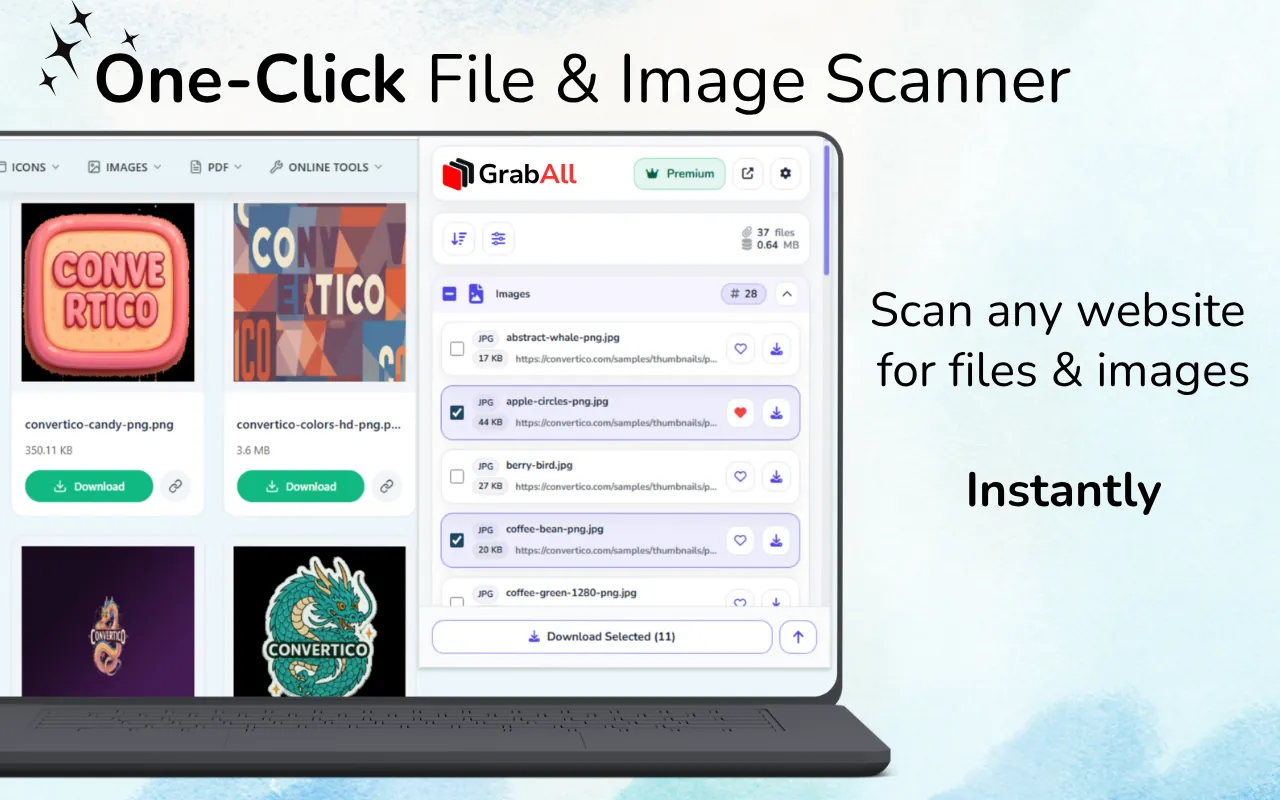
Resposta rápida: Para uma página da web ao vivo, escaneie com o GrabAll e copie os links de arquivos detectados. Para HTML salvo ou código-fonte copiado, cole-o no Extrator de URLs de Arquivos em Lote. Forneça uma URL base quando o código-fonte contiver links relativos.
Escolha entre escanear uma página ou analisar o HTML colado
Escanear uma página da web carregada pode encontrar arquivos disponíveis no navegador, enquanto o extrator online lê apenas o HTML ou o texto que você colar. Escolha o método que corresponda ao seu ponto de partida e, em seguida, revise as URLs resultantes antes de usá-las para downloads.
Onde as URLs de arquivos aparecem no HTML
Links comuns usam href, enquanto imagens e mÃdia comumente usam src. Imagens responsivas podem listar vários candidatos em srcset. Bibliotecas de carregamento preguiçoso muitas vezes armazenam URLs reais em dados-src, dados-originais, ou atributos de dados personalizados.
Folhas de estilo e CSS em linha podem referenciar fundos através de url(). Texto bruto também pode conter URLs completas que não estão ligados a um elemento HTML. Suporte ao
- href
- atributos src e poster
- srcset e candidatos de data-srcset
- CSS url () e valores absolutos brutos URLs Modo de cálculo
Resolva os caminhos relativos corretamente
Um valor como ../files/report.pdf é significativo apenas em relação à página de onde o HTML veio. Forneça a página original URL como base para que o extrator possa transformar caminhos relativos em endereços completos.
começando com // normalmente herdar HTTPS em uma página segura. Caminhos Guias relacionados com raiz começando com / usar a origem do site atual.
- Mantenha a página original URL
- Use-o como base URL
- Normalizar caminhos Guias relacionados ao protocolo e Guias relacionados à raiz
- Revise os domÃnios resolvidos antes de usar a lista Direitos
Filtre as URLs por finalidade
Nem todo URL em código fonte é um ativo para download. Páginas contêm links de navegação, APIs, análise, fontes, scripts, folhas de estilo e parâmetros de rastreamento. Filtrar por extensões relevantes e inspecionar URLs ambÃguo.
Para imagens, incluem formatos modernos, como WebP e AVIF. Para documentos, considere PDF, DOCX, XLSX, CSV, PPTX e arquivos de acordo com a tarefa.
HTML versus a página renderizada
O código copiado representa apenas o que você forneceu. Ele pode perder os recursos inseridos após a execução do JavaScript, o conteúdo carregado após a rolagem ou o URLs criado durante a interação.
Use o extrator offline para trechos de origem, HTML exportado, modelos de email e revisão de código. Use a extensão GrabAll para os fluxos de trabalho de página renderizados ao vivo e de contexto de navegador.
Validar antes de baixar
Deduplicar a lista, inspecionar domÃnios e testar uma pequena amostra. Uma extensão correspondente em uma URL não garante que a resposta é válida ou que você está autorizado a usá-la.
Evite solicitar automaticamente grandes listas não revistas. Validação evita links quebrados, endpoints de rastreamento indesejados e carga desnecessária.
Perguntas frequentes
O extrator pode resolver ../ links relativos?
Sim, quando você fornece a página original URL como o endereço base.
A extração HTML inclui imagens srcset?
A ferramenta GrabAll verifica atributos de fonte comum e imagem responsiva, incluindo candidatos srcset.
Por que alguns arquivos de página ao vivo estão faltando do HTML copiado?
JavaScript pode adicioná-los após as cargas iniciais do HTML. Use a extensão do navegador ao vivo para renderizar e carregar dinamicamente o conteúdo da página.
Todos os URLs extraÃdos são seguros para download?
Não. Reveja domÃnios, tipos de arquivos, permissões e uma pequena amostra antes de usar uma lista de resultados.
O GrabAll verifica a página e reúne imagens, documentos, mídia e outros arquivos disponíveis para download em uma lista organizada, para você escolher exatamente o que deseja salvar.