
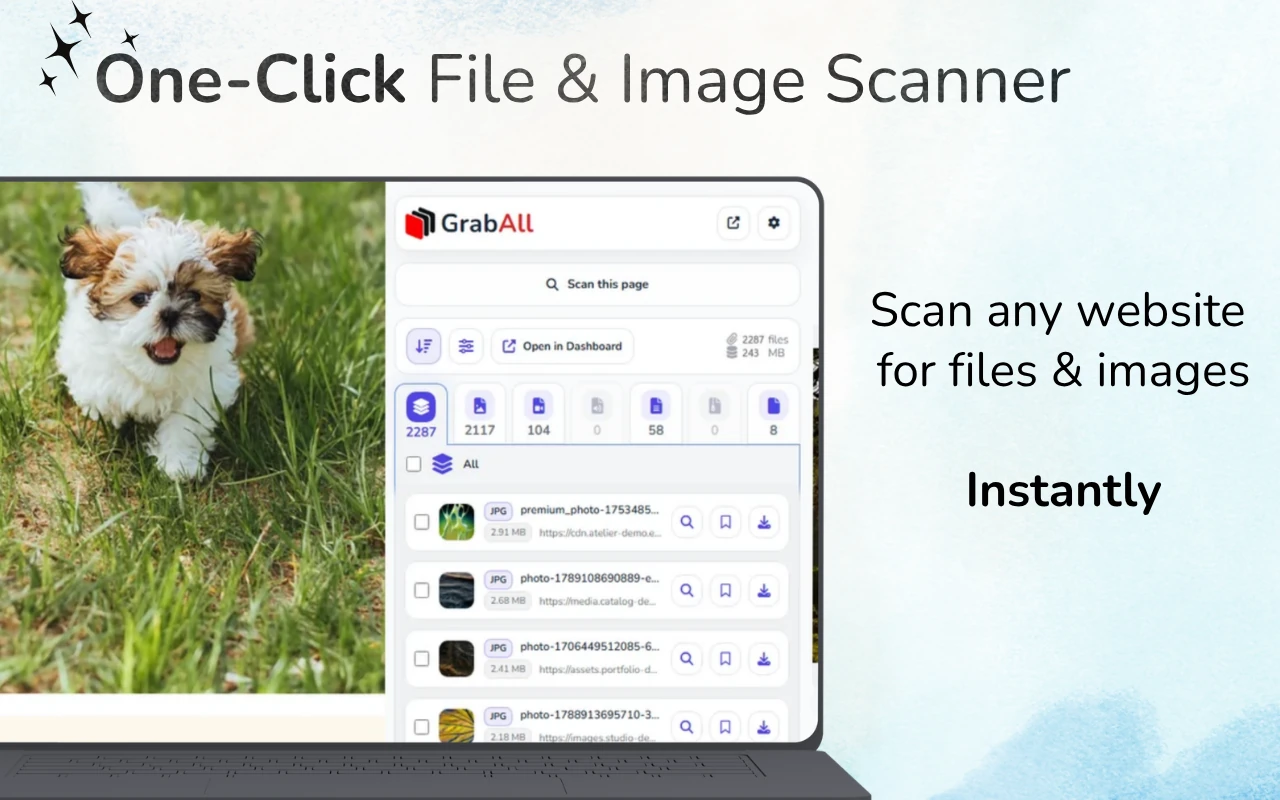
Răspuns rapid: Deschide pagina web, încarcă conținutul relevant și scaneaz-o cu GrabAll. Filtrează fișierele detectate după tip sau dimensiune, verifică previzualizările și numele fișierelor, apoi salvează sau copiază linkurile selectate. Unele resurse apar doar după o interacțiune cu pagina.
Caută linkuri de fișiere în pagina încărcată
Butoanele de descărcare, listele de documente, cardurile de imagini și elementele media pot expune toate fișierele. Începe prin a încărca secțiunea care conține resursele, apoi scanează și revizuiește rezultatele. Un scanner poate lista doar resursele pe care pagina le face disponibile browserului.
Ce se consideră fișier descărcabil
Un fișier descărcabil poate fi un document legat, o sursă de imagine, un element media, un arhivă, un tabel de calcul sau un alt bun public menționat de pagină. Browserul trebuie să știe suficient despre resursă pentru a o solicita sau afișa.
Descoperirea fișierelor nu înseamnă explorarea serverului. GrabAll funcționează cu pagina curentă și URL-urile furnizate, nu cu directoare private sau conținuturi de server nelistate.
- Legături ancoră către documente și arhive
- Atributele src, srcset și lazy-load ale imaginilor
- Elemente video, audio, poster și sursă
- URL-uri publice de fișiere prezente în textul paginii sau atributele de date
Un proces structurat de descoperire
Scanează mai întâi pagina cea mai relevantă. Grupează rezultatele după tip, apoi inspectează extensiile fișierelor, indicii MIME, dimensiunile, mărimile și domeniile sursă. Folosește previzualizările disponibile.
Dacă pagina este dinamică, permiteți secțiunii relevante să se încarce înainte de scanare. Evitați să derulați prin zone nesemnificative, deoarece asta poate adăuga recomandări și elemente de navigare în setul de rezultate.
- Alege o pagină specifică
- Încarcă conținutul relevant pentru sarcină
- Scanează și grupează rezultatele după tip
- Filtrează, previzualizează și selectează fișierele utile
URL-uri fără extensii evidente
Unele descărcări folosesc rute precum /download?id=123 în loc de nume de fișiere ce se termină cu .pdf sau .zip. Aceste linkuri pot fi mai greu de clasificat înainte ca serverul să răspundă. Etichetele paginii, anteturile răspunsului și comportamentul de descărcare al browserului pot oferi mai multe informații.
Nu presupune că orice URL lung este un fișier. Linkurile de urmărire, navigație și API pot arăta similar.
Când scanarea este mai bună decât vizualizarea sursei
Vizualizarea codului sursă HTML poate ajuta utilizatorii tehnici, dar paginile moderne adaugă frecvent conținut după încărcarea documentului inițial. O extensie de browser poate inspecta contextul redat și poate prezenta rezultatele într-o interfață orientată spre revizuire.
Pentru HTML lipit sau sursă offline, folosiți gratuit Bulk File URL Extractor. Pentru pagina live, folosiți GrabAll pentru a putea combina descoperirea cu previzualizările și selecția descărcărilor.
Stabilește așteptări realiste
Fișierele din spatele autentificării, generate după apeluri API protejate, stocate în sisteme private sau livrate prin DRM sunt în afara domeniului unui scaner normal de pagini. Respectați regulile de acces și folosiți controalele oficiale de descărcare atunci când sunt disponibile.
Cele mai bune rezultate provin de la pagini care expun deliberat link-uri către resurse, galerii, atașamente, documente sau fișiere media obișnuite.
Întrebări frecvente
Poate GrabAll să găsească fișiere care nu sunt legate pe pagină?
Nu. Organizează resursele și linkurile disponibile în browser; nu caută directoare private de pe server sau nu dezvăluie fișiere neexpuse.
Ar trebui să scanez pagina principală sau o pagină specifică?
Folosește cea mai specifică pagină posibilă. Aceasta produce mai puține resurse fără legătură și rezultate mai clare.
Ce se întâmplă dacă un URL nu are extensie de fișier?
Poate încă să genereze un descărcare, dar clasificarea este mai puțin fiabilă până când serverul răspunde. Revizuiește eticheta paginii și folosește controlul oficial când nu ești sigur.
Pot să extrag linkuri din HTML copiat în schimb?
Da. GrabAll oferă un Extractor Gratuit de URL-uri pentru fișiere multiple pentru HTML, cod sursă și text lipit.
GrabAll scanează pagina și aduce imagini, documente, media și alte fișiere descărcabile într-o listă clară, astfel încât să poți alege exact ce să salvezi.