
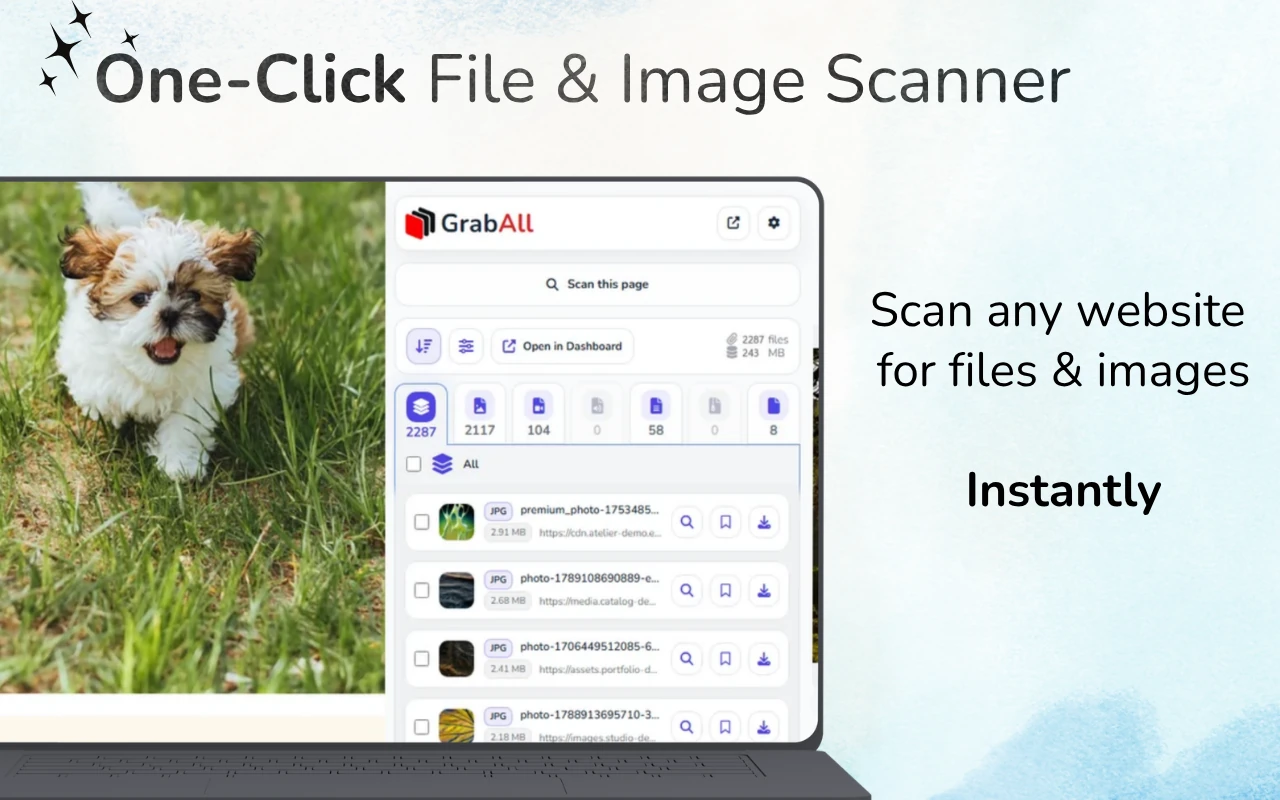
Быстрый ответ: Для активной веб-страницы сканируйте с помощью GrabAll и скопируйте обнаруженные ссылки на файлы. Если вы сохранили HTML-код или скопировали исходный код, вставьте его в средство массового извлечения URL-адресов файлов. Укажите базовый URL-адрес, если источник содержит относительные ссылки.
Выберите между сканированием страницы и анализом вставленного HTML
Сканирование загруженной веб-страницы позволяет найти файлы, доступные в браузере, в то время как онлайн-экстрактор считывает только HTML или текст, который вы вставляете. Выберите метод, который соответствует вашей отправной точке, затем просмотрите полученные URL-адреса, прежде чем использовать их для загрузки.
Где появляются URL-адреса файлов HTML
Обычные ссылки используют href, тогда как изображения и медиа обычно используют src. Адаптивные изображения могут содержать несколько кандидатов в srcset. Библиотеки с отложенной загрузкой часто хранят реальные URL-адреса в атрибутах data-src, data-original или пользовательских данных.
Таблицы стилей и встроенный CSS могут ссылаться на фон через url(). Необработанный текст также может содержать полные URL-адреса, которые не прикреплены к элементу HTML.
- ссылки href
- атрибуты источника и плаката
- источник и кандидаты в набор источников данных
- Значения CSS url() и необработанные абсолютные URL-адреса
Правильно разрешайте относительные пути
Такое значение, как ../files/report.pdf, имеет смысл только относительно страницы, откуда был получен HTML-код. Укажите исходный URL-адрес страницы в качестве основы, чтобы экстрактор мог преобразовать относительные пути в полные адреса.
Относительно протокола ссылки, начинающиеся с //, обычно наследуют HTTPS на защищенной странице. Относительно корня пути, начинающиеся с /, используют текущий источник веб-сайта.
- Сохраните исходный URL-адрес исходной страницы.
- Используйте его в качестве базового URL-адреса
- Нормализация путей относительно протокола и корня
- Проверьте разрешенные домены перед использованием списка
Фильтрация URL-адресов-кандидатов по намерению
Не каждый URL-адрес в исходном коде является загружаемым ресурсом. Страницы содержат навигационные ссылки, API, аналитику, шрифты, скрипты, таблицы стилей и параметры отслеживания. Фильтруйте по соответствующим расширениям и проверяйте неоднозначные URL-адреса.
Для изображений включите современные форматы, такие как WebP и AVIF. Для документов рассмотрите PDF, DOCX, XLSX, CSV, PPTX и архивы в соответствии с задачей.
Источник HTML в сравнении с отображаемой страницей
Скопированный источник представляет только то, что вы предоставили. Могут быть пропущены ресурсы, вставленные после запуска JavaScript, контент, загруженный после прокрутки, или URL-адреса, созданные во время взаимодействия.
Используйте автономный экстрактор для фрагментов исходного кода, экспортированного HTML, шаблонов электронной почты и проверки кода. Используйте расширение GrabAll для интерактивной визуализации страниц и рабочих процессов с контекстом браузера.
Проверка перед загрузкой
Дедублируйте список, проверьте домены и протестируйте небольшую выборку. Соответствующее расширение в URL-адресе не гарантирует, что ответ действителен или что вы имеете право его использовать.
Избегайте автоматического запроса больших непроверенных списков. Проверка предотвращает неработающие ссылки, нежелательные конечные точки отслеживания и ненужную нагрузку.
Часто задаваемые вопросы
Может ли экстрактор разрешить ../ относительный ссылки?
Да, если вы указываете исходный URL-адрес страницы в качестве базового адреса.
Включает ли извлечение HTML изображения srcset?
Инструмент GrabAll проверяет общие атрибуты источника и адаптивного изображения, включая кандидатов в srcset.
Почему в скопированном HTML отсутствуют некоторые файлы живых страниц?
JavaScript может добавлять их после начальной загрузки HTML. Используйте расширение интерактивного браузера для отображения и динамической загрузки содержимого страницы.
Все ли извлеченные URL-адреса безопасны для загрузки?
Нет. Прежде чем использовать список результатов, просмотрите домены, типы файлов, разрешения и небольшой образец.
GrabAll сканирует страницу и объединяет изображения, документы, мультимедиа и другие загружаемые файлы в один понятный список, чтобы вы могли точно выбрать, что сохранять.