
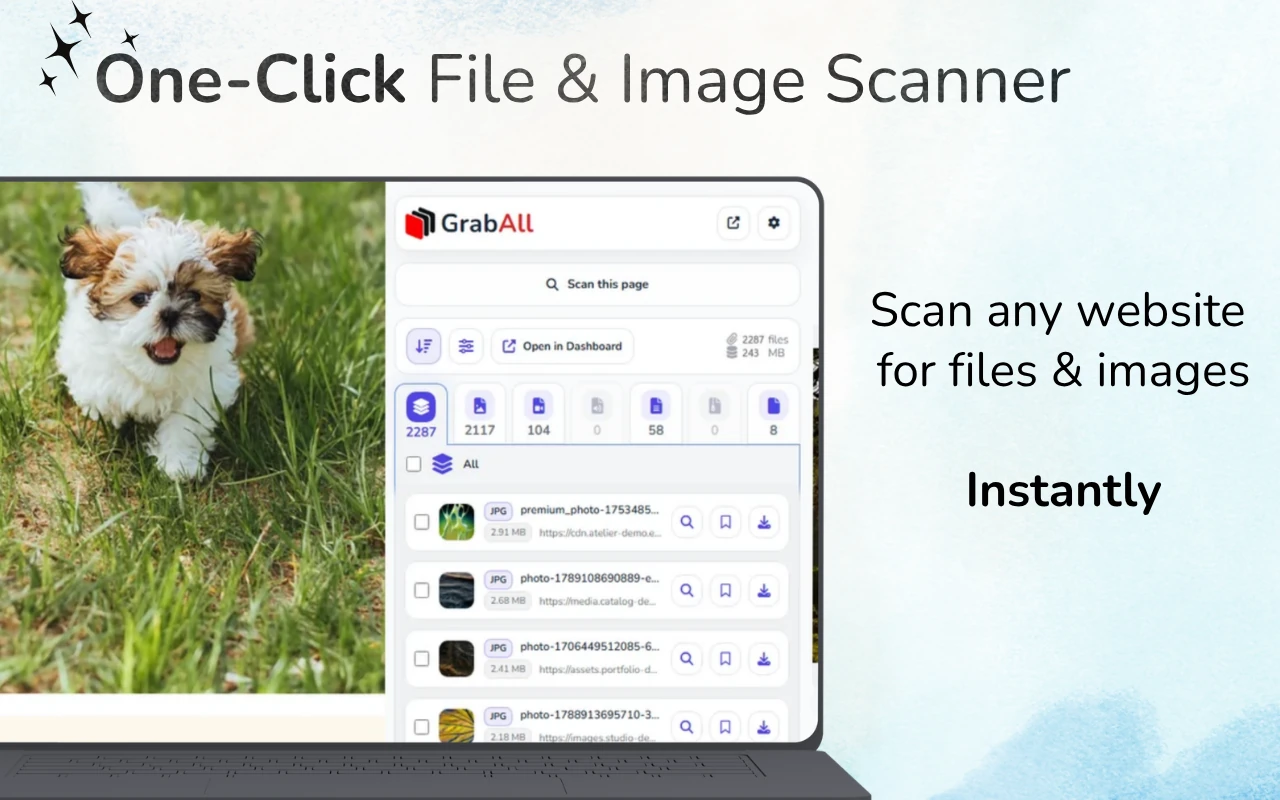
Hiter odgovor: Za živo spletno stran skenirajte z GrabAll in kopirajte zaznane povezave do datotek. Za shranjeni HTML ali kopirano izvorno kodo jo prilepite v Bulk File URL Extractor. Če izvor vsebuje relativne povezave, navedite osnovni URL.
Izberi med skeniranjem strani in razčlenjevanjem prilepljenega HTML-ja
Skeniranje naložene spletne strani lahko najde datoteke, dostopne v brskalniku, medtem ko spletni ekstraktor prebere samo HTML ali besedilo, ki ga prilepite. Izberite metodo, ki ustreza vaši izhodiščni točki, nato preglejte nastale URL-je, preden jih uporabite za prenose.
Kjer se v HTML pojavijo URL-ji datotek
Obične povezave uporabljajo href, medtem ko slike in mediji običajno uporabljajo src. Reactivne slike lahko navajajo več kandidatov v srcset. Knjižnice za leno nalaganje pogosto shranjujejo resnične URL-je v data-src, data-original ali po meri določenih atributih data.
Slogovne tabele in vgrajeni CSS lahko sklicujejo ozadja preko url(). Surovo besedilo lahko prav tako vsebuje popolne URL-je, ki niso priloženi HTML-elementu.
- povezave href
- atributi src in poster
- kandidati srcset in data-srcset
- CSS URL() vrednosti in surovi absolutni URL-ji
Pravilno razrešite relativne poti
Vrednost, kot je ../files/report.pdf, je smiselna samo glede na stran, iz katere izvira HTML. Navedite izvirni URL strani kot osnovo, da lahko izvleček spremeni relativne poti v popolne naslove.
Povezave, relativne glede na protokol, ki se začnejo z //, običajno dedujejo HTTPS na varni strani. Potroot relativne poti, ki se začnejo z /, uporabljajo trenutno izvor spletnega mesta.
- Ohranite URL izvirne strani
- Uporabite ga kot osnovni URL
- Normalizirajte protokol-relativne in korenske relativne poti
- Preglejte razrešene domene, preden uporabite seznam
Filtriraj kandidatne URL-je glede na namen
Ni vsak URL v izvorni kodi prenosljiv vir. Strani vsebujejo navigacijske povezave, API-je, analitiko, pisave, skripte, slogovne liste in sledilne parametre. Filtrirajte po relevantnih razširitvah in pregledujte dvoumne URL-je.
Za slike vključite sodobne formate, kot sta WebP in AVIF. Za dokumente upoštevajte PDF, DOCX, XLSX, CSV, PPTX in arhive glede na nalogo.
HTML vir proti prikazani strani
Kopirana izvorna koda predstavlja le tisto, kar ste vnesli. Lahko zamudi vire, vstavljene po zagonu JavaScripta, vsebino naloženo po pomikanju ali URL-je, ustvarjene med interakcijo.
Uporabite offline ekstraktor za izseke izvorne kode, izvozni HTML, predloge e-pošte in pregled kode. Uporabite razširitev GrabAll za potek tokov v živo upodobljene strani in kontekst brskalnika.
Preverite pred prenosom
Deduplikirajte seznam, pregledajte domene in testirajte majhen vzorec. Ujemajoča se razširitev v URL-ju ne zagotavlja, da je odgovor veljaven ali da ste pooblaščeni za njegovo uporabo.
Izogibajte se samodejnemu zahtevku velikih nerevidiranih seznamov. Validacija preprečuje prekinjene povezave, nezaželene sledenje in nepotrebno obremenitev.
Pogosto zastavljena vprašanja
Ali lahko extractor razreši ../ relativne povezave?
Da, ko kot osnovni naslov podate izvirni URL strani.
Ali ekstrakcija HTML vključuje slike iz srcset?
Orodje GrabAll preverja običajne atribute virov in odzivnih slik, vključno s kandidati srcset.
Zakaj v kopiranem HTML manjkajo nekatere datoteke z živimi stranmi?
JavaScript jih lahko doda po začetnem nalaganju HTML-ja. Uporabite razširitev za brskalnik v živo za upodobljeno in dinamično naloženo vsebino strani.
So vsi pridobljeni URL-ji varni za prenos?
Ne. Pred uporabo seznama rezultatov preglejte domene, vrste datotek, dovoljenja in majhen vzorec.
GrabAll skenira stran in prinese slike, dokumente, medije in druge prenosljive datoteke v en jasen seznam, tako da lahko izberete točno tisto, kar želite shraniti.