
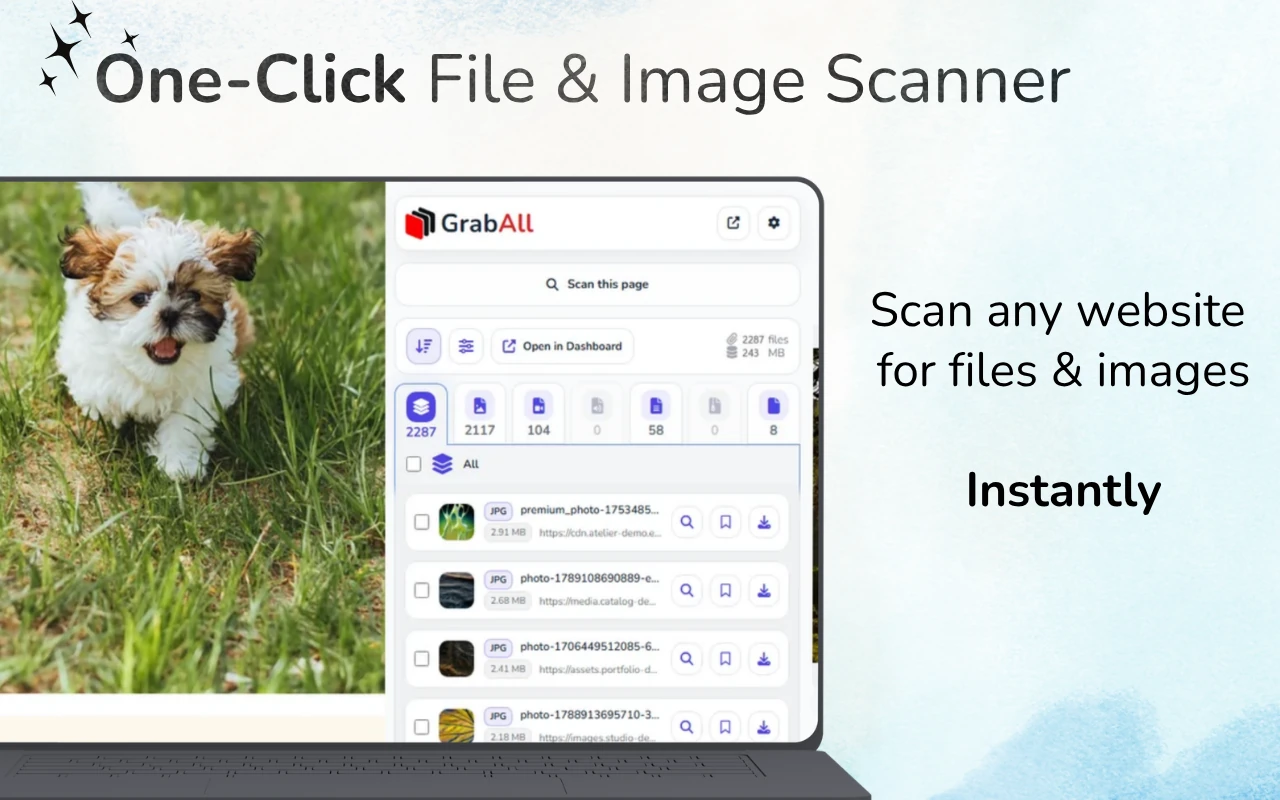
Брз одговор: За живу веб страницу, скенирајте са GrabAll и копирајте откривене фајл линкове. За сачувани HTML или копирани исходни код, налепите га у Bulk File URL Extractor. Наведите базни URL када извор садржи релативне линкове.
Izaberite između skeniranja stranice i parsiranja nalepljenog HTML-a
Скенирање учитане веб странице може пронаћи датотеке доступне у прегледачу, док онлајн екстрактор чита само HTML или текст који залепите. Изаберите метод који одговара вашем почетном месту, затим прегледајте резултујуће URL-ове пре него што их користите за преузимање.
Где се URL-ови фајлова појављују у HTML-у
Обични линкови користе href, док слике и медији обично користе src. Респонзивне слике могу приказати више кандидата у srcset. Лаи-лоад библиотеке често чувају праве URL-ове у data-src, data-original или прилагођеним data атрибутима.
Стилски листови и унутрашњи CSS могу реферисати позадине преко url(). Необрађени текст такође може садржати комплетне URL-ове који нису прикачени за HTML елемент.
- href линкови
- src и poster атрибути
- srcset и data-srcset кандидати
- CSS url() вредности и апсолутне URL адресе у оригиналном облику
Исправно решавајте релативне путање
Vrednost kao što je ../files/report.pdf ima smisla samo u odnosu na stranicu odakle je HTML došao. Podredi originalni URL stranice kao osnovu kako bi ekstraktor mogao da pretvori relativne putanje u potpune adrese.
Protoko-relativni linkovi koji počinju sa // obično nasleđuju HTTPS na sigurnoj stranici. Putanje relativne na koren počinju sa / koriste tekući izvor sajta.
- Чувајте оригинални URL странице извора
- Koristite ga kao osnovni URL
- Нормализујте путеве релативне на протокол и корен
- Прегледајте решене домене пре коришћења листе
Filtriraj kandidat URL-ove po nameni
Ниједан URL у изворном коду није аутоматски преузимљиви ресурс. Странице садрже навигационе линкове, API-је, аналитике, фонтове, скрипте, стилове и пратилачке параметре. Филтрирајте по релевантним екстензијама и прегледајте неодређене URL-ове.
За слике, укључите модерне формате као што су WebP и AVIF. За документе, размотрите PDF, DOCX, XLSX, CSV, PPTX и архиве према задатку.
HTML извор у односу на приказану страницу
Копирани извор представља само оно што сте доставили. Могу бити пропуштени ресурси који су додати након покретања ЈаваСкрипта, садржај учитан након скроловања или URL адресе креиране током интеракције.
Koristite offline ekstraktor za izvore odeljaka, izvezeni HTML, šablone e-pošte i pregled koda. Koristite GrabAll ekstenziju za uživo renderovane stranice i radne tokove u kontekstu pregledača.
Proverite pre preuzimanja
Уклоните дупликате са листе, проверите домене и тестирајте мали узорак. Подударајуће проширење у URL-у не гарантује да је одговор важећи или да имате овлашћење за његово коришћење.
Избегавајте аутоматско захтевање великих непроверених спискова. Валидација спречава покварене линкове, непожељне пратиоце и непотребно оптерећење.
Често постављана питања
Može li ekstraktor rešavati ../ relativne linkove?
Да, када наведете оригинални URL странице као базну адресу.
Да ли HTML екстракција укључује srcset слике?
Алат GrabAll проверава уобичајене атрибуте извора и респонзивне слике, укључујући и кандидате за srcset.
Зашто неки фајлови са живе странице недостају у копираном HTML-у?
JavaScript их може додати након што се почетни HTML учита. Користите проширење за прегледач у реалном времену за рендеровани и динамички учитани садржај странице.
Да ли су сви извађени URL-ови безбедни за преузимање?
Не. Прегледајте домене, типове фајлова, дозволе и мали узорак пре коришћења листе резултата.
GrabAll скенира страницу и доноси слике, документе, медије и друге датотеке доступне за преузимање у јасан списак, тако да можете изабрати тачно шта да сачувате.