
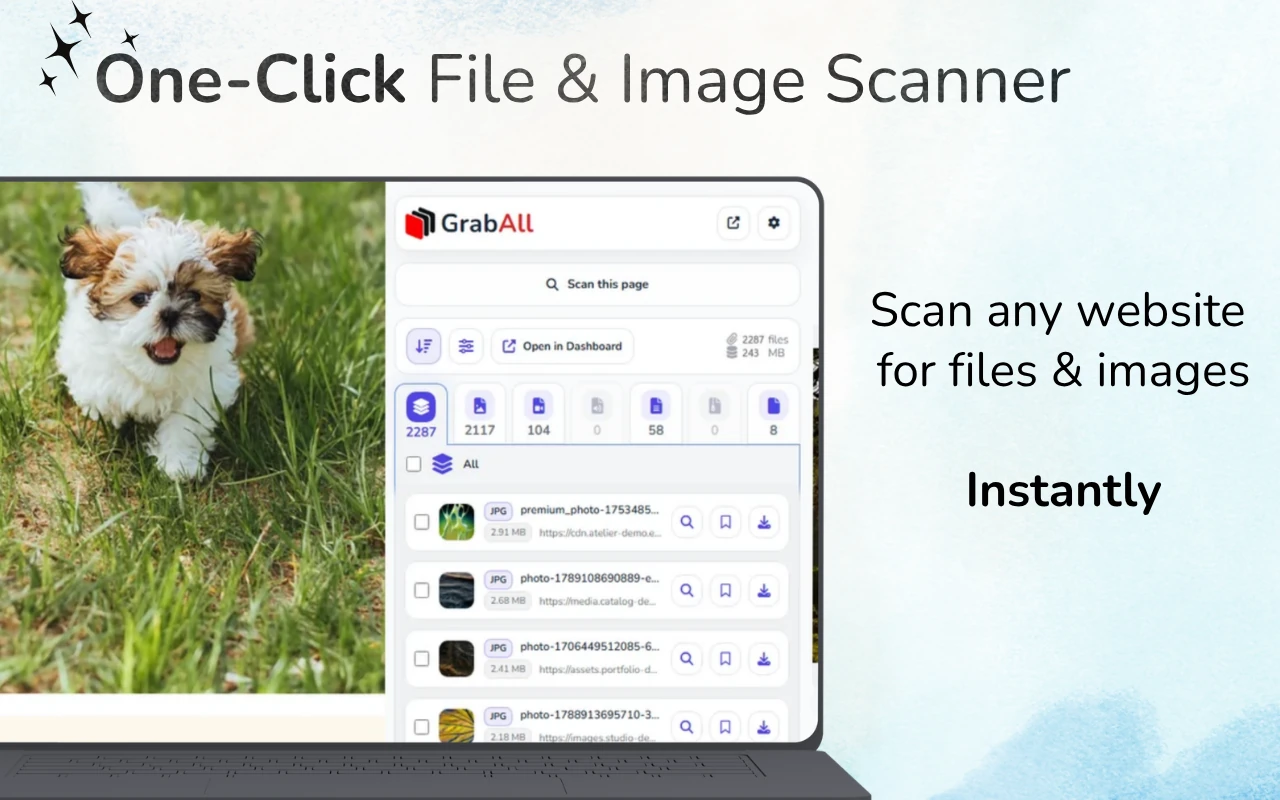
త్వరిత సమాధానం: లైవ్ వెబ్పేజీ కోసం, GrabAll తో స్కాన్ చేసి గుర్తించబడిన ఫైల్ లింక్లను కాపీ చేయండి. సేవ్ చేసిన HTML లేదా కాపీ చేసిన సోర్స్ కోడ్ కోసం, దాన్ని బల్క్ ఫైల్ URL ఎక్స్ట్రాక్టర్లో పేస్ట్ చేయండి. మూలం సాపేక్ష లింక్లను కలిగి ఉంటే బేస్ URL అందించండి.
పేజీని స్కాన్ చేయడం మరియు పేస్ట్ చేసిన HTMLను పార్స్ చేయడంలో ఎంచుకోండి
లోడ్ చేసిన వెబ్పేజీని స్కాన్ చేయడం బ్రౌజర్లో అందుబాటులో ఉన్న ఫైల్స్ని కనుగొనవచ్చు, ఆన్లైన్ ఎక్స్ట్రాక్టర్ కేవలం మీరు పేస్ట్ చేసిన HTML లేదా టెక్స్ట్ని చదువుతుంది. మీ ఆరంభ బిందువుతో సరిపోయే విధానాన్ని ఎంచుకొని, తరువాత వాటిని డౌన్లోడ్ కోసం ఉపయోగించే ముందు ఫలిత URLsను సమీక్షించండి.
ఫైల్ URLs HTMLలో ఏ ప్రదేశంలో కనిపిస్తాయి
సాధారణ లింక్లు hrefని ఉపయోగిస్తాయి, ఇమేజ్లు మరియు మీడియా సాధారణంగా srcని ఉపయోగిస్తాయి. రిస్పాన్సివ్ ఇమేజ్లు srcsetలో పలు అభ్యర్థులను జాబ్ చేస్తాయి. లేజీ లోడింగ్ లైబ్రరీస్ నిజమైన URLsలను data-src, data-original లేదా కస్టమ్ డేటా లక్షణాల్లో తరచుగా నిల్వ చేస్తాయి.
స్టైల్షీట్లు మరియు ఇన్లైన్ CSS url() ద్వారా బ్యాక్గ్రౌండ్లను సూచించవచ్చు. రా టెక్స్ట్ కూడా HTML ఎలిమెంట్కు జోడించబడని పూర్తిస్థాయి URLsలను కలిగి ఉండవచ్చు.
- href లింక్లు
- src మరియు poster గుణాత్మకతలు
- srcset మరియు data-srcset అభ్యర్థులు
- CSS url() విలువలు మరియు_raw absolute URLs
సాపేక్ష మార్గాలను సరియైనుగా పరిష్కరించండి
../files/report.pdf వంటి విలువ, HTML వచ్చిన పేజీకి సంబంధించి మాత్రమే అర్థవంతంగా ఉంటుంది. ఎక్స్ట్రాక్టర్ సంబంధిత మార్గాలను పూర్తి చిరునామాలుగా మార్చేందుకు అసలు పేజీ URLను బేస్గా ఇవ్వండి.
// తో ప్రారంభమయ్యే ప్రోటోకాల్-సాపేక్ష లింక్లు సాధారణంగా ఒక సురక్షిత పేజీలో HTTPS ను వారసత్వంగా పొందుతాయి. / తో ప్రారంభమయ్యే రూట్-సాపేక్ష మార్గాలు ప్రస్తుత వెబ్సైట్ మూలాన్ని ఉపయోగిస్తాయి.
- అసలు సోర్స్ పేజీ URL ను ఉంచండి
- దీన్ని బేస్ URL గా ఉపయోగించండి
- ప్రోటోకాల్-సాపేక్ష మరియు రూట్-సాపేక్ష మార్గాలను సాధారణీకరించండి
- జాబితాను ఉపయోగించే ముందు పరిష్కరించిన డొమైన్లను సమీక్షించండి
ఇచ్చిన అభ్యర్థులను ఉద్దేశ్యానుసారం ఫిల్టర్ చేయండి URLs
అన్ని URL ఉన్నాయి అని సోర్స్ కోడ్లో డౌన్లోడ్ చేయదగిన ఆస్తి కాదు. పేజీలు నావిగేషన్ లింక్లు, APIs, విశ్లేషణలు, ఫాంట్లు, స్క్రిప్ట్లు, స్టైల్షీట్లు మరియు ట్రాకింగ్ పరామితులు కలిగి ఉంటాయి. సంబంధిత విస్తరణల ద్వారా ఫిల్టర్ చేసి ద్వంద్వమయమైన URLs ను పరిశీలించండి.
చిత్రాల కోసం, WebP మరియు AVIF వంటి ఆధునిక ఫార్మాట్లను చేర్చండి. డాక్యుమెంట్ల కోసం, పని ప్రకారం PDF, DOCX, XLSX, CSV, PPTX, మరియు ఆర్కైవ్లను పరిగణనలోకి తీసుకోండి.
HTML సోర్స్లు మరియు రిప్రజెంటేడ్ పేజీ
నకలు చేసిన స్రవంతి మీరు అందించినది మాత్రమే ప్రాతినిధ్యం వహిస్తుంది. ఇది జావాస్క్రిప్ట్ నడిచిన తర్వాత చేర్చిన వనరులను, స్క్రోల్ తర్వాత లోడ్ చేసిన కంటెంట్ను లేదా ఇంటరాక్షన్ సమయంలో సృష్టించబడిన URLs ను మిస్ కావచ్చు.
స్రవంతి స్నిపెట్ల కోసం ఆఫ్లైన్ ఎక్స్ట్రాక్టర్ను ఉపయోగించండి, ఎగుమతి చేసిన HTML, ఇమెయిల్ టెంప్లేట్లు మరియు కోడ్ సమీక్ష. లైవ్ రీడరెడ్ పేజీ మరియు బ్రౌజర్-కాంటెక్స్ వర్క్ఫ్లో కోసం GrabAll విస్తరణను ఉపయోగించండి.
డౌన్లోడ్ చేయడానికి ముందు ధృవీకరించండి
జాబితాను డెడుప్లికేట్ చేయండి, డొమైన్లను పరిశీలించండి, మరియు చిన్న నమూనాను పరీక్షించండి. URLలో స్థిరమైన విస్తరణ ఉండటం ప్రతిస్పందన సరైనదని లేదా మీరు దీన్ని ఉపయోగించడానికి అధికారం కలిగినట్లుగా హామీ ఇవ్వదు.
స్వయంచాలకంగా పెద్దగా సమీక్షలేని జాబితాలను అడగడం నివారించండి. ధృవీకరణ లింక్ ల్లో బ్రేక్, అనవసర ట్రాకింగ్ ఎండ్పాయింట్లు, మరియు అవసరం లేని లోడును నివారిస్తుంది.
తరచుగా అడిగే ప్రశ్నలు
ఎక్స్ట్రాక్టర్ ../ రిలేటివ్ లింక్లను పరిష్కరించగలదా?
అవును, మీరు అసలు పేజీ URL ను బేస్ అడ్రస్గా అందిస్తే.
HTML ఎక్స్ట్రాక్షన్లో srcset చిత్రాలు ఉంటాయా?
GrabAll టూల్ సాధారణ సోర్స్ మరియు రెస్పాన్సివ్-ఇమేజ్ లక్షణాలను, srcset అభ్యర్థులను కూడా తనిఖీ చేస్తుంది.
కాపీ చేయబడిన HTML నుండి కొన్నిlive-page ఫైళ్లేమీ కనపడుట ఎందుకు?
JavaScript అవి ప్రారంభ HTML లోడ్ అయిన తర్వాత జోడించవచ్చు. రీయండర్డ్ మరియు డైనమిక్గా లోడ్ అయిన పేజీ కంటెంట్ కోసం లైవ్ బ్రౌజర్ ఎక్స్టెన్షన్ని ఉపయోగించండి.
ఎ extracted URLs డౌన్లోడ్ చేసుకోవడం సరైనదేనా?
కాదు. ఫలిత జాబితాను ఉపయోగించే ముందు డొమైన్లు, ఫైల్ రకాలూ, అనుమతులు మరియు చిన్న నమూనాను సమీక్షించండి.
GrabAll పేజీని స్కాన్ చేసి, చిత్రాలు, డాక్యుమెంట్లు, మీడియా మరియు ఇతర డౌన్లోడ్ చేయగల ఫైళ్ళను ఒక స్పష్టమైన జాబితాలోకి తెస్తుంది, కాబట్టి మీరు నిశ్చితంగా ఏది సేవ్ చేయాలో ఎంచుకోవచ్చు.