
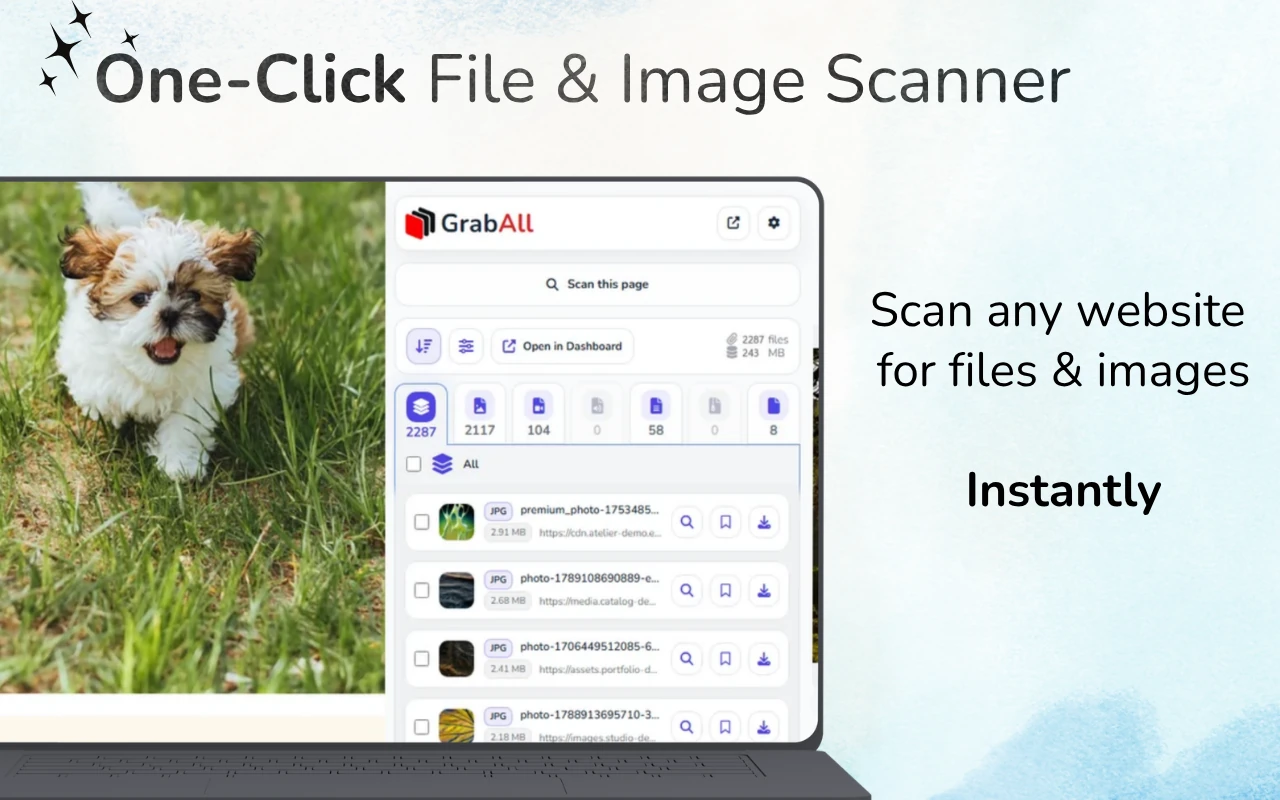
Trả lời nhanh: Đối với một trang web trực tiếp, quét bằng GrabAll và sao chép các liên kết tệp được phát hiện. Đối với HTML đã lưu hoặc mã nguồn đã sao chép, dán vào Công cụ Trích xuất URL Tệp Hàng loạt. Cung cấp URL cơ sở khi nguồn chứa liên kết tương đối.
Chọn giữa quét một trang và phân tích HTML đã dán
Việc quét một trang web đã tải có thể tìm các tệp có sẵn trong trình duyệt, trong khi trình trích xuất trực tuyến chỉ đọc HTML hoặc văn bản bạn dán. Chọn phương pháp phù hợp với điểm bắt đầu của bạn, sau đó xem lại các URL kết quả trước khi sử dụng chúng để tải xuống.
URL tệp xuất hiện ở đâu trong HTML
Các liên kết thông thường sử dụng href, trong khi hình ảnh và media thường sử dụng src. Hình ảnh đáp ứng có thể liệt kê nhiều lựa chọn trong srcset. Các thư viện tải chậm thường lưu URL thực trong data-src, data-original hoặc các thuộc tính dữ liệu tùy chỉnh.
Các bảng kiểu và CSS nội tuyến có thể tham chiếu nền qua url(). Văn bản thô cũng có thể chứa URL đầy đủ không gắn với phần tử HTML.
- liên kết href
- Thuộc tính src và poster
- Ứng viên srcset và data-srcset
- Giá trị url() trong CSS và URL tuyệt đối thô
Giải quyết chính xác đường dẫn tương đối
Một giá trị như ../files/report.pdf chỉ có ý nghĩa so với trang mà HTML đến từ đó. Cung cấp URL trang gốc như cơ sở để công cụ trích xuất có thể biến đường dẫn tương đối thành địa chỉ đầy đủ.
Các liên kết tương đối theo giao thức bắt đầu bằng // thường kế thừa HTTPS trên một trang bảo mật. Các đường dẫn tương đối từ gốc bắt đầu bằng / sử dụng nguồn gốc của trang web hiện tại.
- Giữ URL trang nguồn gốc
- Sử dụng nó làm URL cơ sở
- Chuẩn hóa các đường dẫn tương đối với giao thức và đường dẫn gốc
- Xem lại các miền đã giải quyết trước khi sử dụng danh sách
Lọc các URL tiềm năng theo ý định
Không phải URL nào trong mã nguồn cũng là tài sản có thể tải. Trang chứa các liên kết điều hướng, API, phân tích, phông chữ, script, stylesheet và các tham số theo dõi. Lọc theo các phần mở rộng liên quan và kiểm tra các URL mơ hồ.
Đối với hình ảnh, bao gồm các định dạng hiện đại như WebP và AVIF. Đối với tài liệu, xem xét PDF, DOCX, XLSX, CSV, PPTX và các lưu trữ theo nhiệm vụ.
Nguồn HTML so với trang đã được hiển thị
Nguồn sao chép chỉ đại diện cho những gì bạn cung cấp. Nó có thể thiếu các tài nguyên được chèn sau khi JavaScript chạy, nội dung tải sau khi cuộn, hoặc URL được tạo trong quá trình tương tác.
Sử dụng trình trích xuất ngoại tuyến cho các đoạn nguồn, HTML xuất ra, mẫu email và xem xét mã. Sử dụng tiện ích GrabAll cho trang được kết xuất trực tiếp và các quy trình làm việc trong trình duyệt.
Xác thực trước khi tải xuống
Loại bỏ các mục trùng lặp trong danh sách, kiểm tra các miền và thử nghiệm một mẫu nhỏ. Việc mở rộng khớp trong URL không đảm bảo rằng phản hồi là hợp lệ hoặc bạn được phép sử dụng.
Tránh tự động yêu cầu các danh sách lớn chưa được kiểm tra. Việc xác thực ngăn chặn các liên kết hỏng, các điểm theo dõi không mong muốn và tải trọng không cần thiết.
Câu hỏi thường gặp
Trình trích xuất có thể giải quyết liên kết tương đối ../ không?
Vâng, khi bạn cung cấp URL trang gốc làm địa chỉ cơ sở.
Việc trích xuất HTML có bao gồm hình ảnh srcset không?
Công cụ GrabAll kiểm tra các thuộc tính nguồn phổ biến và hình ảnh phản hồi, bao gồm các ứng viên srcset.
Tại sao một số tệp trên trang trực tiếp lại bị thiếu trong HTML đã sao chép?
JavaScript có thể thêm chúng sau khi HTML ban đầu được tải. Sử dụng tiện ích mở rộng trình duyệt trực tiếp để xem nội dung trang được hiển thị và tải động.
Tất cả các URL đã trích xuất có an toàn để tải xuống không?
Không. Xem lại các tên miền, loại tập tin, quyền truy cập và một mẫu nhỏ trước khi sử dụng danh sách kết quả.
GrabAll quét trang và đưa hình ảnh, tài liệu, phương tiện và các file có thể tải xuống khác vào một danh sách rõ ràng, để bạn có thể chọn chính xác những gì muốn lưu.