

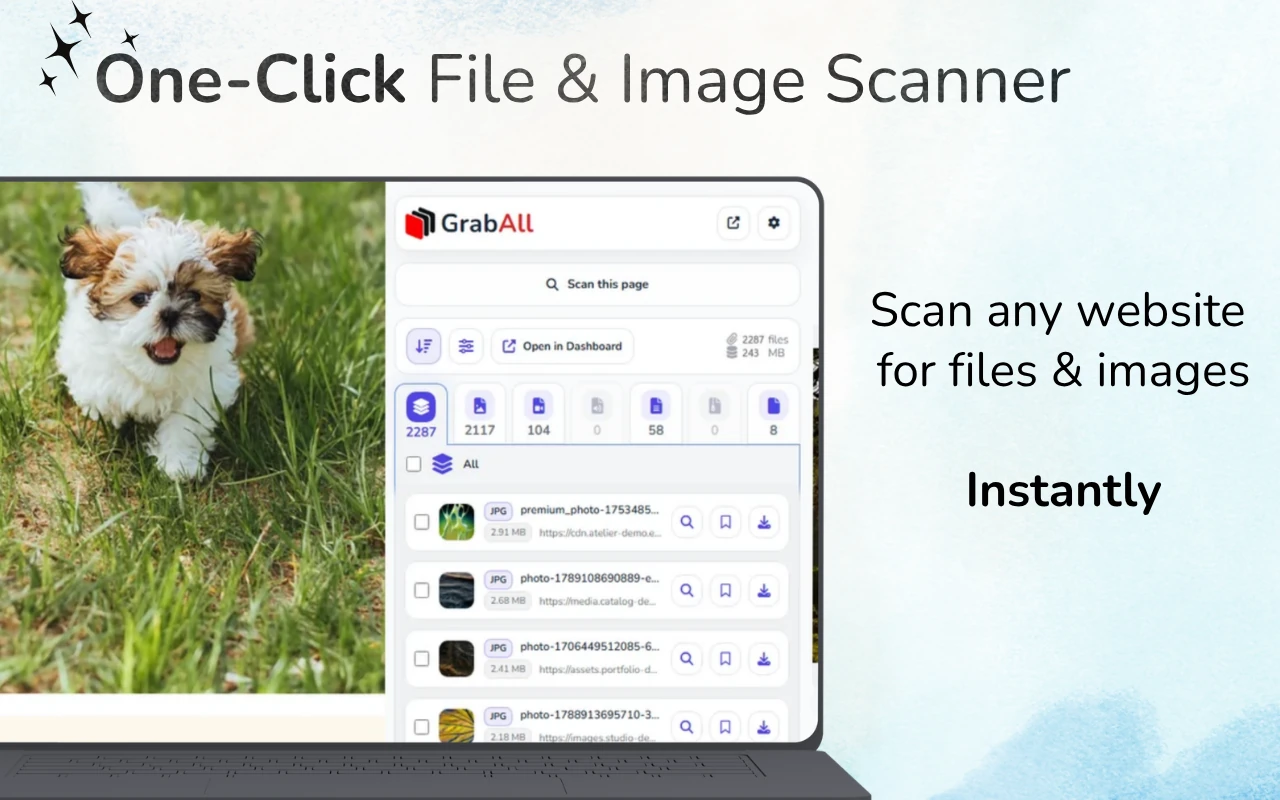
Rychlá odpověď: Otevřete webovou stránku, načtěte příslušný obsah a naskenujte jej pomocí GrabAll. Filtrujte zjištěné soubory podle typu nebo velikosti, zkontrolujte náhledy a názvy souborů a poté uložte nebo zkopírujte vybrané odkazy. Některé zdroje se objeví až po interakci se stránkou.
Hledá odkazy na soubory na načtené stránce
Tlačítka stahování, seznamy dokumentů, obrázkové karty a prvky médií – to vše může odhalit soubory. Začněte načtením části obsahující zdroje, poté naskenujte a zkontrolujte výsledky. Skener může vypsat pouze zdroje, které stránka zpřístupní prohlížeči.
Co se počítá jako soubor ke stažení
Soubor ke stažení může být odkazovaný dokument, zdroj obrázku, mediální prvek, archiv, tabulka nebo jiný veřejný zdroj, na který stránka odkazuje. Prohlížeč musí o zdroji vědět dost, aby si jej vyžádal nebo zobrazil.
Zjištění souborů neznamená průzkum serveru. GrabAll pracuje s aktuální stránkou a dodanými adresami URL, nikoli se soukromými adresáři nebo neuvedeným obsahem serveru.
- Ukotvení odkazů na dokumenty a archivy
- Image src, src-set,set
- Video, zvuk, plakát a zdrojové prvky
- Veřejné adresy URL souborů přítomné v textu stránky nebo atributech dat
Strukturovaný proces zjišťování
Naskenujte nejdříve nejrelevantnější stránku. Seskupte výsledky podle typu a poté zkontrolujte přípony souborů, rady MIME, rozměry, velikosti a zdrojové domény. Použijte náhledy tam, kde jsou k dispozici.
Pokud je stránka dynamická. Vyhněte se procházení nesouvisejícími oblastmi, protože to může do sady výsledků přidat doporučení a navigační prvky.
- Vyberte konkrétní stránku
- Načtěte obsah relevantní pro daný úkol
- Skenovat a seskupovat výsledky podle typu
- Filtrování, náhled a výběr užitečných souborů
Adresy URL bez zjevných přípon
Některá stahování používají cesty jako /download?id=123 namísto názvů souborů končících na .pdf nebo .zip. Tyto odkazy může být obtížnější klasifikovat, než server odpoví. Další informace mohou poskytnout štítky stránek, záhlaví odpovědí a chování při stahování prohlížeče.
Nepředpokládejte, že každá dlouhá URL je soubor. Sledování, navigace a odkazy API mohou vypadat podobně.
Kdy je skenování lepší než prohlížení zdroje
Zobrazení zdrojového kódu HTML může pomoci technickým uživatelům, ale moderní stránky často přidávají obsah po prvním načtení dokumentu. Rozšíření prohlížeče může zkontrolovat vykreslený kontext a prezentovat výsledky v rozhraní zaměřeném na recenze.
Pro vložený HTML nebo offline zdroj použijte bezplatný Bulk File URL Extractor. Pro živou stránku použijte GrabAll, abyste mohli kombinovat objevování s náhledy a výběrem stahování.
Nastavit realistická očekávání
Soubory za autentizací, generované po chráněných voláních API, uložené v soukromých systémech nebo doručené prostřednictvím DRM jsou mimo rozsah běžného skeneru stránek. Respektujte pravidla přístupu a používejte oficiální kontroly stahování tam, kde jsou k dispozici.
Nejlepší výsledky pocházejí ze stránek, které záměrně odhalují odkazy na zdroje, galerie, přílohy, dokumenty nebo běžné mediální soubory.
Často kladené otázky
Může GrabAll najít soubory, které nejsou na stránce propojeny?
Ne. Organizuje zdroje a odkazy dostupné prohlížeči; neprohledává adresáře soukromých serverů ani neodhaluje neexponované soubory.
Mám skenovat domovskou stránku nebo konkrétní stránku?
Používejte co nejkonkrétnější stránku. Produkuje méně nesouvisejících aktiv a čistší výsledky.
Co když adresa URL nemá příponu souboru?
Může stále dojít ke stažení, ale klasifikace je méně spolehlivá, dokud server neodpoví. Zkontrolujte štítek stránky a v případě nejistoty použijte oficiální ovládací prvek.
Mohu místo toho extrahovat odkazy ze zkopírovaného HTML?
Ano. GrabAll poskytuje zdarma Bulk File URL Extractor pro vložený HTML, zdrojový kód a text.
GrabAll prohledá stránku a přenese obrázky, dokumenty, média a další soubory ke stažení do jednoho přehledného seznamu, takže si můžete přesně vybrat, co uložit.