
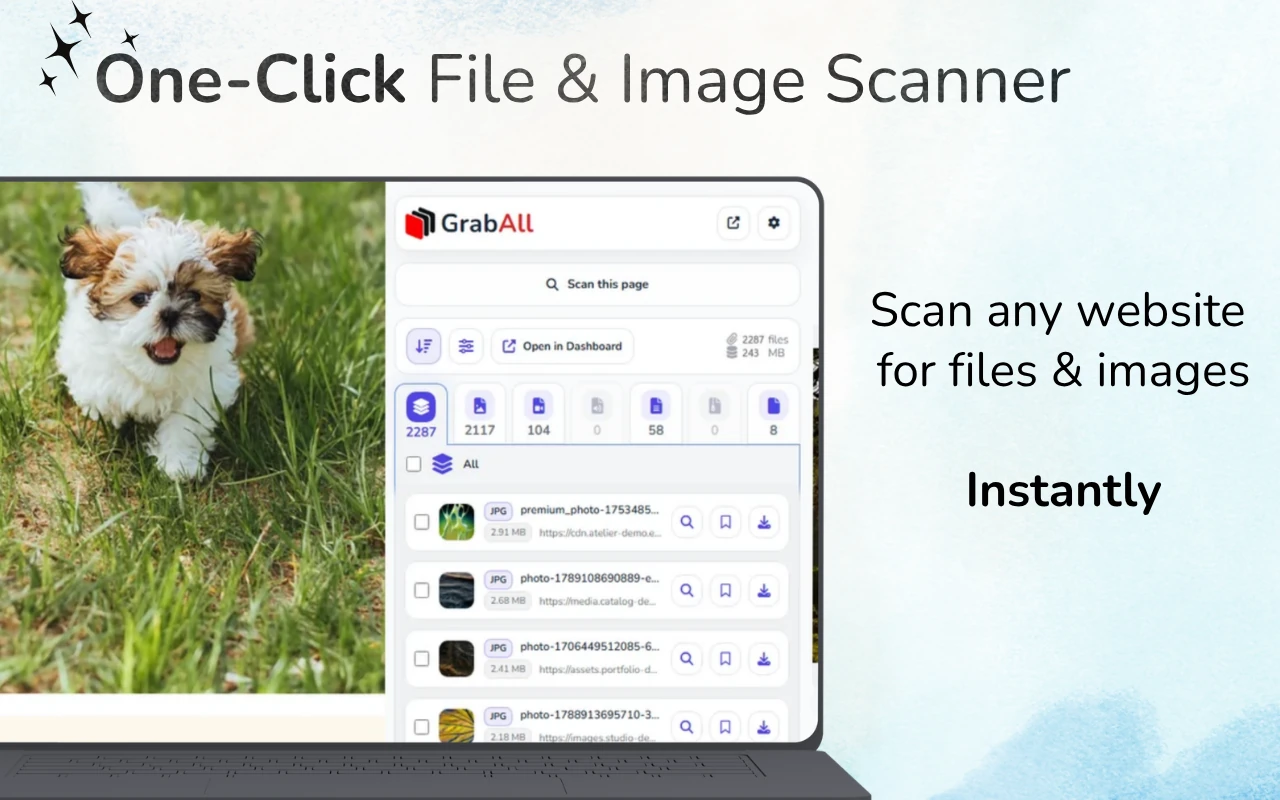
Schnelle Antwort: Öffnen Sie die Webseite, laden Sie den relevanten Inhalt und scannen Sie ihn mit GrabAll. Filtern Sie erkannte Dateien nach Typ oder Größe, überprüfen Sie Vorschauen und Dateinamen und speichern oder kopieren Sie dann die ausgewählten Links. Einige Ressourcen werden erst nach einer Seiteninteraktion angezeigt.
Suchen Sie nach Dateilinks auf der geladenen Seite
Download-Schaltflächen, Dokumentlisten, Bildkarten und Medienelemente können alle Dateien freigeben. Laden Sie zunächst den Abschnitt mit den Ressourcen, scannen und überprüfen Sie dann die Ergebnisse. Ein Scanner kann nur Ressourcen auflisten, die die Seite dem Browser zur Verfügung stellt.
Was gilt als herunterladbare Datei
Eine herunterladbare Datei kann ein verknüpftes Dokument, eine Bildquelle, ein Medienelement, ein Archiv, eine Tabelle oder ein anderes öffentliches Asset sein, auf das die Seite verweist. Der Browser muss genug über die Ressource wissen, um sie anzufordern oder anzuzeigen.
Dateierkennung bedeutet nicht, dass der Server untersucht wird. GrabAll funktioniert mit der aktuellen Seite und den bereitgestellten URLs, nicht mit privaten Verzeichnissen oder nicht aufgeführten Serverinhalten.
- Ankerlinks zu Dokumenten und Archiven
- Image src, srcset und Lazy-Load-Attribute
- Video-, Audio-, Poster- und Quellelemente
- Öffentliche Datei-URLs im Seitentext oder in Datenattributen
Ein strukturierter Erkennungsprozess
Scannen Sie zuerst die relevanteste Seite. Gruppieren Sie die Ergebnisse nach Typ und überprüfen Sie dann die Dateierweiterungen, MIME-Hinweise, Abmessungen, Größen und Quelldomänen. Verwenden Sie Vorschauen, sofern verfügbar.
Wenn die Seite dynamisch ist, lassen Sie den relevanten Abschnitt vor dem Scannen laden. Vermeiden Sie das Scrollen durch nicht verwandte Bereiche, da dadurch Empfehlungen und Navigationsressourcen zum Ergebnissatz hinzugefügt werden können.
- Wählen Sie eine bestimmte Seite
- Laden Sie den für die Aufgabe relevanten Inhalt.
- Ergebnisse nach Typ scannen und gruppieren
- Die nützlichen Dateien filtern, in der Vorschau anzeigen und auswählen
URLs ohne offensichtliche Erweiterungen
Einige Downloads verwenden Routen wie /download?id=123 anstelle von Dateinamen, die auf .pdf oder .zip enden. Es kann schwieriger sein, diese Links zu klassifizieren, bevor der Server antwortet. Seitenbezeichnungen, Antwortheader und das Browser-Download-Verhalten können weitere Informationen liefern.
Gehen Sie nicht davon aus, dass jede lange URL eine Datei ist. Tracking-, Navigations- und API-Links können ähnlich aussehen.
Wenn Scannen besser ist als das Anzeigen der Quelle
Das Anzeigen von HTML-Quellen kann technischen Benutzern helfen, aber moderne Seiten fügen häufig Inhalte hinzu, nachdem das erste Dokument geladen wurde. Eine Browser-Erweiterung kann den gerenderten Kontext überprüfen und Ergebnisse in einer bewertungsorientierten Oberfläche präsentieren.
Für eingefügte HTML- oder Offline-Quellen verwenden Sie den kostenlosen Bulk File URL Extractor. Verwenden Sie für die Live-Seite GrabAll, damit Sie die Entdeckung mit Vorschauen und Download-Auswahl kombinieren können.
Legen Sie realistische Erwartungen fest.
Dateien hinter der Authentifizierung, die nach geschützten API-Aufrufen generiert, in privaten Systemen gespeichert oder über DRM bereitgestellt werden, liegen außerhalb des Anwendungsbereichs eines normalen Seitenscanners. Beachten Sie die Zugriffsregeln und nutzen Sie die offiziellen Download-Kontrollen, sofern vorhanden.
Die besten Ergebnisse erzielen Sie mit Seiten, die absichtlich Ressourcenlinks, Galerien, Anhänge, Dokumente oder gewöhnliche Mediendateien offenlegen.
Häufig gestellte Fragen
Kann GrabAll Dateien finden, die nicht auf der Seite verlinkt sind?
Nein. Es organisiert Ressourcen und Links, die dem Browser zur Verfügung stehen. Es durchsucht keine privaten Serververzeichnisse und zeigt keine nicht zugänglichen Dateien an.
Soll ich die Homepage oder eine bestimmte Seite scannen?
Verwenden Sie eine möglichst spezifische Seite. Es führt zu weniger unabhängigen Assets und saubereren Ergebnissen.
Was ist, wenn eine URL keine Dateierweiterung hat?
Es kann immer noch zu einem Download kommen, aber die Klassifizierung ist weniger zuverlässig, bis der Server antwortet. Überprüfen Sie die Seitenbezeichnung und verwenden Sie im Zweifelsfall die offizielle Kontrolle.
Kann ich stattdessen Links aus kopiertem HTML extrahieren?
Ja. GrabAll bietet einen kostenlosen Massendatei-URL-Extraktor für eingefügtes HTML, Quellcode und Text.
GrabAll scannt die Seite und bringt Bilder, Dokumente, Medien und andere herunterladbare Dateien in einer übersichtlichen Liste zusammen, sodass Sie genau auswählen können, was gespeichert werden soll.