
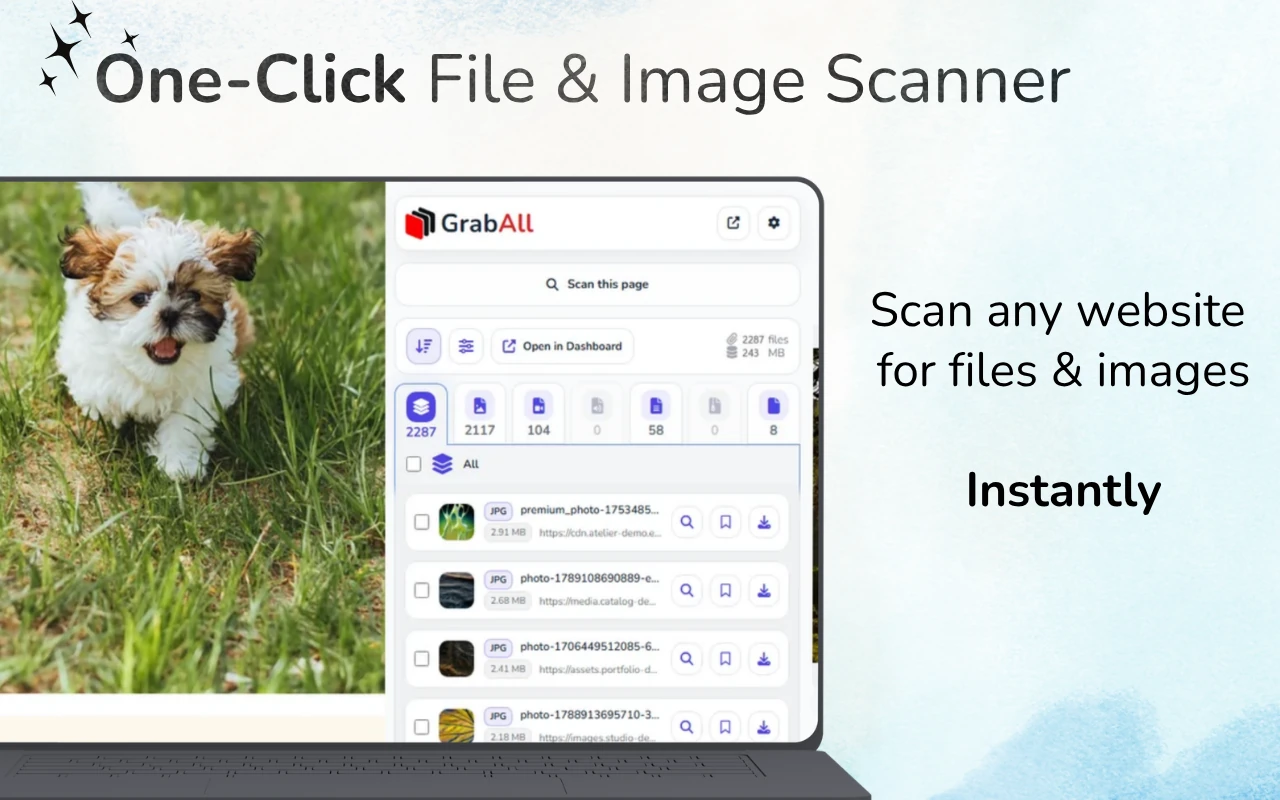
Kiire vastus: Ava veebileht, laadi vajalik sisu ja skaneeri see GrabAlliga. Filtreeri tuvastatud faile tüübi või suuruse järgi, kontrolli eelvaateid ja failinimesid, seejärel salvesta või kopeeri valitud lingid. Mõned ressursid ilmuvad alles pärast lehega suhtlemist.
Otsi faililinke laetud lehelt
Allalaadimise nupud, dokumendiloendid, pildikaardid ja meediaelemendid võivad kõik faile avada. Alusta ressursside sektsiooni laadimisega, seejärel skaneeri ja vaata tulemusi. Skanner saab loetleda ainult need ressursid, mida leht brauserile kättesaadavaks teeb.
Mis loetakse allalaaditavaks failiks
Allalaaditav fail võib olla lingitud dokument, pildiallikas, meediaelement, arhiiv, arvutustabel või mõni muu avalik vara, mida leht viitab. Brauser peab teadma piisavalt ressursist, et seda taotleda või kuvada.
Failide avastamine ei tähenda serveri uurimist. GrabAll töötab praeguse lehe ja esitatud URL-idega, mitte privaatsete kataloogide või registreerimata serverisisuga.
- Dokumentide ja arhiivide lingid
- Piltide src, srcset ja lazy-load atribuudid
- Video-, heli-, plakati- ja allikaelemendid
- Avalikud failide URL-id, mis esinevad lehe tekstis või andmeatribuutides
Struktureeritud avastusprotsess
Skanni kõige olulisem leht esimesena. Grupeeri tulemused tüüpide kaupa, seejärel vaata faililaiendeid, MIME-vihjeid, mõõtmeid, suurusi ja lähte domeene. Kasuta eelvaateid, kus need on saadaval.
Kui leht on dünaamiline, laske vastaval osal enne skannimist laadida. Vältige mitteasjakohaste alade kerimist, kuna see võib lisada soovitusi ja navigeerimisvarasid tulemuste hulka.
- Vali konkreetne leht
- Laadi ülesandega seotud sisu
- Skanni ja grupeerige tulemused tüüpide kaupa
- Filtreeri, eelvaade ja vali kasulikud failid
URL-id ilma ilmsete laienditeta
Mõned allalaadimised kasutavad marsruute, nagu /download?id=123, mitte failinimesid, mis lõpevad .pdf või .zip. Nende linkide klassifitseerimine enne serveri vastust võib olla keerulisem. Lehe sildid, vastuse päised ja brauseri allalaadimise käitumine võivad pakkuda rohkem teavet.
Ära eelda, et iga pikk URL on fail. Jälgimine, navigeerimine ja API lingid võivad välja näha sarnased.
Millal on skaneerimine parem kui lähtekoodi vaatamine
HTML-i lähtekoodi vaatamine võib aidata tehnilisi kasutajaid, kuid tänapäevased lehed lisavad sageli sisu pärast algdokumendi laadimist. Brauserilaiend võib kontrollida renderdatud konteksti ja esitada tulemused ülevaatuseks mõeldud liideses.
Kleepitud HTML-i või võrguühenduseta lähtekoodi puhul kasuta tasuta Bulk File URL Extractorit. Elava lehe puhul kasuta GrabAlli, et saaksid kombineerida avastamise eelvaadete ja allalaadimise valikuga.
Sea realistlikud ootused
autentimise taga olevad failid, mis genereeritakse kaitstud API kõnede järel, salvestatakse privaatsüsteemidesse või edastatakse DRM-i kaudu, jäävad tavapärase leheküljeskanneri ulatusest välja. Austa juurdepääsureegleid ja kasuta ametlikke allalaadimiskontrolle, kus see on olemas.
Parimad tulemused tulevad lehtedelt, mis tahtlikult avalikustavad ressursside lingid, galeriid, manusfailid, dokumendid või tavalised meediafailid.
Korduma kippuvad küsimused
Kas GrabAll leiab faile, mis pole lehel lingitud?
Ei. See korraldab brauserile kättesaadavaid ressursse ja linke; see ei otsi privaatserverite katalooge ega avalda varjatud faile.
Kas peaksin skannima avalehte või konkreetset lehte?
Kasuta võimalikult täpset lehte. See toodab vähem mitteseotud materjale ja puhtamaid tulemusi.
Mis saab, kui URL-il puudub faililaiend?
See võib endiselt alla laadida, kuid klassifitseerimine on vähem usaldusväärne, kuni server vastab. Kontrollige lehe silti ja kasutage ametlikku juhtimist, kui kahtlete.
Kas ma saan selle asemel kopeeritud HTML-ist lingid välja võtta?
Jah. GrabAll pakub tasuta hulgi failide URL-i väljavõtjat kleepimiseks HTML-ist, lähtekoodist ja tekstist.
GrabAll skannib lehte ja koondab pildid, dokumendid, meedia ja muud allalaaditavad failid ühte selgesse nimekirja, nii et saate täpselt valida, mida salvestada.