
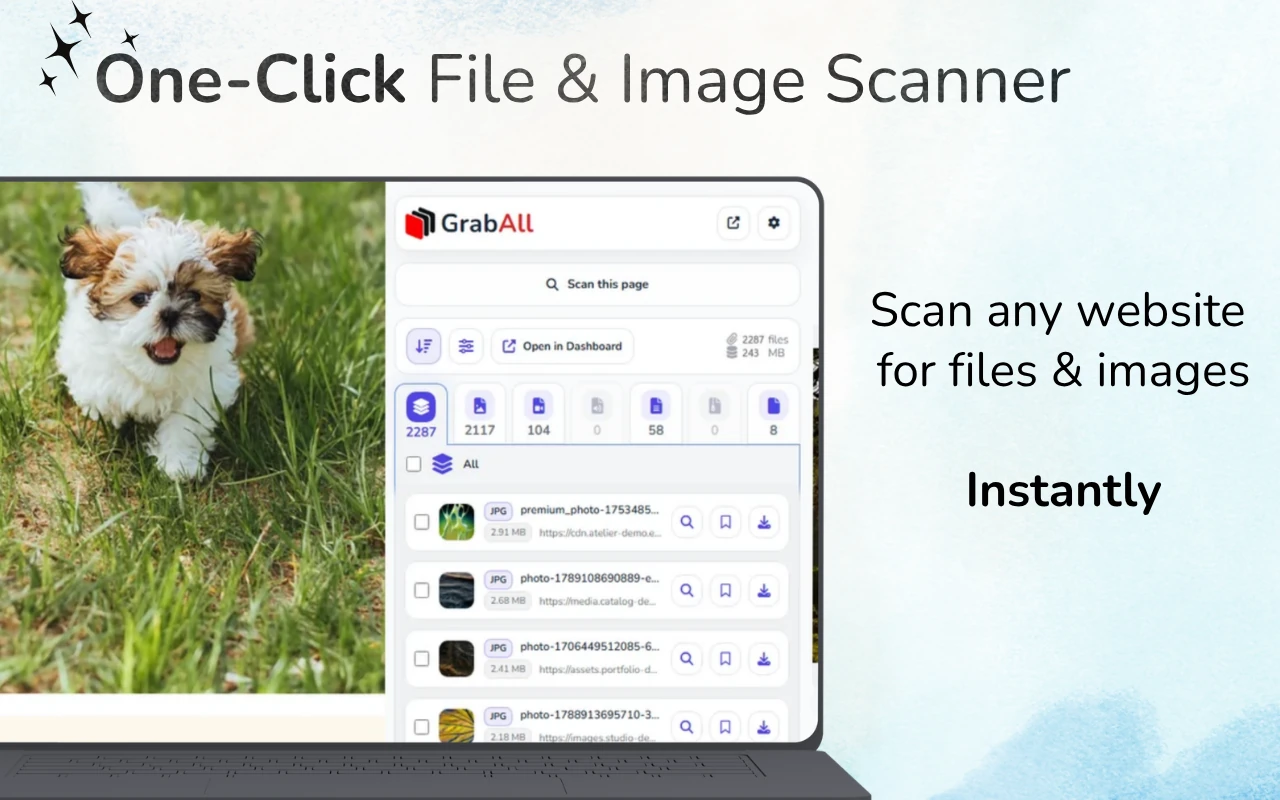
پاسخ سریع: صفحه وب را باز کنید، محتوای مرتبط را بارگذاری کرده و با GrabAll اسکن کنید. فایلهای شناسایی شده را بر اساس نوع یا اندازه فیلتر کنید، پیشنمایشها و نام فایلها را بررسی کنید، سپس لینکهای انتخاب شده را ذخیره یا کپی کنید. برخی منابع فقط بعد از تعامل با صفحه ظاهر میشوند.
دنبال لینکهای فایل در صفحه بارگذاریشده بگردید
دکمههای دانلود، فهرستهای سند، کارتهای تصویر و عناصر رسانهای میتوانند همه فایلها را آشکار کنند. با بارگذاری بخش حاوی منابع شروع کنید، سپس نتیجه را اسکن و مرور کنید. یک اسکنر فقط میتواند منابعی که صفحه در اختیار مرورگر قرار میدهد را فهرست کند.
چه چیزی بهعنوان یک فایل قابل دانلود محسوب میشود
یک فایل قابل دانلود میتواند یک سند پیوندی، یک منبع تصویری، یک عنصر رسانهای، یک آرشیو، یک صفحه گسترده یا دارایی عمومی دیگری باشد که توسط صفحه ارجاع داده شده است. مرورگر باید اطلاعات کافی درباره منبع داشته باشد تا بتواند آن را درخواست کند یا نمایش دهد.
کشف فایل به معنای جستجوی سرور نیست. GrabAll با صفحه فعلی و URLهای ارائه شده کار میکند، نه با دایرکتوریهای خصوصی یا محتویات فهرستنشده سرور.
- پیوندهای لنگری به اسناد و بایگانیها
- ویژگیهای src، srcset و lazy-load تصویر
- عناصر ویدئو، صدا، پوستر و منبع
- URLهای فایل عمومی موجود در متن صفحه یا ویژگیهای داده
یک روند کشف ساختاریافته
ابتدا مرتبطترین صفحه را اسکن کنید. نتایج را بر اساس نوع گروهبندی کنید، سپس پسوند فایلها، نشانههای MIME، ابعاد، اندازهها و دامنههای منبع را بررسی کنید. از پیشنمایشها در دسترس استفاده کنید.
اگر صفحه پویا است، اجازه دهید بخش مربوطه قبل از اسکن بارگذاری شود. از پیمایش در مناطق نامربوط خودداری کنید زیرا این میتواند توصیهها و داراییهای ناوبری را به مجموعه نتایج اضافه کند.
- یک صفحه خاص را انتخاب کنید
- بارگذاری محتوای مرتبط با کار
- اسکن و گروهبندی نتایج بر اساس نوع
- فیلتر، پیشنمایش و انتخاب فایلهای مفید
URLها بدون پسوند مشخص
بعضی دانلودها از مسیرهایی مانند /download?id=123 استفاده میکنند به جای نام فایلهایی که با .pdf یا .zip تمام میشوند. این لینکها قبل از پاسخدهی سرور ممکن است سختتر دستهبندی شوند. برچسبهای صفحه، هدرهای پاسخ، و رفتار دانلود مرورگر میتواند اطلاعات بیشتری ارائه دهد.
فرض نکنید همهی URLهای طولانی فایل هستند. لینکهای پیگیری، ناوبری و API میتوانند مشابه به نظر برسند.
چه زمانی اسکن بهتر از مشاهده منبع است
مشاهده منبع HTML میتواند برای کاربران فنی مفید باشد، اما صفحات مدرن غالباً پس از بارگذاری اولیه مستند، محتوا اضافه میکنند. یک افزونه مرورگر میتواند زمینه رندر شده را بررسی کرده و نتایج را در یک رابط مرور محور ارائه دهد.
برای HTML چسبانده شده یا منبع آفلاین، از Bulk File URL Extractor رایگان استفاده کنید. برای صفحه زنده، از GrabAll استفاده کنید تا بتوانید کشف فایلها را با پیشنمایش و انتخاب دانلود ترکیب کنید.
انتظارات واقعبینانه تعیین کنید
فایلهای پشت احراز هویت، تولید شده پس از فراخوانی API محافظتشده، ذخیره شده در سیستمهای خصوصی یا ارائه شده از طریق DRM خارج از محدوده یک اسکنر معمولی صفحه هستند. قوانین دسترسی را رعایت کنید و در صورت وجود از کنترلهای رسمی دانلود استفاده کنید.
بهترین نتایج از صفحاتی به دست میآید که بهطور عمدی لینکهای منابع، گالریها، ضمیمهها، اسناد یا فایلهای رسانهای معمولی را آشکار میکنند.
سؤالات متداول
آیا GrabAll میتواند فایلهایی را پیدا کند که در صفحه لینک نشدهاند؟
خیر. این برنامه منابع و لینکهای موجود برای مرورگر را سازماندهی میکند؛ این برنامه به دایرکتوریهای خصوصی سرور دسترسی پیدا نمیکند و فایلهای ناشناخته را آشکار نمیکند.
باید از صفحه اصلی اسکن کنم یا صفحه خاصی؟
از اختصاصیترین صفحه ممکن استفاده کنید. این کار داراییهای غیر مرتبط کمتری تولید میکند و نتایج تمیزتری ارائه میدهد.
اگر URL فاقد پسوند فایل باشد چه اتفاقی میافتد؟
ممکن است هنوز دانلود ایجاد شود، اما طبقهبندی تا زمانی که سرور پاسخ دهد کمتر قابل اعتماد است. برچسب صفحه را بررسی کنید و در صورت عدم اطمینان از کنترل رسمی استفاده کنید.
آیا میتوانم لینکها را از HTML کپی شده استخراج کنم؟
بله. GrabAll یک استخراجکننده رایگان URL فایل گروهی برای HTML الصاق شده، کد منبع و متن ارائه میدهد.
GrabAll صفحه را اسکن میکند و تصاویر، اسناد، رسانهها و سایر فایلهای قابل دانلود را در یک فهرست واضح جمعآوری میکند تا بتوانید دقیقاً انتخاب کنید چه چیزی را ذخیره کنید.