
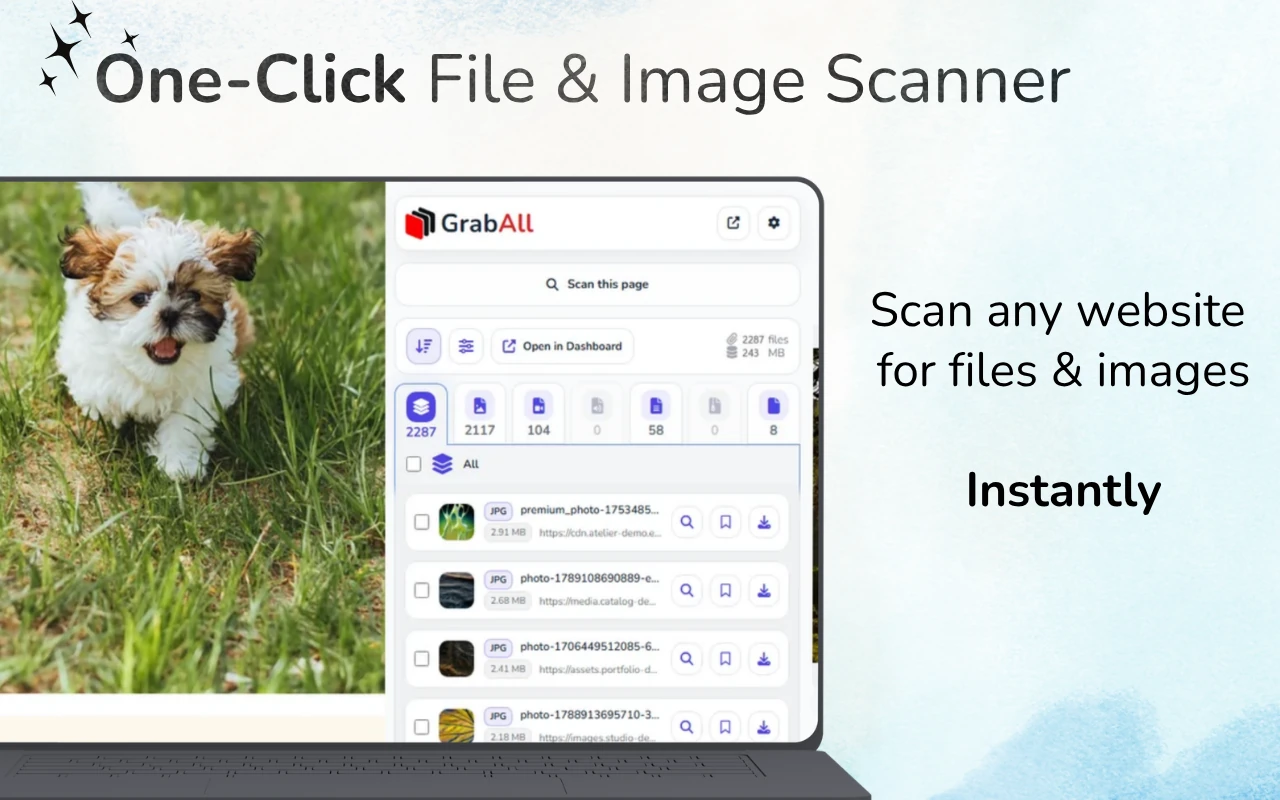
Mabilis na sagot: Buksan ang webpage, i-load ang kaukulang nilalaman at i-scan ito gamit ang GrabAll. I-filter ang natukoy na mga file ayon sa uri o laki, suriin ang mga preview at pangalan ng file, pagkatapos ay i-save o kopyahin ang mga napiling link. Ang ilang resources ay lumilitaw lamang pagkatapos ng interaksyon sa pahina.
Maghanap ng mga link ng file sa na-load na pahina
Ang mga button sa pag-download, listahan ng dokumento, card ng larawan at media elements ay maaaring magpakita ng mga file. Magsimula sa pag-load ng seksyon na naglalaman ng mga resources, pagkatapos ay i-scan at suriin ang mga resulta. Makalista lamang ang scanner ng mga resources na ginagawang available ng pahina sa browser.
Ano ang binibilang bilang isang downloadable na file
Ang isang downloadable na file ay maaaring isang naka-link na dokumento, isang pinagkunan ng imahe, isang media element, isang archive, isang spreadsheet, o ibang pampublikong asset na tinutukoy ng pahina. Dapat malaman ng browser ng sapat tungkol sa resource upang hilingin o ipakita ito.
Ang paghahanap ng file ay hindi nangangahulugang paggalugad ng server. Ang GrabAll ay gumagana sa kasalukuyang pahina at mga ibinigay na URL, hindi sa mga pribadong direktoryo o hindi nakalistang nilalaman ng server.
- Mga anchor link sa mga dokumento at arkibo
- Mga atributong src, srcset, at lazy-load ng larawan
- Video, audio, poster, at mga elementong pinagmulan
- Publikong URL ng file na naroroon sa teksto ng pahina o mga data attribute
Isang istrukturadong proseso ng pagtuklas
I-scan muna ang pinaka-nauugnay na pahina. Pag-grupo ng mga resulta ayon sa uri, pagkatapos suriin ang file extensions, MIME hints, dimensyon, sukat, at source domains. Gamitin ang mga preview kung available.
Kung dynamic ang pahina, hayaan munang mag-load ang kaukulang seksyon bago i-scan. Iwasang mag-scroll sa mga di-kaugnay na lugar dahil maaaring magdagdag iyon ng mga rekomendasyon at navigation assets sa resulta.
- Pumili ng partikular na pahina
- I-load ang nilalaman na may kaugnayan sa gawain
- I-scan at pag-grupo ng mga resulta ayon sa uri
- I-filter, tingnan, at piliin ang mga kapaki-pakinabang na file
Mga URL na walang malinaw na extension
Ang ilang downloads ay gumagamit ng mga ruta tulad ng /download?id=123 sa halip na mga filename na nagtatapos sa .pdf o .zip. Ang mga link na ito ay maaaring maging mas mahirap i-classify bago tumugon ang server. Ang page labels, response headers, at browser download behavior ay maaaring magbigay ng karagdagang impormasyon.
Huwag ipalagay na bawat mahabang URL ay isang file. Ang mga tracking, navigation, at API links ay maaaring magmukhang pareho.
Kailan mas mabuti ang pag-scan kaysa sa pagtingin sa source
Makakatulong ang pagtingin sa HTML source sa mga teknikal na gumagamit, ngunit kadalasan ang mga modernong pahina ay nagdaragdag ng nilalaman pagkatapos mag-load ang orihinal na dokumento. Maaari ng browser extension na suriin ang rendered na konteksto at ipakita ang resulta sa isang interface na nakatuon sa pagsusuri.
Para sa na-paste na HTML o offline na source, gamitin ang libreng Bulk File URL Extractor. Para sa live na pahina, gamitin ang GrabAll upang maipagsama mo ang pagtuklas sa preview at pagpili ng download.
Itakda ang makatotohanang mga inaasahan
Ang mga file sa likod ng pagpapatotoo, na nalikha pagkatapos ng protektadong mga tawag sa API, nakaimbak sa pribadong sistema, o ipinadala sa pamamagitan ng DRM ay nasa labas ng saklaw ng normal na scanner ng pahina. Igalang ang mga patakaran sa access at gamitin ang opisyal na kontrol sa pag-download kung ibinigay.
Ang pinakamahusay na resulta ay nagmumula sa mga pahinang sadyang inilalantad ang mga link ng resource, gallery, attachment, dokumento, o ordinaryong media file.
Madalas itanong na mga tanong
Maaari bang hanapin ng GrabAll ang mga file na hindi naka-link sa pahina?
Hindi. Inaayos nito ang mga resources at link na available sa browser; hindi nito hahanapin ang private server directories o ipapakita ang hindi nai-expose na mga file.
Dapat ba akong mag-scan sa homepage o sa isang partikular na pahina?
Gamitin ang pinaka-tukoy na pahina hangga't maaari. Nagbubunga ito ng mas kaunting hindi kaugnay na asset at mas malinis na resulta.
Ano ang gagawin kung ang URL ay walang file extension?
Maaaring mag-download pa rin ito, ngunit hindi gaanong maaasahan ang klasipikasyon hangga't hindi tumutugon ang server. Suriin ang page label at gamitin ang opisyal na kontrol kapag hindi tiyak.
Maaari ko bang kunin ang mga link mula sa kinopyang HTML bilang kapalit?
Oo. Nagbibigay ang GrabAll ng libreng Bulk File URL Extractor para sa na-paste na HTML, source code, at teksto.
Ina-scan ng GrabAll ang pahina at inilalagay ang mga imahe, dokumento, media, at iba pang maida-download na file sa isang malinaw na listahan, upang maaari mong piliin eksakto kung ano ang nais i-save.