

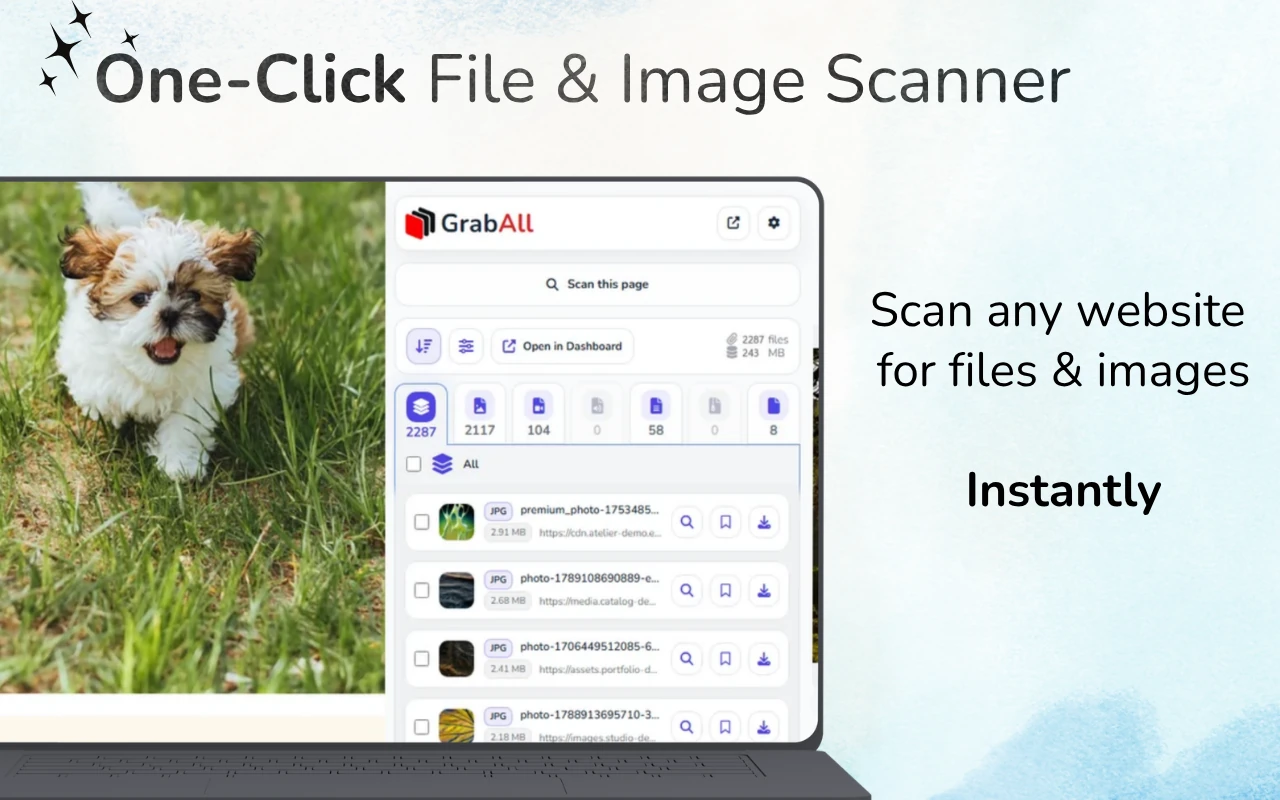
ઝડપી જવાબ: વેબપેજ ખોલો, સંબંધિત સામગ્રી લોડ કરો અને તેને GrabAll સાથે સ્કેન કરો. શોધાયેલા ફાઇલોને પ્રકાર અથવા કદ પ્રમાણે ફિલ્ટર કરો, પૂર્વદર્શન અને ફાઇલ નામ તપાસો, પછી પસંદ કરેલા લિંક્સને સાચવો અથવા નકલ કરો. કેટલીક સંસાધનો માત્ર પેજ ક્રિયાપ્રતિક્રિયાના પછી જ દેખાય છે.
લોડ થયેલ પૃષ્ઠમાં ફાઇલ લિંક્સ માટે જુઓ
ડાઉનલોડ બટન્સ, દસ્તાવેજ યાદીઓ, છબી કાર્ડ અને મીડિયા ელેમેન્ટ્સ બધી ફાઇલો પ્રકાશિત કરી શકે છે. રિસોર્સ ધરાવતા વિભાગને લોડ કરીને શરૂઆત કરો, પછી પરિણામો સ્કેન કરો અને સમીક્ષા કરો. સ્કેનર ફક્ત તે જ રિસોર્સ સૂચિ કરી શકે છે જે પેજ બ્રાઉઝરને ઉપલબ્ધ કરે છે.
ડાઉનલોડ શકાય તેવા ફાઈલ તરીકે શું ગણાય છે
ડાઉનલોડ કરી શકાય એવું ફાઇલ લિંક કરેલ દસ્તાવેજ, છબી સ્ત્રોત, મીડિયા તત્વ, આરકાઇવ, સ્પ્રેડશીટ, અથવા પેજ દ્વારા સંદર્ભિત અન્ય જાહેર સંપત્તિ હોઈ શકે છે. બ્રાઉઝર એ સંસાધન વિશે પૂરતું જાણવું જરૂરી છે જેથી તેને વિનંતી અથવા પ્રદર્શિત કરી શકે.
ફાઇલ શોધનો અર્થ સર્વર અન્વેષણ નથી. GrabAll વર્તમાન પૃષ્ઠ અને આપી URL સાથે કામ કરે છે, ખાનગી ડિરેક્ટરી અથવા અનલિસ્ટેડ સર્વર સામગ્રી સાથે નહીં.
- દસ્તાવેજો અને આર્કાઇવ માટે એંકર લિંક્સ
- ઇમેજ src, srcset, અને લેજી-લોડ એટ્રિબ્યુટ્સ
- વિડિઓ, ઑડિઓ, પોસ્ટર અને સ્રોત તત્વો
- પેજ ટેક્સ્ટ અથવા ડેટા એટ્રિબ્યૂટ્સમાં હાજર જાહેર ફાઇલ URLs
એક સંરચિત શોધ પ્રક્રિયા
સબથી મહત્વપૂર્ણ પેજ પહેલા સ્કાન કરો. પરિણામો પ્રકાર દ્વારા જૂથ કરો, પછી ફાઇલ વિસ્તારો, MIME સૂચનો, માપ, કદ અને સૂત્ર ડોમેઇન્સની તપાસ કરો. જ્યાં ઉપલબ્ધ હોય ત્યાં પૂર્વદર્શનનો ઉપયોગ કરો.
જો પૃષ્ઠ ડાયનેમિક છે, તો સંબંધિત વિભાગ લોડ થવા દો પછી સ્કેન કરો. અનાવશ્યક વિસ્તારોની સ્ક્રોલિંગ ટાળો કારણ કે તે પરિણામ સેટમાં સુપરિશાઓ અને નાવીગેશન એસેટ્સ ઉમેરાવી શકે છે.
- ચોક્કસ પાનું પસંદ કરો
- કાર્યને સંબંધિત સામગ્રી લોડ કરો
- પ્રકાર દ્વારા પરિણામોને સ્કાન અને જૂથબદ્ધ કરો
- પ્રયોગી ફાઇલો ફિલ્ટર, પૂર્વદર્શન અને પસંદ કરો
સ્પષ્ટ એક્સટેંશન વિના URLs
કેટલાક ડાઉનલોડ /download?id=123 જેવા માર્ગોનો ઉપયોગ કરે છે, .pdf અથવા .zipમાં સમાપ્ત થતા ફાઈલ નામોની જગ્યાએ. સર્વર પ્રતિસાદ આપતા પહેલા આ લિંકોને વર્ગીકૃત કરવું વધુ મુશ્કેલ હોઈ શકે છે. પાનું લેબલ, પ્રતિસાદ હેડર્સ અને બ્રાઉઝર ડાઉનલોડ વર્તન વધુ માહિતી આપી શકે છે.
દરેક લાંબી URL ફાઇલ છે તેવી અનુમાન ન લગાવો. ટ્રેકિંગ, નેવિગેશન અને API લિંક્સ પણ સમાન દેખાઈ શકે છે.
જ્યારે સ્કેન કરવું સ્ત્રોત જોવાના કરતાં વધુ સારું છે
એચટીએમએલ સ્રોત જોવાથી તકનીકી વપરાશકર્તાઓને મદદ મળી શકે છે, પરંતુ આધુનિક પૃષ્ઠો પ્રારંભિક દસ્તાવેજ લોડ થયા પછી વારંવાર સામગ્રી ઉમેરે છે. બ્રાઉઝર એક્સ્ટેંશન રેન્ડર કરેલા સંદર્ભનું નિરીક્ષણ કરી શકે છે અને સમીક્ષા-લક્ષી ઇન્ટરફેસમાં પરિણામો રજૂ કરી શકે છે.
પેસ્ટ કરેલા HTML અથવા ઑફલાઇન સોર્સ માટે મફત Bulk File URL Extractor વાપરો. લાઇવ પેજ માટે GrabAll વાપરો જેથી તમે શોધાણ સાથે પ્રિવ્યુ અને ડાઉનલોડ પસંદગી મેળવી શકો.
વાસ્તવિક અપેક્ષાઓ નિર્ધારિત કરો
પ્રમાણપત્ર પાછળની ફાઇલો, સુરક્ષિત API કોલ પછી ઉત્પન્ન થયેલી, ખાનગી સિસ્ટમમાં સંગ્રહિત, અથવા DRM દ્વારા પહોંચાડવામાં આવેલી ફાઇલો સામાન્ય પૃષ્ઠ સ્કેનર ના ક્ષેત્રમાં આતુર નથી. ઍક્સેસ નિયમોનું સમયસર પાલન કરો અને જ્યાં અપાય છે ત્યાં ઓફિશિયલ ડાઉનલોડ નિયંત્રણ ઉપયોગ કરો.
સરસ પરિણામો એવા પૃષ્ઠો પરથી આવે છે જે ઇરાદાપૂર્વક સ્ત્રોત લિંક્સ, ગેલરીઝ, જાહેરો, દસ્તાવેજો અથવા સામાન્ય મીડિયા ફાઇલો પ્રકાશિત કરે છે.
વારંવાર પૂછાતા પ્રશ્નો
શું GrabAll ફાઇલો શોધી શકે છે જે પૃષ્ઠ પર લિંક થયેલ નથી?
નહીં. તે બ્રાઉઝર માટે ઉપલબ્ધ સંસાધનો અને લિંક્સનું આયોજન કરે છે; તે ખાનગી સર્વર ડિરેક્ટરીઓ શોધતું નથી અથવા અનએક્સપોઝ્ડ ફાઇલો જાહેર કરતું નથી.
શું હું હોમપેજ સ્કાન કરું કે વિશિષ્ટ પાનું?
શક્ય તેટલા વિશિષ્ટ પૃષ્ઠનો ઉપયોગ કરો. તે ઓછી અસંબંધિત સંપત્તિ અને સ્વચ્છ પરિણામો ઉત્પન્ન કરે છે.
જો URL પાસે કોઈ ફાઈલ એક્સ્ટેંશન ન હોય તો શું કરવું?
તે હશે તો ડાઉનલોડ કરી શકે છે, પરંતુ વર્ગીકરણ સર્વર પ્રતિક્રિયા આપ્યા ત્યાં સુધી ઓછું વિશ્વસનીય છે. પૃષ્ઠ લેબલની સમીક્ષા કરો અને અનિશ્ચિત ત્યારે સત્તાવાર નિયંત્રણનો ઉપયોગ કરો.
શું હું તેના બદલે નકલ કરેલા એચટીએમએલમાંથી લિંક્સ કાઢી શકું છું?
હા. GrabAll પેસ્ટ કરેલા HTML, સોર્સ કોડ અને ટેક્સ્ટ માટે મફત બલ્ક ફાઇલ યુઆરએલ એક્સટ્રેક્ટર પ્રદાન કરે છે.
GrabAll પૃષ્ઠ સ્કેન કરે છે અને છબીઓ, દસ્તાવેજો, મીડિયા અને અન્ય ડાઉનલોડ કરવા જેવી ફાઈલોને એક ચોક્કસ સૂચિમાં લાવે છે, જેથી તમે ખબરપ્રમાણે એ સાચવી શકો.