

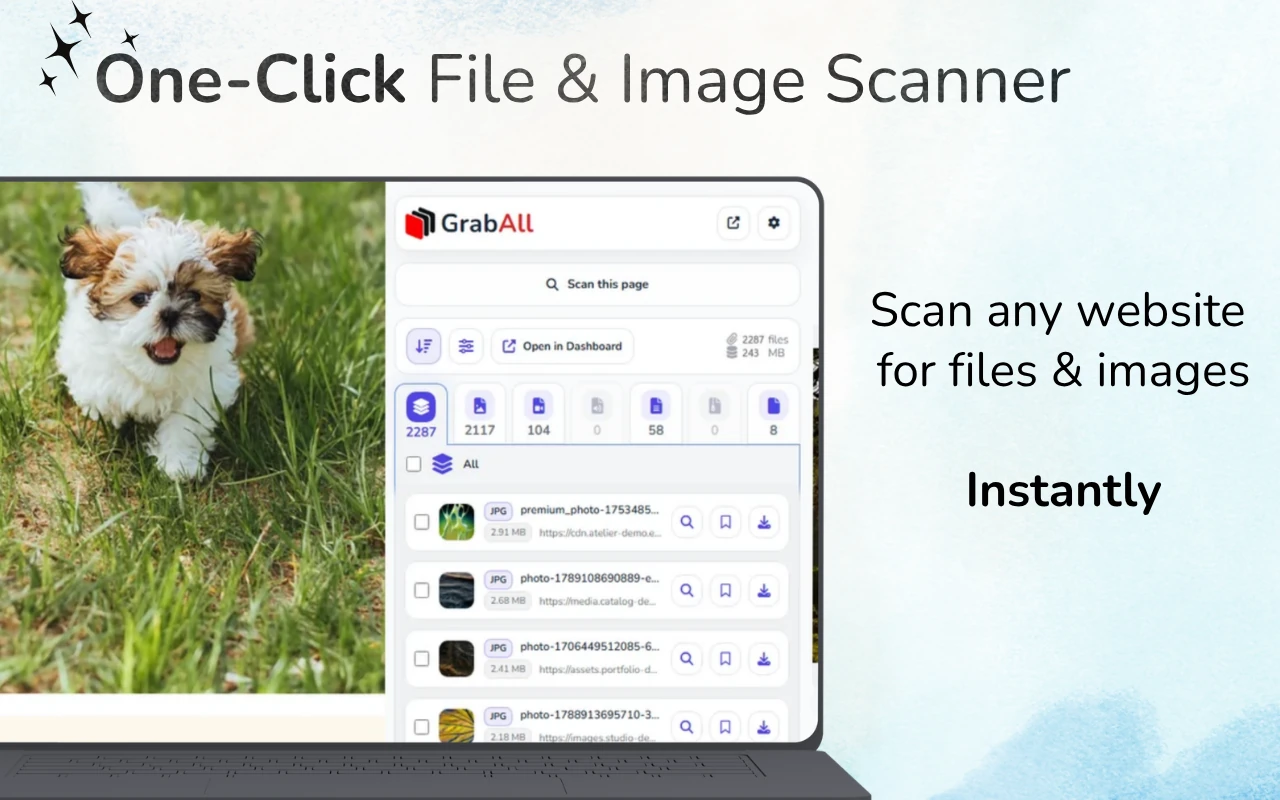
תשובה מהירה: פתח את דף האינטרנט, טען את התוכן הרלוונטי וסרוק אותו עם GrabAll. סנן את הקבצים שזוהו לפי סוג או גודל, בדוק תצוגות מקדימות ושמות קבצים, ואז שמור או העתק את הקישורים שנבחרו. חלק מהמשאבים מופיעים רק לאחר אינטראקציה עם הדף.
חפש קישורי קבצים בדף הטעון
כפתורי הורדה, רשימות מסמכים, כרטיסי תמונה ואלמנטים מדיה יכולים כולם לחשוף קבצים. התחל בטעינת החלק שמכיל את המשאבים, לאחר מכן סרוק וסקור את התוצאות. סורק יכול לרשום רק משאבים שהדף מאפשר לדפדפן לגשת אליהם.
מה נחשב לקובץ שניתן להורדה
קובץ להורדה יכול להיות מסמך מקושר, מקור תמונה, אלמנט מדיה, ארכיון, גיליון אלקטרוני או נכס ציבורי אחר המוזכר בעמוד. הדפדפן חייב לדעת מספיק על המשאב כדי לבקש או להציג אותו.
גילוי קבצים אינו אומר חקר שרת. GrabAll עובד עם הדף הנוכחי וכתובות ה-URL המסופקות, לא עם ספריות פרטיות או תוכן שרת שאינו רשום.
- קישורים לעוגן למסמכים וארכיונים
- מאפיינים src, srcset ו-lazy-load של תמונות
- אלמנטים של וידאו, אודיו, פוסטר ומקור
- כתובות URL של קבצים ציבוריים המופיעות בטקסט דף או מאפייני נתונים
תהליך גילוי מובנה
סרוק את הדף הרלוונטי ביותר תחילה. קבץ את התוצאות לפי סוג, ולאחר מכן בדוק את סיומות הקבצים, רמזי MIME, ממדים, גדלים ודומיינים מקוריים. השתמש בתצוגות מקדימות כאשר זמינות.
אם הדף דינמי, אפשר למדור הרלוונטי לטעון לפני הסריקה. הימנע מגלילה באזורים לא קשורים מכיוון שזה יכול להוסיף המלצות ונכסי ניווט למערך התוצאות.
- בחר עמוד מסוים
- טען את התוכן הרלוונטי למשימה
- סרוק וקבץ תוצאות לפי סוג
- סנן, הצג מראש ובחר את הקבצים השימושיים
URLs ללא סיומות ברורות
חלק מההורדות משתמשות בנתיבים כמו /download?id=123 במקום בשם קובץ המסתיים ב-.pdf או .zip. קישורים אלה יכולים להיות קשה יותר לסיווג לפני שהשרת מגיב. תוויות דפים, כותרות תגובה והתנהגות ההורדה של הדפדפן עשויים לספק מידע נוסף.
אל תניח שכל כתובת URL ארוכה היא קובץ. קישורי מעקב, ניווט וקישורי API יכולים להיראות דומים.
מתי סריקה עדיפה על צפייה בקוד המקור
צפייה בקוד מקור HTML יכולה לעזור למשתמשים טכניים, אך דפים מודרניים לעיתים מוסיפים תוכן לאחר טעינת המסמך הראשוני. תוסף דפדפן יכול לבדוק את ההקשר המוצג ולהציג תוצאות בממשק מוכוון סקירה.
עבור HTML שהודבק או מקור לא מקוון, השתמש ב-Bulk File URL Extractor החינמי. עבור הדף החי, השתמש ב-GrabAll כדי שתוכל לשלב גילוי עם תצוגות מקדימות ובחירת הורדה.
קבע ציפיות ריאליות
קבצים מאחורי אימות, שנוצרו לאחר קריאות API מוגנות, מאוחסנים במערכות פרטיות או נמסרו דרך DRM, אינם בתחום הסורק הרגיל של דף. כבד את כללי הגישה והשתמש בבקרות ההורדה הרשמיות כאשר הן מסופקות.
התוצאות הטובות ביותר מגיעות מדפים שמציגים במתכוון קישורים למשאבים, גלריות, קבצים מצורפים, מסמכים או קבצי מדיה רגילים.
שאלות נפוצות
האם GrabAll יכול למצוא קבצים שאינם מקושרים בדף?
לא. הוא מארגן משאבים וקישורים הזמינים לדפדפן; הוא אינו מחפש בספריות שרת פרטיות או חושף קבצים שלא נחשפו.
האם עליי לסרוק את דף הבית או דף מסוים?
השתמש בעמוד הכי ספציפי שניתן. זה מייצר פחות נכסים לא קשורים ותוצאות נקיות יותר.
מה קורה אם ל-URL אין סיומת קובץ?
זה עדיין עשוי להפיק הורדה, אך הסיווג פחות מהימן עד שהשרת יענה. עיינו בתווית הדף והשתמשו בשליטה הרשמית כאשר אינכם בטוחים.
האם אפשר לחלץ קישורים מ-HTML שהועתק במקום?
כן. GrabAll מספקת כלי חינמי לחילוץ מספרי URL של קבצים מתוך HTML, קוד מקור וטקסט שהודבק.
GrabAll סורק את הדף ומביא תמונות, מסמכים, מדיה וקבצים אחרים להורדה לרשימה ברורה אחת, כך שתוכל לבחור בדיוק מה לשמור.