
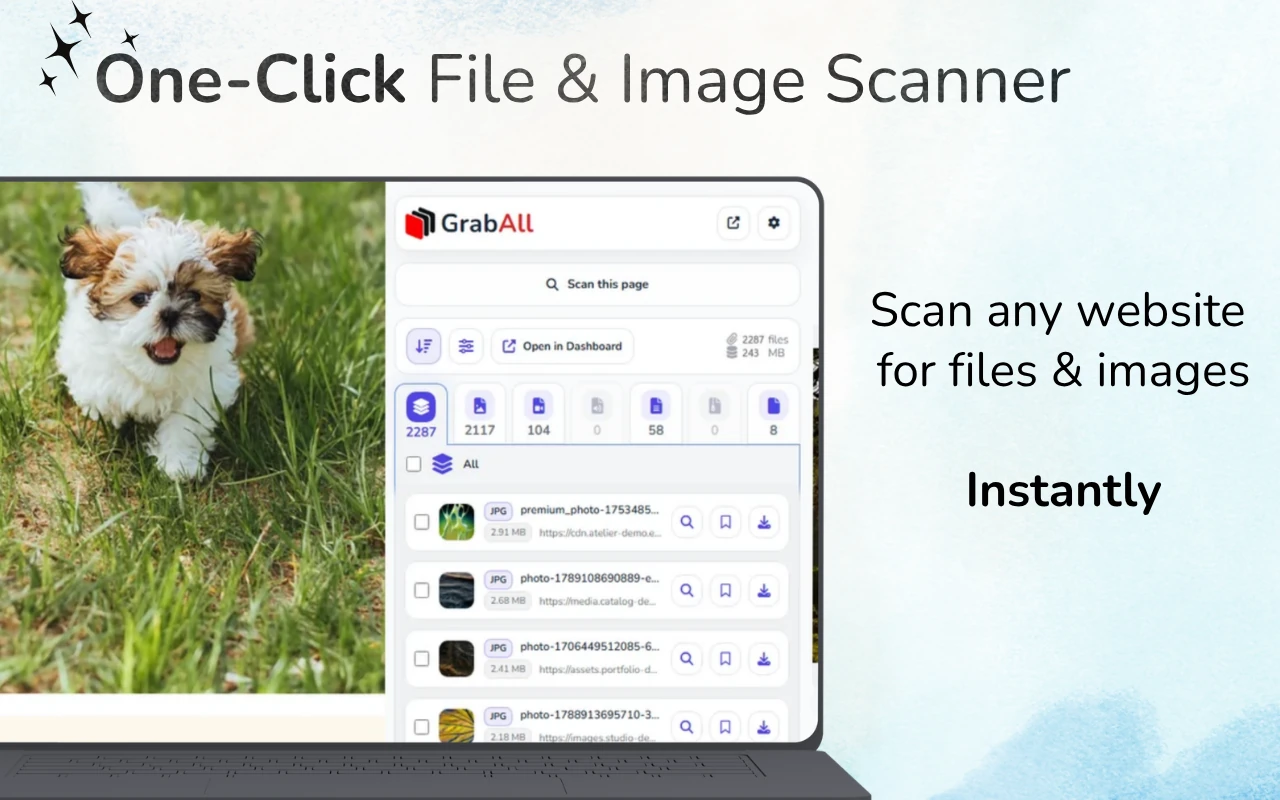
ë¹ ë¥¸ ëµë³: 웹페이지를 열고, 관련 콘텐츠를 불러온 뒤 GrabAll로 스캔합니다. 감지된 파일을 유형이나 크기별로 필터링하고, 미리보기와 파일 이름을 확인한 후 선택한 링크를 저장하거나 복사합니다. 일부 리소스는 페이지 상호작용 후에만 나타납니다.
불러온 페이지에서 파일 링크를 찾아보세요.
다운로드 버튼, 문서 목록, 이미지 카드, 미디어 요소 모두 파일을 노출할 수 있습니다. 리소스를 포함한 섹션을 먼저 불러온 후 결과를 스캔하고 검토하세요. 스캐너는 페이지가 브라우저에 제공하는 리소스만 목록화할 수 있습니다.
ë¤ì´ë¡ë ê°ë¥í íì¼ì ë²ì
ë¤ì´ë¡ë ê°ë¥í íì¼ì ë§í¬ ë 문ì, ì´ë¯¸ì§ ìì¤, 미ëì´ ìì, ìì¹´ì´ë¸, ì¤íë ë ìí¸ ëë íì´ì§ì ìí´ ì°¸ì¡° ë ë¤ë¥¸ 공공 ìì°ì´ ë ì ììµëë¤. ë¸ë¼ì°ì ë ìì²íê±°ë íìíë 리ìì¤ì ëí´ ì¶©ë¶í ìê³ ìì´ì¼ í©ëë¤.
File discoveryë ìë² ííì ì미íì§ ììµëë¤. GrabAllì íì¬ íì´ì§ì í¨ê» ìëíë©° URL를 ê³µê¸íë©°, ê°ì¸ ëë í 리 ëë ë¹ ë¦¬ì¤í¸ ìë² ë´ì©ì´ ìëëë¤.
- 문ì ë° ìì¹´ì´ë¸ì ìµì»¤ ë§í¬
- ì´ë¯¸ì§ src, srcset ë° ê²ì¼ë¥¸ ë¡ë ìì±
- ëìì, ì¤ëì¤, í¬ì¤í° ë° ìì¤ ìì
- 공공 íì¼ URLë íì´ì§ í ì¤í¸ ëë ë°ì´í° ìì±ì ì ì
ì²´ê³ì ì¼ë¡ íì¼ì ì°¾ë ë°©ë²
ê°ì¥ ê´ë ¨ë íì´ì§ë¥¼ 먼ì ì¤ìºí©ëë¤. ì íë³ ê·¸ë£¹ ê²°ê³¼, íì¼ íì¥, MIME íí¸, ì¹ì, í¬ê¸° ë° ìì¤ ëë©ì¸ì ê²ì¬í©ëë¤. ê°ë¥í 미리보기를 ì¬ì©í©ëë¤.
íì´ì§ê° ëì ì¸ ê²½ì°ì, ì¤ìºëì ìì ì ì¬í기 ìíì¬ ê´ë ¨ë ë¨ë©´ë를 íì©íììì¤. ê·¸ ê²°ê³¼ì ëí ê¶ê³ ë° ë´ë¹ê²ì´ì ìì°ì ì¶ê° í ì ì기 ë문ì ê´ë ¨ ììì ì¤í¬ë¡¤íì§ ë§ììì¤.
- í¹ì íì´ì§ ì í
- ìì ì ê´ë ¨ë ë´ì©ìë¡ë
- ì íë³ ì¤ìº ë° ê·¸ë£¹ ê²°ê³¼
- íí°, 미리보기 ë° ì ì©í íì¼ ì í
íì¥ìê° íìëì§ ìë URL
ëªëª ë¤ì´ë¡ëë /download?id=123ì ê°ì ë ¸ì ì .pdf ëë .zipìì íì¼ ì´ë¦ì ëì ì ì¬ì©í©ëë¤. ì´ ë§í¬ë ìë²ê° ìëµí기 ì ì ë¶ë¥ í ì ììµëë¤. íì´ì§ ë¼ë²¨, ìëµ í¤ë ë° ë¸ë¼ì°ì ë¤ì´ë¡ë íëì ë ë§ì ì 보를 ì ê³µ í ì ììµëë¤.
긴 URLë íì¼ì ê°ì íì§ ë§ììì¤. ì¶ì , ë¤ë¹ê²ì´ì ë° API ë§í¬ë ì ì¬í©ëë¤.
ê²ì¬ë ì ë§ ê·¼ì ë³´ë¤ë ë ë«ìµëë¤
HTML ìì¤ë 기ì ì ì¸ ì¬ì©ì를 ëì¸ ì ììµëë¤, ê·¸ë¬ë íë íì´ì§ë ììë¡ ì´ê¸° 문ì ì§ íì ë´ì©ì ì¶ê°í©ëë¤. ë¸ë¼ì°ì íì¥ì ë ëë§ ë 컨í ì¤í¸ë¥¼ ê²ì¬íê³ ê²í ì§í¥ì ì¸ ì¸í°íì´ì¤ìì 결과를 íì¸í ì ììµëë¤.
과거 HTML ëë ì¤íë¼ì¸ ìì¤ì ê²½ì° ë¬´ë£ íì¼ ì¼ê´ URL ì¶ì¶ê¸°ë¥¼ ì¬ì©íììì¤. ë¼ì´ë¸ íì´ì§ì ê²½ì° GrabAllì ì¬ì©íë¯ë¡ 미리보기 ë° ë¤ì´ë¡ë ì íì¼ë¡ ê²ì í ì ììµëë¤.
íì¤ì ì¸ ê¸°ë
API í¸ì¶ í ìì± ë ì¸ì¦ ë¤ì íì¼, ê°ì¸ ìì¤í ì ì ì¥, ëë DRM를 íµí´ ì ë¬ ì ì íì´ì§ ì¤ìºëì ë²ì ë°ì. ì¡ì¸ì¤ ê·ì¹ì ì¡´ì¤íê³ ì ê³µ í ê³µì ë¤ì´ë¡ë 컨í¸ë¡¤ì ì¬ì©í©ëë¤.
ê°ì¥ ì¢ì ê²°ê³¼ë ìì ë§í¬, ê°¤ë¬ë¦¬, ì²¨ë¶ íì¼, 문ì, ëë ì¼ë° 미ëì´ íì¼ì deliberately ë ¸ì¶ íì´ì§ìì ì¨ë¤.
ì주 묻ë ì§ë¬¸
GrabAllì íì´ì§ì ì°ê²°ëì§ ìë íì¼ì ì°¾ì ì ììµëê¹?
ì´ë¦ * ììì 구ì±íê³ ë¸ë¼ì°ì ì ì¬ì©í ììë ë§í¬; ê·¸ê²ì ê°ì¸ ìë² ëë í 리를 ê²ìíê±°ë unexposed íì¼ì ê³µê°íì§ ììµëë¤.
ííì´ì§ ëë í¹ì íì´ì§ë¥¼ ì¤ìºí´ì¼í©ëê¹?
ê°ì¥ í¹ì í íì´ì§ë¥¼ ì¬ì©íììì¤. ëª ê°ì§ ê´ë ¨ ìì°ê³¼ 깨ëí 결과를 ìì°í©ëë¤.
URLì íì¼ íì¥ìê° ìì¼ë©´ ì´ë»ê² ëëì?
ì¬ì í ë¤ì´ë¡ë를 ìì°í ì ìì§ë§, ë¶ë¥ë ìë²ê° ìëµí ëê¹ì§ ë ì 뢰í ì ììµëë¤. íì´ì§ ë¼ë²¨ì ê²í íê³ íì¸ì´ íìí í ë ê³µì ì ì´ë¥¼ ì¬ì©í©ëë¤.
ëì HTMLìì ë§í¬ë¥¼ ì¶ì¶ í ì ììµëê¹?
ì. GrabAllì HTML, ìì¤ ì½ë ë° í ì¤í¸ë¥¼ ë¶ì¬ ë£ê¸°ìí ë¬´ë£ íì¼ ì¼ê´ URL ì¶ì¶ê¸°ë¥¼ ì ê³µí©ëë¤.
GrabAll은 페이지를 스캔해 이미지, 문서, 미디어와 기타 다운로드 가능한 파일을 하나의 깔끔한 목록으로 모아 원하는 항목만 쉽게 저장할 수 있게 해 줍니다.