
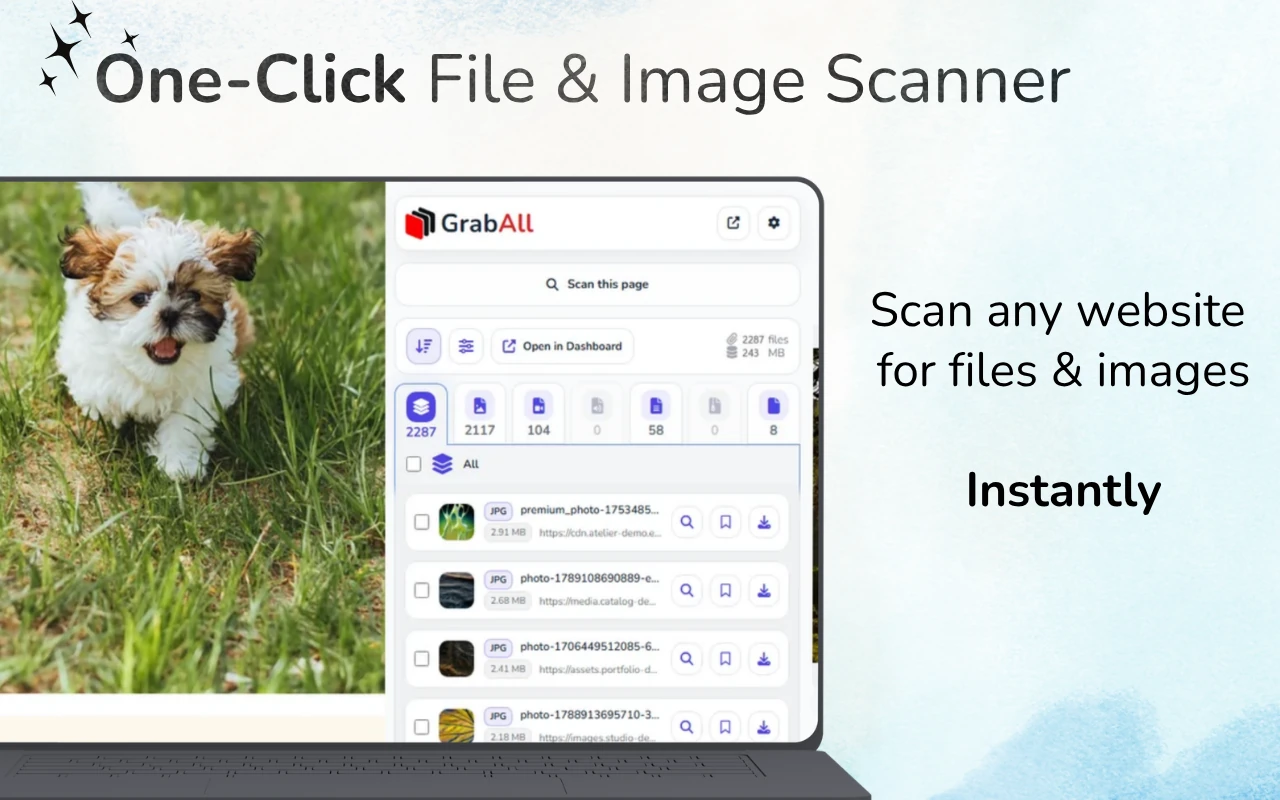
Greitas atsakymas: Norėdami sukurti gyvą tinklalapį, nuskaitykite su GrabAll ir nukopijuokite aptiktas failų nuorodas. Norėdami išsaugoti HTML arba nukopijuotą šaltinio kodą, įklijuokite jį į Bulk File URL Extractor. Nurodykite pagrindinį URL, kai šaltinyje yra santykinės nuorodos.
Pasirinkite tarp puslapio skenavimo ir įklijuoto HTML analizės
Skenuojant įkeltą tinklalapį galima rasti naršyklėje prieinamus failus, o internetinis ekstraktorius skaito tik jūsų įklijuotą HTML arba tekstą. Pasirinkite metodą, atitinkantį jūsų pradinį tašką, tada peržiūrėkite gautus URL prieš naudodami juos atsisiuntimams.
Kur HTML faile pasirodo failų URL
Paprastos nuorodos naudoja href, o vaizdai ir medija dažniausiai naudoja src. Reaguojantys vaizdai gali nurodyti kelis kandidatus srcset. Nuo tingaus įkėlimo bibliotekos dažnai saugo tikrus URL duomenis data-src, data-original arba pasirinktiniame duomenų atributuose.
Stilių lapai ir inline CSS gali nurodyti fonus per url(). Žalias tekstas taip pat gali turėti pilnus URL, kurie nėra priskirti HTML elementui.
- href nuorodos
- src ir plakato atributai
- srcset ir data-srcset kandidatai
- CSS url() reikšmės ir žali absoliutūs URL
Teisingai išspręskite santykinius kelius
Reikšmė, pavyzdžiui, ../files/report.pdf, yra prasminga tik santykinai puslapiui, iš kurio kilo HTML. Nurodykite pradinio puslapio URL kaip pagrindą, kad išgavėjas galėtų paversti santykinius kelius į pilnus adresus.
Protokolo reliatyvios nuorodos, prasidedančios // paprastai paveldi HTTPS saugiame puslapyje. Root reliatyvūs keliai, prasidedantys /, naudoja dabartinę svetainės kilmę.
- Laikykite pradinio šaltinio puslapio URL
- Naudokite tai kaip pradinį URL
- Normalizuoti protokolo ir šaknies santykinius kelius
- Peržiūrėkite išspręstus domenus prieš naudodami sąrašą
Filtruoti kandidato URL pagal paskirtį
Ne kiekvienas URL šaltinio kode yra atsisiunčiamas turtas. Puslapiai turi navigacijos nuorodas, API, analizę, šriftus, scenarijus, stilių lapus ir sekimo parametrus. Filtruokite pagal atitinkamus plėtinius ir tikrinkite neaiškius URL.
Vaizdams įtraukite šiuolaikinius formatus, tokius kaip WebP ir AVIF. Dokumentams apsvarstykite PDF, DOCX, XLSX, CSV, PPTX ir archyvus pagal užduotį.
HTML šaltinis prieš pateiktą puslapį
Nukopijuotas šaltinis atspindi tik tai, ką pateikėte. Gali trūkti resursų, įterptų po JavaScript paleidimo, turinio įkėlimo po slinkimo ar URL, sukurtų sąveikos metu.
Naudokite neprisijungus veikiantį ištraukimą šaltinio fragmentams, eksportuotam HTML, el. pašto šablonams ir kodo peržiūrai. Naudokite GrabAll plėtinį gyvai pateikto puslapio ir naršyklės konteksto darbo eigoms.
Patikrinkite prieš atsisiunčiant
Išvalykite sąrašą, patikrinkite domenus ir išbandykite nedidelį imtį. Atitinkamas plėtinys URL negarantuoja, kad atsakymas yra galiojantis arba kad esate įgaliotas jį naudoti.
Venkite automatiškai prašyti didelių neperžiūrėtų sąrašų. Patikrinimas apsaugo nuo nefunkcinių nuorodų, nepageidaujamų sekimo taškų ir perteklinės apkrovos.
Dažniausiai užduodami klausimai
Ar ekstraktorius gali išspręsti ../ santykines nuorodas?
Taip, kai nurodote originalų puslapio URL kaip bazinį adresą.
Ar HTML išgavimas apima srcset paveikslėlius?
GrabAll įrankis tikrina įprastus šaltinio ir reaktyvaus vaizdo atributus, įskaitant srcset kandidatus.
Kodėl kai kurie gyvo puslapio failai trūksta iš nukopijuoto HTML?
JavaScript gali juos pridėti po pradinio HTML įkėlimo. Naudokite tiesioginį naršyklės plėtinį renderizuotam ir dinamiškai įkeliamam puslapio turiniui.
Ar visi išgauti URL saugūs atsisiuntimui?
Ne. Prieš naudodami rezultatų sąrašą, peržiūrėkite domenus, failų tipus, leidimus ir nedidelį pavyzdį.
GrabAll nuskenuoja puslapį ir sujungia vaizdus, dokumentus, mediją ir kitus atsisiunčiamus failus į vieną aiškią sąrašą, kad galėtumėte tiksliai pasirinkti, ką išsaugoti.