
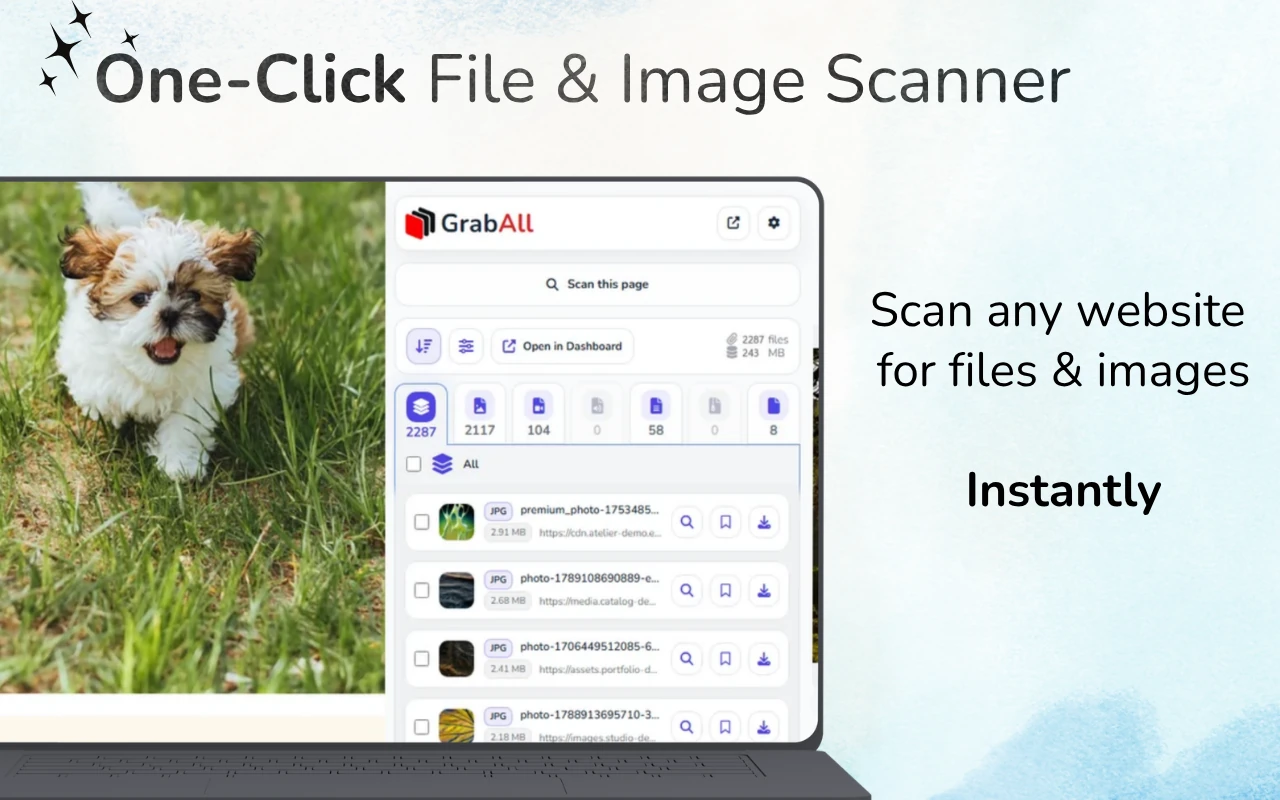
Ātra atbilde: Lai izveidotu tiešsaistes tīmekļa lapu, skenējiet ar GrabAll un kopējiet atklātās failu saites. Saglabātajam HTML vai kopētajam avota kodam ielīmējiet to Bulk File URL Extractor. Norādiet bāzes URL, ja avotā ir relatīvās saites.
Izvēlies starp lapas skenēšanu un HTML analīzi
Skenējot ielādētu tīmekļa lapu, var atrast pārlūkprogrammā pieejamos failus, kamēr tiešsaistes ekstraktors lasa tikai HTML vai tekstu, ko ielīmējat. Izvēlieties metodi, kas atbilst jūsu sākumpunktam, pēc tam pārskatiet iegūtos URL pirms to izmantošanas lejupielādēm.
Kur HTML parādās failu URL
Parastās saites izmanto href, bet attēli un mediji parasti izmanto src. Reresponsīvie attēli var uzskaitīt vairākus kandidātus srcset. Lēnām ielādējamās bibliotēkas bieži glabā reālus URL data-src, data-original vai pielāgotu datu atribūtos.
Stila lapas un iebūvētais CSS var atsaukties uz foniem, izmantojot url(). Raw teksts arī var saturēt pilnus URL, kas nav piesaistīti HTML elementam.
- href saites
- src un plakāta atribūti
- srcset un data-srcset kandidāti
- CSS url() vērtības un neapstrādātie absolūtie URL
Pareizi atrisināt relatīvos ceļus
Vērtība, piemēram, ../files/report.pdf, ir nozīmīga tikai attiecībā pret lapu, no kuras nāk HTML. Nodrošiniet oriģinālās lapas URL kā pamatu, lai izguvējs varētu pārvērst relatīvos ceļus pilnās adresēs.
Protokolu relatīvās saites, kas sākas ar //, parasti manto HTTPS drošajā lapā. Saknes relatīvās ceļi, kas sākas ar /, izmanto pašreizējās vietnes izcelsmi.
- Saglabāt sākotnējās avota lapas URL
- Izmantojiet to kā bāzes URL
- Normalizēt protokola un saknes relatīvos ceļus
- Pārskatīt atrisinātos domēnus pirms saraksta izmantošanas
Filtrēt kandidātu URL pēc nodoma
Ne katrs URL avota kodā ir lejupielādējams aktīvs. Lapas satur navigācijas saites, API, analītiku, fontus, skriptus, stilu lapas un izsekošanas parametrus. Filtrējiet pēc atbilstošiem paplašinājumiem un pārbaudiet neskaidrus URL.
Attēliem iekļaujiet mūsdienīgus formātus, piemēram, WebP un AVIF. Dokumentiem apsveriet PDF, DOCX, XLSX, CSV, PPTX un arhīvus atbilstoši uzdevumam.
HTML avots pret attēloto lapu
Nokopētais avots attēlo tikai to, ko jūs nodrošinājāt. Tas var neatklāt resursus, kas ievietoti pēc JavaScript palaišanas, saturu, kas ielādējās pēc ritināšanas, vai URL, kas izveidoti mijiedarbības laikā.
Izmantojiet bezsaistes izguvēju avotu fragmentiem, eksportētajam HTML, e-pasta veidnēm un koda pārskatam. Izmantojiet GrabAll paplašinājumu tiešraides atveidotajai lapai un pārlūkprogrammas konteksta darbplūsmām.
Pārbaudiet pirms lejupielādes
Noņemiet saraksta dublikātus, pārbaudiet domēnus un testējiet nelielu paraugu. Atbilstoša paplašinājuma esamība URL ne garantē, ka atbilde ir derīga vai ka jums ir tiesības to izmantot.
Izvairieties automātiski pieprasīt lielas neizpētītas sarakstus. Validācija novērš salauztas saites, nevēlamus izsekošanas galapunktus un lieku slodzi.
Biežāk uzdotie jautājumi
Vai ekstraktors var atrisināt .. / relatīvās saites?
Jā, kad jūs norādāt oriģinālās lapas URL kā pamata adresi.
Vai HTML izvilkšana ietver srcset attēlus?
GrabAll rīks pārbauda kopīgas avotu un atsaucīgu attēlu atribūtu vērtības, tostarp srcset kandidātus.
Kāpēc daži tiešās lapas faili trūkst no kopētā HTML?
JavaScript tos var pievienot pēc sākotnējā HTML ielādes. Izmantojiet tiešās pārlūkprogrammas paplašinājumu renderētā un dinamiskā saturā.
Vai visi iegūtie URL ir droši lejupielādei?
Nē. Pārskatiet domēnus, failu tipus, atļaujas un nelielu paraugu pirms rezultātu saraksta izmantošanas.
GrabAll skenē lapu un apkopo attēlus, dokumentus, medijus un citus lejupielādējamus failus vienā skaidrā sarakstā, lai jūs varētu izvēlēties tieši to, ko saglabāt.