
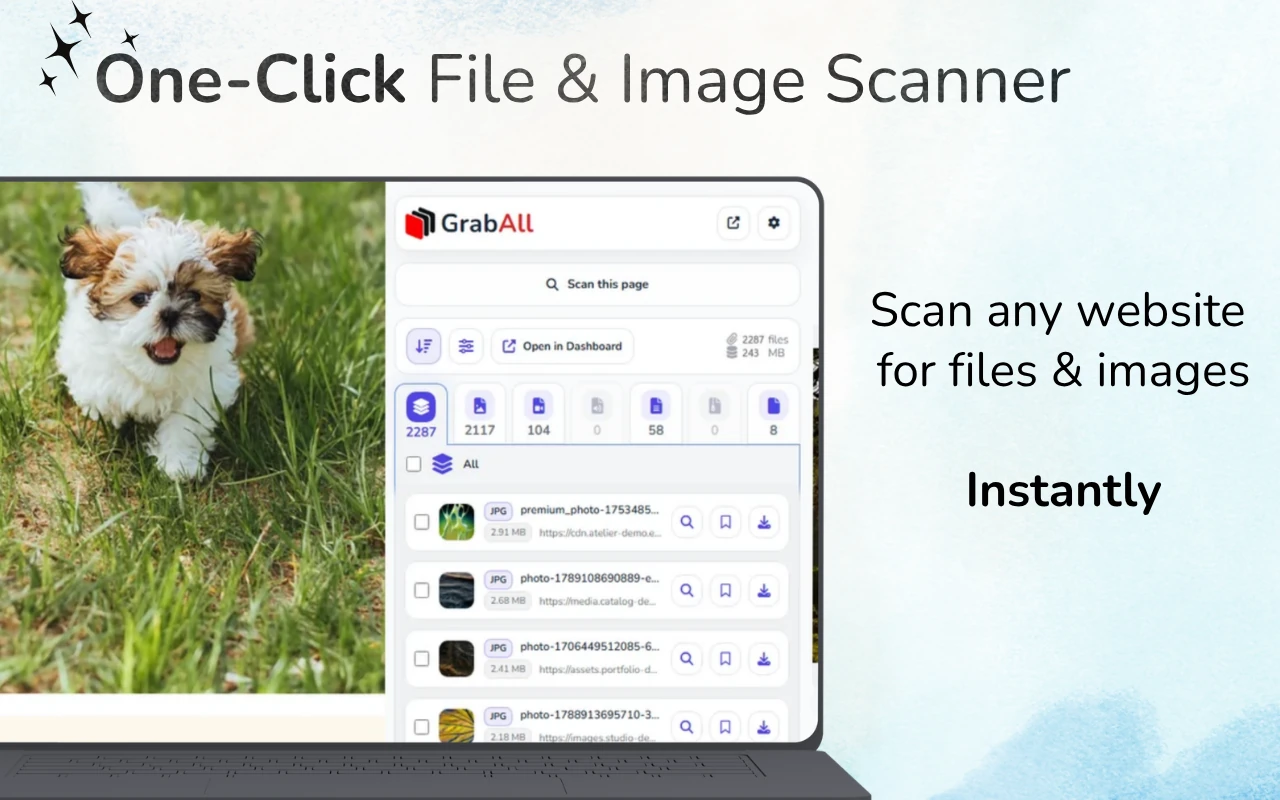
ഷീഘ്ര ഉപാധി: ഒരു തത്സമയ വെബ് പേജിനായി, GrabAll ഉപയോഗിച്ച് സ്കാൻ ചെയ്ത് കണ്ടെത്തിയ ഫയൽ ലിങ്കുകൾ പകർത്തുക. സംരക്ഷിച്ച HTML അല്ലെങ്കിൽ പകർത്തിയ സോഴ്സ് കോഡിനായി, അത് ബൾക്ക് ഫയൽ URL എക്സ്ട്രാക്ടറിലേക്ക് ഒട്ടിക്കുക. ഉറവിടത്തിൽ ആപേക്ഷിക ലിങ്കുകൾ അടങ്ങിയിരിക്കുമ്പോൾ ഒരു അടിസ്ഥാന URL നൽകുക.
ഒരു പേജ് സ്കാൻ ചെയ്യുന്നതിനും ഒട്ടിച്ച HTML പാഴ്സ് ചെയ്യുന്നതിനും ഇടയിൽ തിരഞ്ഞെടുക്കുക
ലോഡുചെയ്ത വെബ് പേജ് സ്കാൻ ചെയ്യുന്നത് ബ്രൗസറിൽ ലഭ്യമായ ഫയലുകൾ കണ്ടെത്താൻ കഴിയും, അതേസമയം ഓൺലൈൻ എക്സ്ട്രാക്ടർ നിങ്ങൾ ഒട്ടിക്കുന്ന HTML അല്ലെങ്കിൽ ടെക്സ്റ്റ് മാത്രമേ വായിക്കുകയുള്ളൂ. നിങ്ങളുടെ ആരംഭ പോയിന്റുമായി പൊരുത്തപ്പെടുന്ന രീതി തിരഞ്ഞെടുക്കുക, തുടർന്ന് ഡൗൺലോഡുകൾക്കായി ഉപയോഗിക്കുന്നതിന് മുമ്പ് ഫലമായുണ്ടാകുന്ന URL കൾ അവലോകനം ചെയ്യുക.
HTML-ൽ ഫയൽ URL-കൾ എവിടെ പ്രത്യക്ഷപ്പെടും
സാധാരണ ലിങ്കുകൾ href ഉപയോഗിക്കുന്നു, അതേസമയം ചിത്രങ്ങളും മാധ്യമങ്ങളും സാധാരണയായി src ഉപയോഗിക്കുന്നു. പ്രതികരണാത്മക ചിത്രങ്ങൾക്ക് srcset ൽ നിരവധി സ്ഥാനാർത്ഥികളെ പട്ടികപ്പെടുത്താൻ കഴിയും. അലസമായ ലോഡിംഗ് ലൈബ്രറികൾ പലപ്പോഴും ഡാറ്റ-എസ്ആർസി, ഡാറ്റ-ഒറിജിനൽ അല്ലെങ്കിൽ ഇഷ് ടാനുസൃത ഡാറ്റാ ആട്രിബ്യൂട്ടുകളിൽ യഥാർത്ഥ യു ആർ എല്ലുകൾ സംഭരിക്കുന്നു.
സ്റ്റൈൽഷീറ്റുകളും ഇൻലൈൻ CSS-ഉം ബാക്ക്ഗ്രൗണ്ടുകൾ url() മുഖേന റഫറൻസ് ചെയ്യാം. കാഠിന്യ പാഠ്യവും HTML ഘടകത്തിനു ചേർക്കപ്പെടാത്ത പൂർണ്ണ URL-കൾ അടങ്ങിയിരിക്കാന് സാധ്യതയുണ്ട്.
- href കണ്ണികൾ
- src, പോസ്റ്റർ ആട്രിബ്യൂട്ടുകൾ
- srcset ആൻഡ് ഡാറ്റ-SRCSET സ്ഥാനാർത്ഥികൾ
- CSS url() മൂല്യങ്ങളും അസംസ്കൃത സമ്പൂർണ്ണ URL-കളും
ബന്ധപ്പെട്ട പാതകൾ ശരിയായി പരിഹരിക്കുക
../files/report.pdf പോലെയുള്ള മൂല്യം അതിനുയർന്നു വന്ന HTML ഉള്ള പേജുമായി മാത്രമേങ്ങളിൽ പ്രാധാന്യമുള്ളൂ. എക്സ്ട്രാക്ടർ ബന്ധിത പാടുകൾ സമ്പൂർണ്ണ വിലാസങ്ങളാക്കാൻ, അടിസ്ഥാനമായി അസലയുള്ള പേജ് URL നൽകുക.
പ്രോട്ടോക്കോൾ-ആപേക്ഷിക ലിങ്കുകൾ // ൽ ആരംഭിക്കുന്ന പ്രോട്ടോക്കോൾ-ആപേക്ഷിക ലിങ്കുകൾ സാധാരണയായി ഒരു സുരക്ഷിത പേജിൽ HTTPS പാരമ്പര്യമായി ലഭിക്കുന്നു. നിലവിലെ വെബ് സൈറ്റ് ഉത്ഭവത്തിൽ നിന്ന് ആരംഭിക്കുന്ന / ഉപയോഗിക്കുന്ന റൂട്ട്-ആപേക്ഷിക പാതകൾ.
- ഓറിജിനൽ സോഴ്സ് പേജ് URL സൂക്ഷിക്കുക
- അടിസ്ഥാന URL ആയി ഉപയോഗിക്കുക
- പ്രോട്ടോക്കോൾ-ആപേക്ഷികവും റൂട്ട്-റിലേറ്റീവ് പാതകളും സാധാരണവൽക്കരിക്കുക
- ലിസ്റ്റ് ഉപയോഗിക്കുന്നതിന് മുമ്പ് പരിഹരിച്ച ഡൊമെയ്നുകൾ അവലോകനം ചെയ്യുക
ഉദ്ദേശ്യം അനുസരിച്ച് സ്ഥാനാർത്ഥി URL-കൾ ഫിൽട്ടർ ചെയ്യുക
സോഴ്സ് കോഡിലെ എല്ലാ URL കളും ഡൗൺലോഡ് ചെയ്യാവുന്ന ആസ്തിയല്ല. പേജുകളിൽ നാവിഗേഷൻ ലിങ്കുകൾ, API-കൾ, അനലിറ്റിക്സ്, ഫോണ്ടുകൾ, സ്ക്രിപ്റ്റുകൾ, സ്റ്റൈൽഷീറ്റുകൾ, ട്രാക്കിംഗ് പാരാമീറ്ററുകൾ എന്നിവ അടങ്ങിയിരിക്കുന്നു. പ്രസക്തമായ വിപുലീകരണങ്ങൾ ഉപയോഗിച്ച് ഫിൽട്ടർ ചെയ്യുക, അവ്യക്തമായ URL കൾ പരിശോധിക്കുക.
ചിത്രങ്ങൾക്കായി, വെബ്പി, എവിഐഎഫ് തുടങ്ങിയ ആധുനിക ഫോർമാറ്റുകൾ ഉൾപ്പെടുത്തുക. പ്രമാണങ്ങൾക്കായി, ടാസ്ക് അനുസരിച്ച് PDF, DOCX, XLSX, CSV, PPTX, ARCHIVES എന്നിവ പരിഗണിക്കുക.
HTML ഉറവിടം വിസ്മരം ചെയ്ത പേജുമായി
പകർത്തിയ ഉറവിടം നിങ്ങൾ നൽകിയതിനെ മാത്രമേ പ്രതിനിധീകരിക്കുന്നുള്ളൂ. ജാവാസ്ക്രിപ്റ്റ് പ്രവർത്തിപ്പിച്ചതിനുശേഷം ചേർത്ത വിഭവങ്ങൾ, സ്ക്രോളിംഗിന് ശേഷം ലോഡ് ചെയ്ത ഉള്ളടക്കം അല്ലെങ്കിൽ ഇടപെടൽ സമയത്ത് സൃഷ്ടിച്ച URL-കൾ എന്നിവ ഇതിന് നഷ്ടമായേക്കാം.
സോഴ്സ് സ്നിപ്പെറ്റുകൾ, എക്സ്പോർട്ടുചെയ്ത HTML, ഇമെയിൽ ടെംപ്ലേറ്റുകൾ, കോഡ് റിവ്യൂ എന്നിവയ്ക്ക് ഓഫ്ലൈൻ എക്സ്ട്രാക്ടർ ഉപയോഗിക്കുക. ലൈവ് റെൻഡർ ചെയ്ത പേജ്, ബ്രൗസർ-കോണ്ടെക്സ്റ്റ് വർക്ക്ഫ്ലോകൾ എന്നിവയ്ക്കായി GrabAll എക്സ്റ്റൻഷൻ ഉപയോഗിക്കുക.
ഡൗൺലോഡ് ചെയ്യുന്നതിന് മുമ്പ് സാധൂകരിക്കുക
ലിസ്റ്റ് ഡീഡ്യൂപ്ലിക്കേറ്റ് ചെയ്യുക, ഡൊമെയ്നുകൾ പരിശോധിക്കുക, ഒരു ചെറിയ സാമ്പിൾ പരിശോധിക്കുക. ഒരു URL-ലെ പൊരുത്തപ്പെടുന്ന വിപുലീകരണം പ്രതികരണം സാധുതയുള്ളതാണെന്നോ അത് ഉപയോഗിക്കാൻ നിങ്ങൾക്ക് അധികാരമുണ്ടെന്നോ ഉറപ്പുനൽകുന്നില്ല.
അവലോകനം ചെയ്യാത്ത വലിയ ലിസ്റ്റുകൾ സ്വയമേവ അഭ്യർത്ഥിക്കുന്നത് ഒഴിവാക്കുക. തകർന്ന ലിങ്കുകൾ, അനാവശ്യ ട്രാക്കിംഗ് എൻഡ് പോയിന്റുകൾ, അനാവശ്യ ലോഡ് എന്നിവ സാധൂകരണം തടയുന്നു.
പതിവായി ചോദിക്കുന്ന ചോദ്യങ്ങൾ
എക്സ്ട്രാക്ടറിന് പരിഹരിക്കാൻ കഴിയുമോ .. / ആപേക്ഷിക ലിങ്കുകൾ?
അതെ, നിങ്ങൾ അടിസ്ഥാന വിലാസമായി യഥാർത്ഥ പേജ് URL നൽകുമ്പോൾ.
HTML എക്സ്ട്രാക്ഷനിൽ srcset ഇമേജുകൾ ഉൾപ്പെടുന്നുണ്ടോ?
GrabAll ടൂൾ സാധാരണ സോഴ്സ്, റെസ്പോൺസീവ് ഇമേജ് ആട്രിബ്യൂട്ടുകൾ പരിശോധിക്കുന്നു, ഇതിനകം srcset സ്ഥാനാർത്ഥികളും ഉൾപ്പെടുന്നു.
എന്തുകൊണ്ട് ചില ലൈവ്-പേജ് ഫയലുകൾ കോപ്പി ചെയ്ത HTML-ൽ കാണാൻ കഴിയുന്നില്ല?
ജാവാസ്ക്രിപ്റ്റ് ആദ്യ HTML ലോഡ് കഴിഞ്ഞ് അവയെ ചേർക്കാം. റെൻഡർ ചെയ്തും ഡൈനാമിക്കൽ ആയി ലോഡ് ചെയ്ത പേജ് ഉള്ളടക്കം ലഭിക്കുന്നതിന് ലൈവ് ബ്രൗസർ എക്സ്റ്റൻഷൻ ഉപയോഗിക്കുക.
വേർതിരിച്ചെടുത്ത എല്ലാ URL കളും ഡൗൺലോഡ് ചെയ്യാൻ സുരക്ഷിതമാണോ?
ഇല്ല. ഒരു ഫല പട്ടിക ഉപയോഗിക്കുന്നതിന് മുമ്പ് ഡൊമെയ്നുകൾ, ഫയൽ തരങ്ങൾ, അനുമതികൾ, ഒരു ചെറിയ സാമ്പിൾ എന്നിവ അവലോകനം ചെയ്യുക.
GrabAll സ്കാൻ ചെയ്യുകയും ചിത്രങ്ങൾ, പ്രമാണങ്ങൾ, മീഡിയ, മറ്റ് ഡൗൺലോഡ് ചെയ്യാവുന്ന ഫയലുകൾ എന്നിവ ഒരു വ്യക്തമായ പട്ടികയിലേക്ക് കൊണ്ടുവരികയും ചെയ്യുന്നു, അതിനാൽ എന്താണ് സംരക്ഷിക്കേണ്ടതെന്ന് നിങ്ങൾക്ക് തിരഞ്ഞെടുക്കാം.