
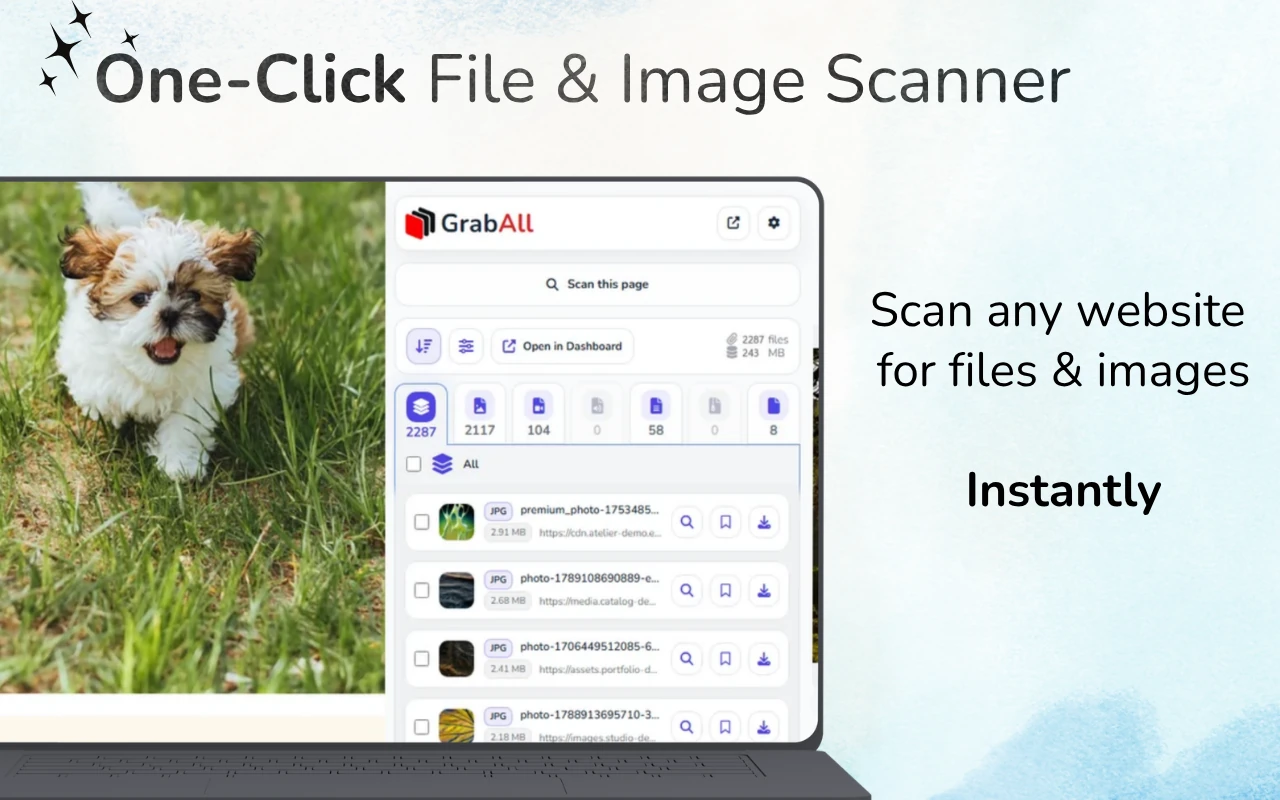
Raskt svar: Åpne nettsiden, last inn relevant innhold og skann det med GrabAll. Filtrer oppdagede filer etter type eller størrelse, sjekk forhåndsvisninger og filnavn, og lagre eller kopier de valgte lenkene. Enkelte ressurser vises først etter en sideinteraksjon.
Se etter filkoblinger på den innlastede siden
Nedlastingsknapper, dokumentlister, bildekort og medieelementer kan alle eksponere filer. Start med å laste inn seksjonen som inneholder ressursene, skann deretter og gjennomgå resultatene. En skanner kan bare liste opp ressurser som siden gjør tilgjengelig for nettleseren.
Hva som regnes som en nedlastbar fil
En nedlastbar fil kan være et tilknyttet dokument, en bildekilde, et medieelement, et arkiv, et regneark eller en annen offentlig ressurs som refereres til av siden. Nettleseren må vite nok om ressursen for å kunne be om eller vise den.
Filutforskning betyr ikke serverutforskning. GrabAll arbeider med den nåværende siden og angitte URL-er, ikke med private kataloger eller uregistrert serverinnhold.
- Ankerkoblinger til dokumenter og arkiver
- Bilde src, srcset og lazy-load attributter
- Video-, lyd-, poster- og kildeelementer
- Offentlige fil-URL-er som er til stede i sidetekst eller dataattributter
En strukturert oppdagelsesprosess
Skann den mest relevante siden først. Grupper resultater etter type, og inspiser filutvidelsene, MIME-tips, dimensjoner, størrelser og kildedomenene. Bruk forhåndsvisning der det er tilgjengelig.
Hvis siden er dynamisk, la den relevante delen lastes før skanning. Unngå å bla gjennom områder som ikke er relevante, fordi det kan legge til anbefalinger og navigasjonsressurser i resultatsettet.
- Velg en spesifikk side
- Last inn innholdet som er relevant for oppgaven
- Skann og grupper resultater etter type
- Filtrer, forhåndsvis og velg de nyttige filene
URL-er uten åpenbare filendelser
Noen nedlastinger bruker ruter som /download?id=123 i stedet for filnavn som slutter på .pdf eller .zip. Disse lenkene kan være vanskeligere å klassifisere før serveren svarer. Sidetiketter, responshoder og nettleserens nedlastingsadferd kan gi mer informasjon.
Ikke anta at hver lang URL er en fil. Sporings-, navigerings- og API-koblinger kan se like ut.
Når skanning er bedre enn å vise kildekode
Å se HTML-kilde kan være nyttig for tekniske brukere, men moderne sider legger ofte til innhold etter at det opprinnelige dokumentet lastes. En nettleserutvidelse kan inspisere den gjengitte konteksten og presentere resultater i et gjennomgangsorientert grensesnitt.
For limt inn HTML eller offline kilde, bruk den gratis Bulk File URL Extractor. For live-siden, bruk GrabAll slik at du kan kombinere oppdagelse med forhåndsvisning og nedlastingsvalg.
Sett realistiske forventninger
Filer bak autentisering, generert etter beskyttede API-kall, lagret i private systemer, eller levert gjennom DRM, er utenfor omfanget til en vanlig sideskanner. Respekter adgangsregler og bruk offisielle nedlastingskontroller når de er tilgjengelige.
De beste resultatene kommer fra sider som bevisst eksponerer ressurslenker, gallerier, vedlegg, dokumenter eller vanlige mediefiler.
Ofte stilte spørsmål
Kan GrabAll finne filer som ikke er koblet på siden?
Nei. Den organiserer ressurser og lenker som er tilgjengelige for nettleseren; den søker ikke i private serverkataloger eller avslører filer som ikke er eksponert.
Bør jeg skanne hjemmesiden eller en spesifikk side?
Bruk den mest spesifikke siden som mulig. Den produserer færre irrelevante ressurser og renere resultater.
Hva hvis en URL ikke har filtype?
Det kan fortsatt generere en nedlasting, men klassifiseringen er mindre pålitelig før serveren svarer. Se gjennom sideetiketten og bruk den offisielle kontrollen når du er usikker.
Kan jeg heller trekke ut lenker fra kopiert HTML?
Ja. GrabAll tilbyr en gratis masse-URL-ekstraktor for innlimt HTML, kildekode og tekst.
GrabAll skanner siden og samler bilder, dokumenter, media og andre nedlastbare filer i én tydelig liste, slik at du kan velge nøyaktig hva du vil lagre.