



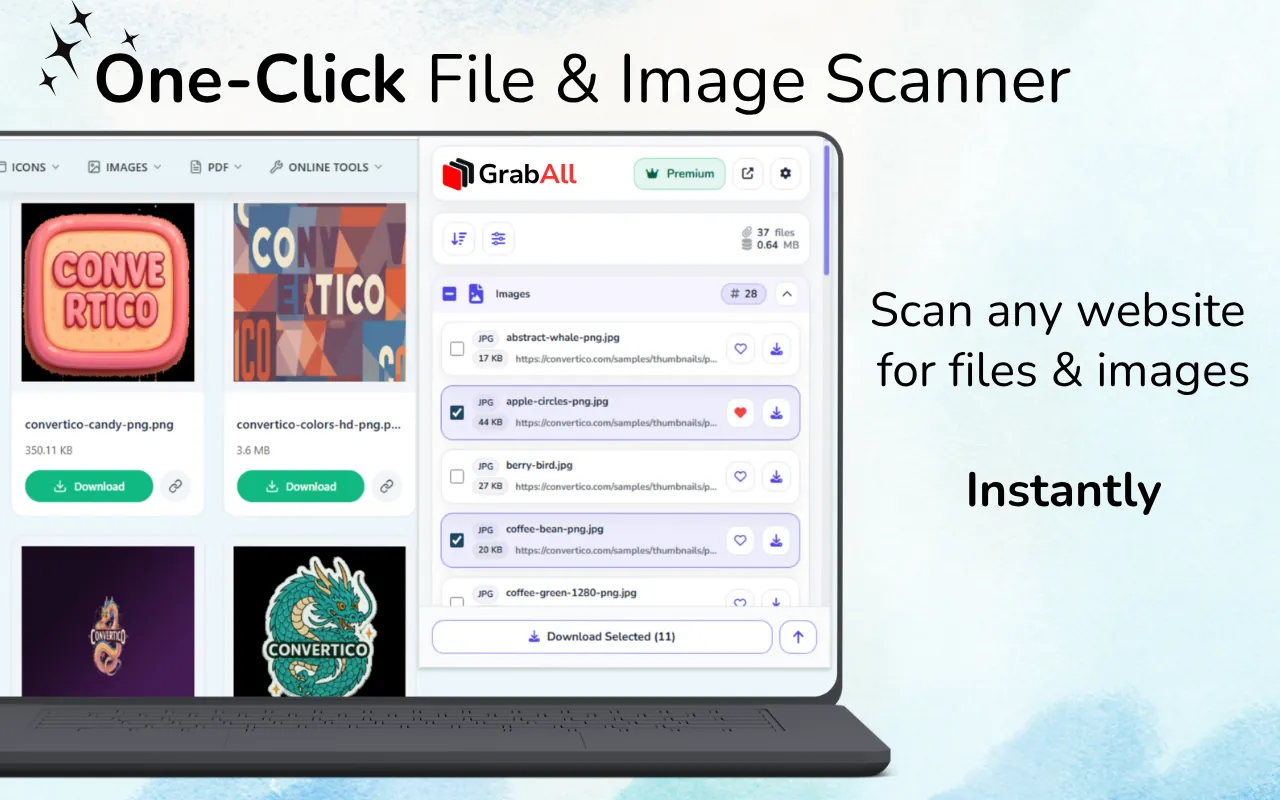
Resposta rápida: Abra a página da web, carregue o conteúdo relevante e escaneie-o com o GrabAll. Filtre os arquivos detectados por tipo ou tamanho, verifique as pré-visualizações e nomes dos arquivos, depois salve ou copie os links selecionados. Alguns recursos aparecem apenas após uma interação na página.
Procure links de arquivos na página carregada
Botões de download, listas de documentos, cartões de imagens e elementos de mídia podem todos expor arquivos. Comece carregando a seção que contém os recursos, depois escaneie e revise os resultados. Um scanner só pode listar recursos que a página disponibiliza para o navegador.
O que conta como um arquivo para download
Um arquivo para download pode ser um documento vinculado, uma fonte de imagem, um elemento de mÃdia, um arquivo, uma planilha, ou outro ativo público referenciado pela página. O navegador deve saber o suficiente sobre o recurso para requisitá-lo ou exibi-lo.
não significa exploração do servidor. GrabAll funciona com a página atual e fornece URLs, não com diretórios privados ou conteúdo de servidor não listado.
- Links de âncora para documentos e arquivos
- Image src, srcset e preguiçosa Imagens
- VÃdeo, áudio, cartaz e elementos de origem
- Arquivo público URLs presente no texto da página ou atributos de dados
Um processo de descoberta estruturado
Analise primeiro a página mais relevante. Agrupe os resultados por tipo, em seguida, inspecione as extensões de arquivo, dicas MIME, dimensões, tamanhos e domÃnios de origem.
Se a página é dinâmica, permita que a seção relevante carregue antes de analisar. Evite rolar por áreas não relacionadas porque isso pode adicionar recomendações e recursos de navegação ao conjunto de resultados.
- Escolha uma página especÃfica
- Carregar o conteúdo relevante para a tarefa
- Analise e agrupe os resultados por tipo
- Filtrar, visualizar e selecionar os arquivos úteis
URLs sem extensões óbvias
Alguns downloads usam rotas como /download?id=123 em vez de nomes de arquivos terminando em .pdf ou .zip. Esses links podem ser mais difÃceis de classificar antes que o servidor responda. Rótulos de página, cabeçalhos de resposta e o comportamento de download do navegador podem fornecer mais informações.
Não assuma que cada URL longo é um arquivo. Rastreamento, navegação e links API podem ser semelhantes.
Quando a análise é melhor do que consultar o código-fonte
Visualização da fonte HTML pode ajudar os usuários técnicos, mas páginas modernas frequentemente adicionam conteúdo após a carga inicial do documento. Uma extensão do navegador pode inspecionar o contexto renderizado e apresentar resultados em uma interface orientada para revisão.
Para HTML colado ou fonte offline, use o Extrator de URLs de arquivos. Para a página ao vivo, use GrabAll para combinar descoberta com pré-visualizações e seleção de download.
Defina expectativas realistas
Arquivos por trás da autenticação, gerados após chamadas API protegidas, armazenados em sistemas privados, ou entregues através do DRM estão fora do escopo de um ferramenta de análise de página normal. Respeite as regras de acesso e use controles oficiais de download quando fornecidos. Filtro
Os melhores resultados vêm de páginas que expõem deliberadamente links de recursos, galerias, anexos, documentos ou arquivos de mÃdia comuns.
Perguntas frequentes
O GrabAll pode encontrar arquivos que não estão vinculados na página?
Não. Ele organiza recursos e links disponÃveis para o navegador; ele não pesquisa diretórios de servidores privados ou revela arquivos não expostos.
Devo digitalizar a página inicial ou uma página especÃfica?
Use a página mais especÃfica possÃvel. Ele produz menos arquivos não relacionados e resultados mais limpos.
E se uma URL não tem extensão de arquivo?
Ele ainda pode produzir um download, mas a classificação é menos confiável até que o servidor responda. Revise o rótulo da página e use o controle oficial quando for incerto.
Posso extrair links do HTML copiado em vez disso?
Sim. GrabAll fornece um Extrator de URLs de arquivos para HTML colado, código fonte e texto.
O GrabAll verifica a página e reúne imagens, documentos, mídia e outros arquivos disponíveis para download em uma lista organizada, para você escolher exatamente o que deseja salvar.