
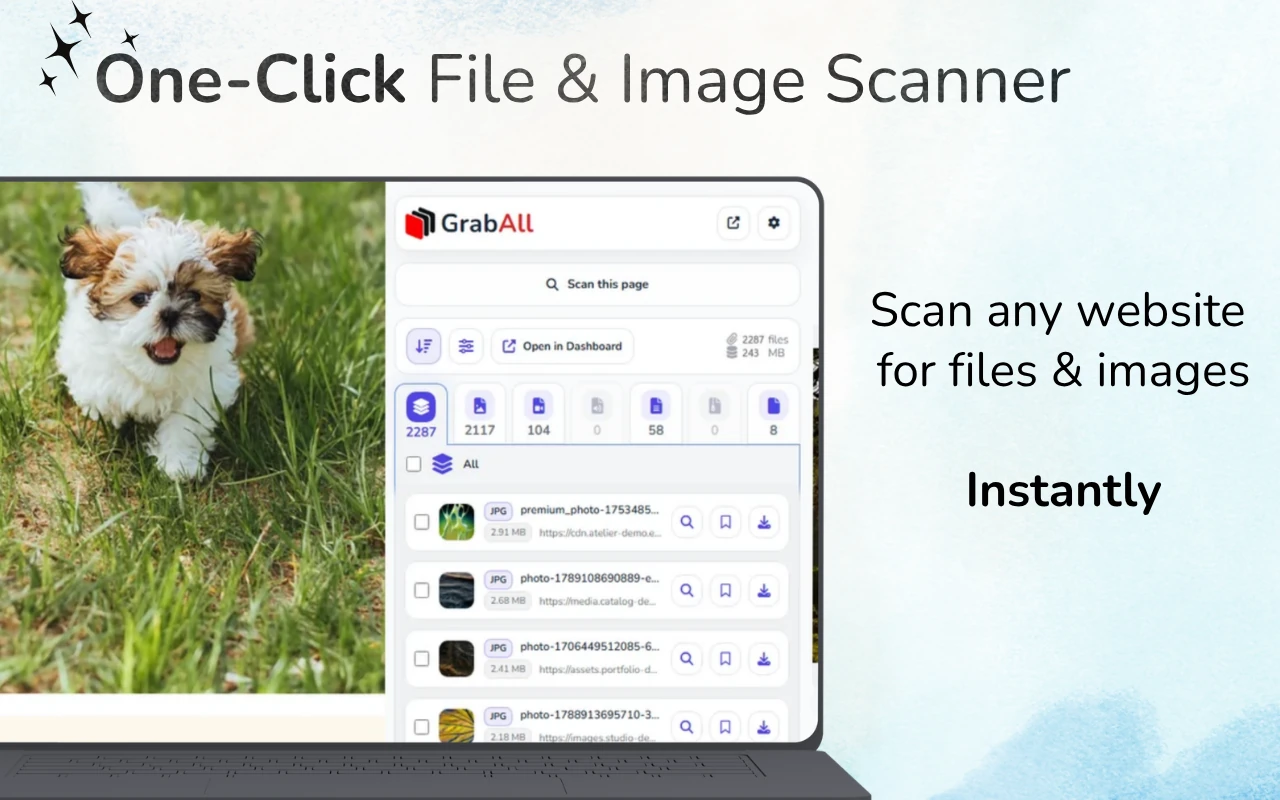
Răspuns rapid: Pentru o pagină web live, scanați cu GrabAll și copiați linkurile fișierelor detectate. Pentru HTML salvat sau cod sursă copiat, lipiți-l în Bulk File URL Extractor. Furnizați un URL de bază atunci când sursa conține linkuri relative.
Alege între scanarea unei pagini și analizarea HTML-ului copiat
Scanarea unei pagini web încărcate poate găsi fișiere disponibile în browser, în timp ce extractorul online citește doar HTML-ul sau textul pe care îl lipești. Alege metoda care corespunde punctului tău de plecare, apoi revizuiește URL-urile rezultate înainte de a le folosi pentru descărcări.
Unde apar URL-urile fișierelor în HTML
Link-urile obișnuite folosesc href, în timp ce imaginile și media utilizează de obicei src. Imaginile responsive pot lista mai mulți candidați în srcset. Bibliotecile de lazy-loading stochează adesea URL-urile reale în data-src, data-original sau atribute de date personalizate.
Fișierele stylesheet și CSS inline pot face referire la fundaluri prin url(). Textul brut poate conține de asemenea URL-uri complete care nu sunt atașate unui element HTML.
- href linkuri
- atributele src și poster
- candidații srcset și data-srcset
- Valori CSS url() și URL-uri absolute brute
Rezolvă corect căile relative
O valoare precum ../files/report.pdf are sens doar relativ la pagina de unde provine HTML-ul. Furnizează URL-ul paginii originale ca bază, astfel încât extractorul să poată transforma căile relative în adrese complete.
Linkurile relative la protocol care încep cu // moștenesc de obicei HTTPS pe o pagină securizată. Căile relative la rădăcină care încep cu / folosesc originea site-ului web curent.
- Păstrează URL-ul paginii sursă originale
- Folosește-l ca URL de bază
- Normalizează căile relative la protocol și la rădăcină
- Revizuiește domeniile rezolvate înainte de a folosi lista
Filtrează URL-urile candidate după intenție
Nu fiecare URL din codul sursă este un fișier descărcabil. Paginile conțin linkuri de navigare, API-uri, analitice, fonturi, scripturi, foi de stil și parametri de tracking. Filtrează după extensii relevante și inspectează URL-urile ambigue.
Pentru imagini, includeți formate moderne precum WebP și AVIF. Pentru documente, luați în considerare PDF, DOCX, XLSX, CSV, PPTX și arhive conform sarcinii.
HTML versus pagina randată
Sursa copiată reprezintă doar ceea ce ai furnizat. Este posibil să lipsească resurse inserate după rularea JavaScript, conținut încărcat după derulare sau URL-uri create în timpul interacțiunii.
Folosește extractorul offline pentru fragmente sursă, HTML exportat, șabloane de e-mail și revizuire de cod. Folosește extensia GrabAll pentru pagina redată în direct și fluxurile de lucru în contextul browserului.
Validează înainte de descărcare
Elimină duplicate din listă, inspectează domeniile și testează un mic eșantion. O extensie care se potrivește într-un URL nu garantează că răspunsul este valid sau că ai dreptul să îl folosești.
Evitați solicitarea automată a listelor mari neverificate. Validarea previne linkuri sparte, puncte de urmărire nedorite și încărcare inutilă.
Întrebări frecvente
Poate extractorul să rezolve linkuri relative ../?
Da, când furnizezi URL-ul paginii originale ca adresă de bază.
Extracția HTML include imaginile din srcset?
Unealta GrabAll verifică sursele comune și atributele imaginilor responsive, inclusiv candidații pentru srcset.
De ce lipsesc unele fișiere de pe paginile live din HTML-ul copiat?
JavaScript poate să le adauge după ce HTML-ul inițial se încarcă. Folosește extensia live a browserului pentru conținutul paginii redat și încărcat dinamic.
Sunt toate URL-urile extrase sigure pentru descărcare?
Nu. Revizuiește domeniile, tipurile de fișiere, permisiunile și un eșantion mic înainte de a folosi o listă de rezultate.
GrabAll scanează pagina și aduce imagini, documente, media și alte fișiere descărcabile într-o listă clară, astfel încât să poți alege exact ce să salvezi.