
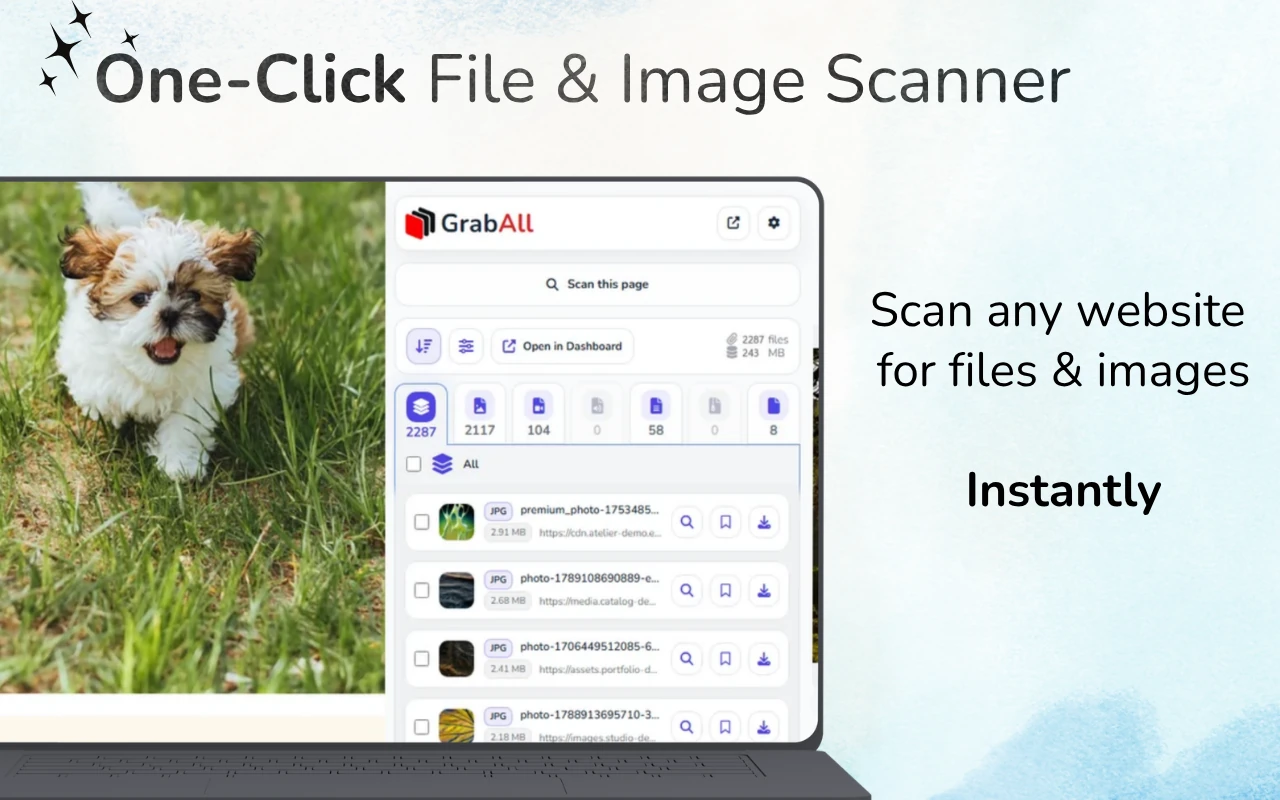
Быстрый ответ: Откройте веб-страницу, загрузите соответствующий контент и отсканируйте его с помощью GrabAll. Фильтруйте обнаруженные файлы по типу или размеру, проверяйте предварительный просмотр и имена файлов, затем сохраняйте или копируйте выбранные ссылки. Некоторые ресурсы появляются только после взаимодействия со страницей.
Ищите ссылки на файлы на загруженной странице
Кнопки загрузки, списки документов, карточки изображений и медиа-элементы могут предоставлять доступ к файлам. Начните с загрузки раздела, содержащего ресурсы, затем отсканируйте и просмотрите результаты. Сканер может перечислять только ресурсы, которые страница предоставляет браузеру.
Что считается загружаемым файлом
Загружаемый файл может представлять собой связанный документ, источник изображения, элемент мультимедиа, архив, электронную таблицу или другой общедоступный ресурс, на который ссылается страница. Браузер должен знать достаточно о ресурсе, чтобы запросить или отобразить его.
Обнаружение файлов не означает исследование сервера. GrabAll работает с текущей страницей и предоставленными URL-адресами, а не с частными каталогами или неуказанным содержимым сервера.
- Привязка ссылок к документам и архивам
- Image src, srcset и атрибуты отложенной загрузки
- Видео, аудио, плакаты и исходные элементы
- Общедоступные URL-адреса файлов, присутствующие в тексте страницы или атрибутах данных
Структурированный процесс обнаружения
Сначала отсканируйте наиболее релевантную страницу. Группируйте результаты по типу, затем проверяйте расширения файлов, подсказки MIME, размеры, размеры и исходные домены. Используйте предварительный просмотр, где это возможно.
Если страница динамическая, разрешите загрузку соответствующего раздела перед сканированием. Избегайте прокрутки несвязанных областей, поскольку это может добавить рекомендации и ресурсы навигации в набор результатов.
- Выберите конкретную страницу
- Загрузите контент, соответствующий задаче
- Сканировать и группировать результаты по типу
- Фильтрация, предварительный просмотр и выбор полезных файлов
URL-адреса без очевидных расширений
Некоторые загрузки используют такие маршруты, как /download?id=123, вместо имен файлов, заканчивающихся на .pdf или .zip. Эти ссылки может быть сложнее классифицировать до того, как сервер ответит. Метки страниц, заголовки ответов и поведение загрузки браузера могут предоставить дополнительную информацию.
Не думайте, что каждый длинный URL-адрес является файлом. Ссылки на отслеживание, навигацию и API могут выглядеть одинаково.
Когда сканирование лучше, чем просмотр исходного кода
Просмотр исходного кода HTML может помочь техническим пользователям, но современные страницы часто добавляют контент после загрузки исходного документа. Расширение браузера может проверять отображаемый контекст и представлять результаты в ориентированном на обзор интерфейсе.
Для вставленного HTML или автономного источника используйте бесплатный массовый экстрактор URL-адресов файлов. Для активной страницы используйте GrabAll, чтобы можно было комбинировать обнаружение с предварительным просмотром и выбором загрузки.
Установите реалистичные ожидания
Файлы, требующие аутентификации, создаваемые после защищенных вызовов API, хранящиеся в частных системах или доставляемые через DRM, находятся за пределами обычного сканера страниц. Соблюдайте правила доступа и используйте официальные средства управления загрузкой, где это предусмотрено.
Наилучшие результаты получаются на страницах, которые намеренно предоставляют ссылки на ресурсы, галереи, вложения, документы или обычные медиафайлы.
Часто задаваемые вопросы
Может ли GrabAll найти файлы, на которые нет ссылок на странице?
Нет. Он организует ресурсы и ссылки, доступные браузеру; он не выполняет поиск в частных каталогах сервера и не выявляет неоткрытые файлы.
Следует ли мне сканировать домашнюю страницу или конкретную страницу?
Используйте максимально конкретную страницу. Это дает меньше несвязанных активов и более чистые результаты.
Что делать, если URL-адрес не имеет расширения файла?
Загрузка по-прежнему может производиться, но классификация менее надежна, пока сервер не ответит. Просмотрите метку страницы и используйте официальный элемент управления, если не уверены.
Могу ли я вместо этого извлечь ссылки из скопированного HTML?
Да. GrabAll предоставляет бесплатный массовый экстрактор URL-адресов файлов для вставки HTML, исходного кода и текста.
GrabAll сканирует страницу и объединяет изображения, документы, мультимедиа и другие загружаемые файлы в один понятный список, чтобы вы могли точно выбрать, что сохранять.