

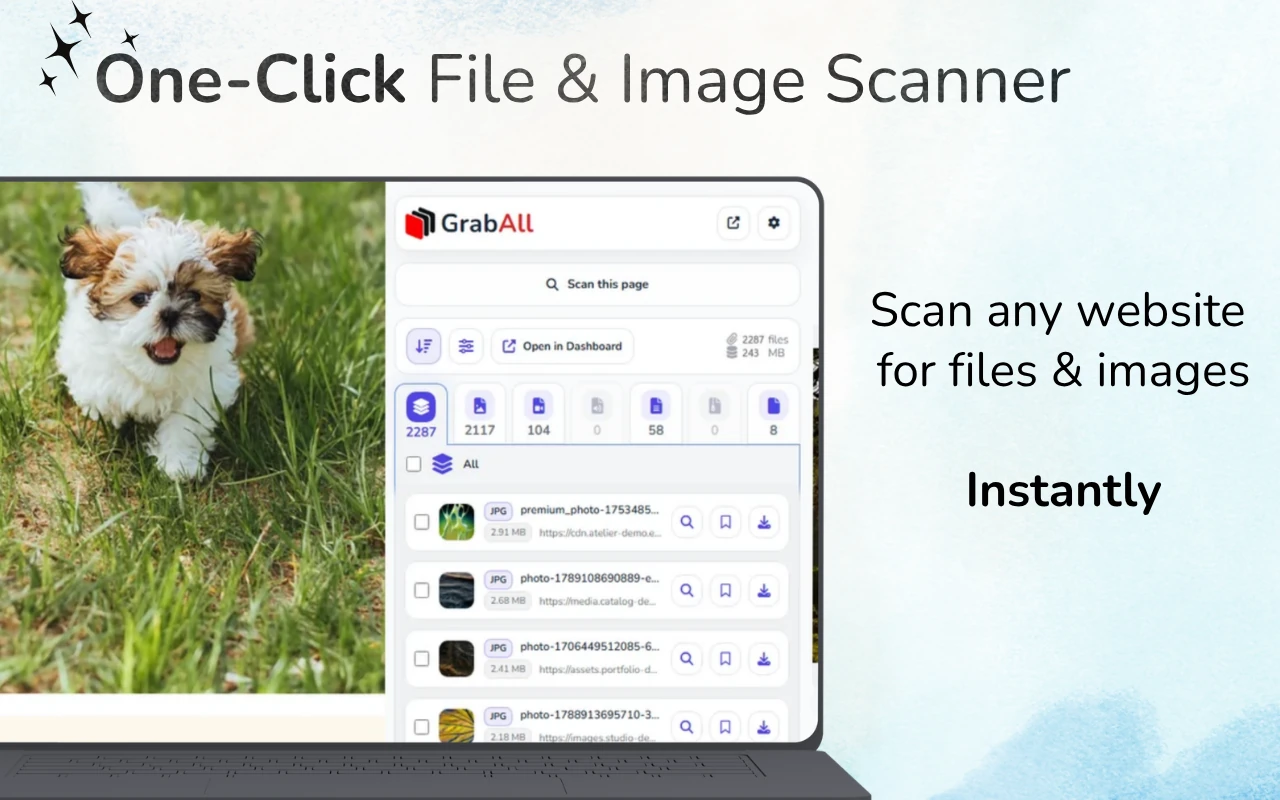
Snabbt svar: Öppna webbsidan, ladda relevant innehåll och skanna den med GrabAll. Filtrera upptäckta filer efter typ eller storlek, kontrollera förhandsvisningar och filnamn, och spara eller kopiera sedan de valda länkarna. Vissa resurser visas endast efter en sidinteraktion.
Sök efter fillänkar på den laddade sidan
Nedladdningsknappar, dokumentlistor, bildkort och medieelement kan alla exponera filer. Börja med att ladda sektionen som innehåller resurserna, skanna sedan och granska resultaten. En skanner kan bara lista resurser som sidan gör tillgängliga för webbläsaren.
Vad som räknas som en nedladdningsbar fil
En nedladdningsbar fil kan vara ett länkat dokument, en bildkälla, ett medieelement, ett arkiv, ett kalkylblad eller en annan offentlig resurs som refereras av sidan. Webbläsaren måste veta tillräckligt om resursen för att kunna begära eller visa den.
Filupptäckt betyder inte serverutforskning. GrabAll fungerar med den aktuella sidan och tillhandahållna URL:er, inte med privata kataloger eller olistat serverinnehåll.
- Anchor-länkar till dokument och arkiv
- Bildens src, srcset och lazy-load attribut
- Video-, ljud-, affisch- och källkomponenter
- Publika fil-URL:er som finns i sidtext eller data-attribut
En strukturerad upptäcktsprocess
Skanna den mest relevanta sidan först. Gruppera resultaten efter typ, inspektera sedan filändelser, MIME-ledtrådar, dimensioner, storlekar och källdomäner. Använd förhandsgranskningar där det är tillgängligt.
Om sidan är dynamisk, låt den relevanta sektionen laddas innan skanning. Undvik att scrolla genom orelaterade områden eftersom det kan lägga till rekommendationer och navigeringsresurser i resultatmängden.
- Välj en specifik sida
- Ladda innehållet som är relevant för uppgiften
- Skanna och gruppera resultat efter typ
- Filtrera, förhandsgranska och välj användbara filer
URL:er utan uppenbara filändelser
Vissa nedladdningar använder rutter såsom /download?id=123 istället för filnamn som slutar på .pdf eller .zip. Dessa länkar kan vara svårare att klassificera innan servern svarar. Sidetiketter, svarshuvuden och webbläsarens nedladdningsbeteende kan ge mer information.
Anta inte att varje lång URL är en fil. Spårnings-, navigations- och API-länkar kan se likadana ut.
När skanning är bättre än att visa källan
Att se HTML-källkoden kan hjälpa tekniska användare, men moderna sidor lägger ofta till innehåll efter att det initiala dokumentet har laddats. Ett webbläsartillägg kan inspektera det renderade sammanhanget och presentera resultaten i ett granskningsorienterat gränssnitt.
För inklistrad HTML eller offlinekällor, använd gratisversionen av Bulk File URL Extractor. För live-sidan, använd GrabAll så att du kan kombinera upptäckt med förhandsgranskningar och nedladdningsval.
Sätt realistiska förväntningar
Filer bakom autentisering, genererade efter skyddade API-anrop, lagrade i privata system eller levererade via DRM ligger utanför en normal sidscanners räckvidd. Respektera åtkomsträttigheter och använd officiella nedladdningskontroller när de finns.
De bästa resultaten kommer från sidor som medvetet exponerar resurslänkar, gallerier, bilagor, dokument eller vanliga mediefiler.
Vanliga frågor
Kan GrabAll hitta filer som inte är länkade på sidan?
Nej. Den organiserar resurser och länkar som är tillgängliga i webbläsaren; den söker inte i privata serverkataloger eller avslöjar oexponerade filer.
Ska jag genomsöka hemsidan eller en specifik sida?
Använd den mest specifika sidan som möjligt. Det ger färre orelaterade resurser och renare resultat.
Vad händer om en URL saknar filtillägg?
Det kan fortfarande generera en nedladdning, men klassificeringen är mindre pålitlig tills servern svarar. Granska sidans etikett och använd den officiella kontrollen när du är osäker.
Kan jag istället extrahera länkar från kopierad HTML?
Ja. GrabAll erbjuder en gratis Bulk File URL Extractor för inklistrad HTML, källkod och text.
GrabAll skannar sidan och samlar bilder, dokument, media och andra nedladdningsbara filer i en tydlig lista, så att du kan välja exakt vad som ska sparas.