
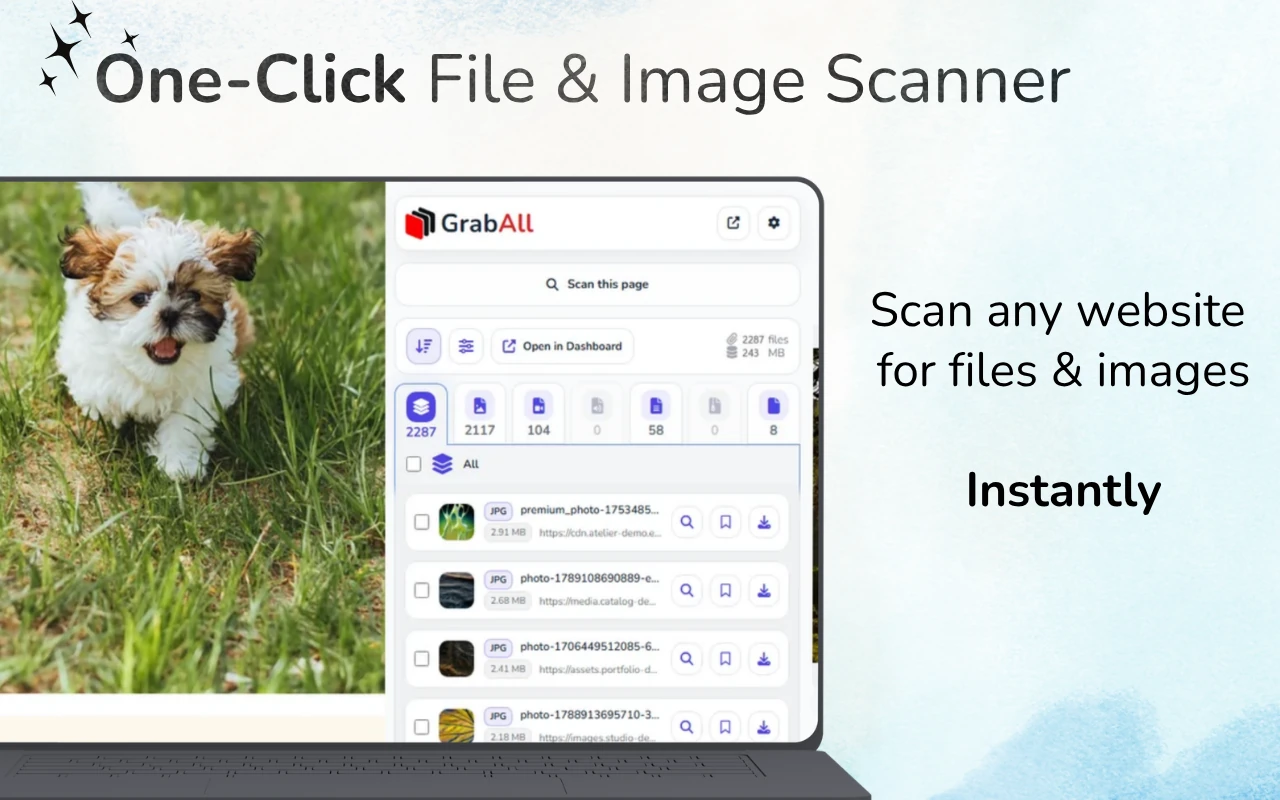
Jibu la haraka: Kwa ukurasa wa wavuti unaoishi, piga scan na GrabAll na nakili viungo vya faili vilivyo patikana. Kwa HTML iliyohifadhiwa au chanzo kilichonakiliwa, weka kwenye Bulk File URL Extractor. Toa URL ya msingi wakati chanzo kinajumuisha viungo vya karibu.
Chagua kati ya kuchunguza ukurasa na kuchambua HTML iliyobanwa
Kuchanganua ukurasa uliopakiwa kunaweza kupata faili zinazopatikana katika kivinjari, wakati extractor mtandaoni husoma tu HTML au maandishi unayoandika. Chagua njia inayolingana na chanzo chako, kisha pitia URL zinazotokana kabla ya kuzitumia kupakua.
Mahali URL za faili huonekana katika HTML
Viungo vya kawaida hutumia href, wakati picha na vyombo vya habari kawaida hutumia src. Picha zinazojibika zenyewe zinaweza kuorodhesha wagombea kadhaa katika srcset. Maktaba ya lazy-loading mara nyingi hugawa URL halisi kwenye data-src, data-original, au sifa maalum za data.
Majedwali ya mtindo na CSS ya ndani yanaweza kurejelea mashuka kupitia url(). Maandishi ghafi pia yanaweza kuwa na URL kamili ambazo hazina kiambatanisho cha HTML.
- viungo vya href
- sifa za src na poster
- wateule wa srcset na data-srcset
- Thamani za CSS url() na URL kamili zilizopo
Tatua njia zinazohusiana kwa usahihi
Thamani kama vile .. /files/report.pdf ina maana tu kuhusiana na ukurasa ambao HTML ilitoka. Toa URL ya ukurasa asili kama msingi ili mchimbaji aweze kugeuza njia za jamaa kuwa anwani kamili.
Viungo vya itifaki-visivyo na moja kwa moja vinavyoanza na // kawaida vinapakiana HTTPS kwenye ukurasa salama. Njia zinazoanzia mzizi zinazoanza na / hutumia asili ya wavuti ya sasa.
- Weka URL ya ukurasa wa chanzo asili
- Tumia kama URL msingi
- Sawaisha njia zinazohusiana na itifaki na mizizi
- Angalia maeneo yaliyo tatuliwa kabla ya kutumia orodha
Chuja URL zinazowezekana kwa nia
Sio URL zote katika chanzo cha msimbo ni mali inayoweza kupakuliwa. Kurasa zina viungo vya urambazaji, API, uchambuzi, fonti, scripts, majedwali ya mitindo, na vigezo vya ufuatiliaji. Chuja kwa ugani husika na kagua URL zinazoshuku.
Kwa picha, jumuisha fomati za kisasa kama WebP na AVIF. Kwa nyaraka, zingatia PDF, DOCX, XLSX, CSV, PPTX, na kumbukumbu kulingana na kazi.
Chanzo cha HTML dhidi ya ukurasa uliotolewa
Chanzo kilichobandikwa kinaonyesha tu kile ulicho chanusha. Kinaweza kukosa rasilimali zilizowekwa baada ya JavaScript kuendesha, maudhui yaliyopakiwa baada ya skrini kuteremka, au URL zilizoundwa wakati wa mwingiliano.
Tumia extractor wa offline kwa vipande vya vyanzo, HTML iliyohamishwa, templeti za barua pepe, na uchambuzi wa msimbo. Tumia kiendelezi cha GrabAll kwa ukurasa uliyoonyeshwa moja kwa moja na michakato ya muktadha wa kivinjari.
Hakikisha kabla ya kupakua
Futa rudufu kwenye orodha, kagua domaine, na jaribu sampuli ndogo. Kiambatanisho kinacholingana kwenye URL hakihakikishi kuwa jibu ni sahihi au kwamba umeidhinishwa kuvitumia.
Epuka kuomba kiotomatiki orodha kubwa ambazo hazijakaguliwa. Uthibitisho unazuia viungo vilivyovunjika, vituo vya ufuatiliaji visivyohitajika, na mzigo usio wa lazima.
Maswali yanayoulizwa mara kwa mara
Je, extractor inaweza kutatua viungo vinavyohusiana ../?
Ndiyo, unapotoa URL ya ukurasa asili kama anwani ya msingi.
Je, kutoa HTML inajumuisha picha za srcset?
Chombo cha GrabAll hukagua vigezo vya kawaida vya chanzo na picha zinazojibu, ikiwa ni pamoja na wagombea wa srcset.
Kwa nini baadhi ya faili za ukurasa wa moja kwa moja zinakosekana kutoka HTML iliyokopiwa?
JavaScript inaweza kuziongeza baada ya upakiaji wa awali wa HTML. Tumia kiendelezi cha kivinjari cha moja kwa moja kwa yaliyomo kwenye ukurasa yaliyotolewa na yaliyopakiwa kwa nguvu.
Je, URL zote zilizotolewa zina usalama wa kupakuliwa?
Hapana. Kagua kikoa, aina za faili, vibali, na sampuli ndogo kabla ya kutumia orodha ya matokeo.
GrabAll huchanganua ukurasa na kuleta picha, hati, midia na faili zingine zinazoweza kupakuliwa kwenye orodha moja wazi, ili uweze kuchagua nini cha kuhifadhi.