
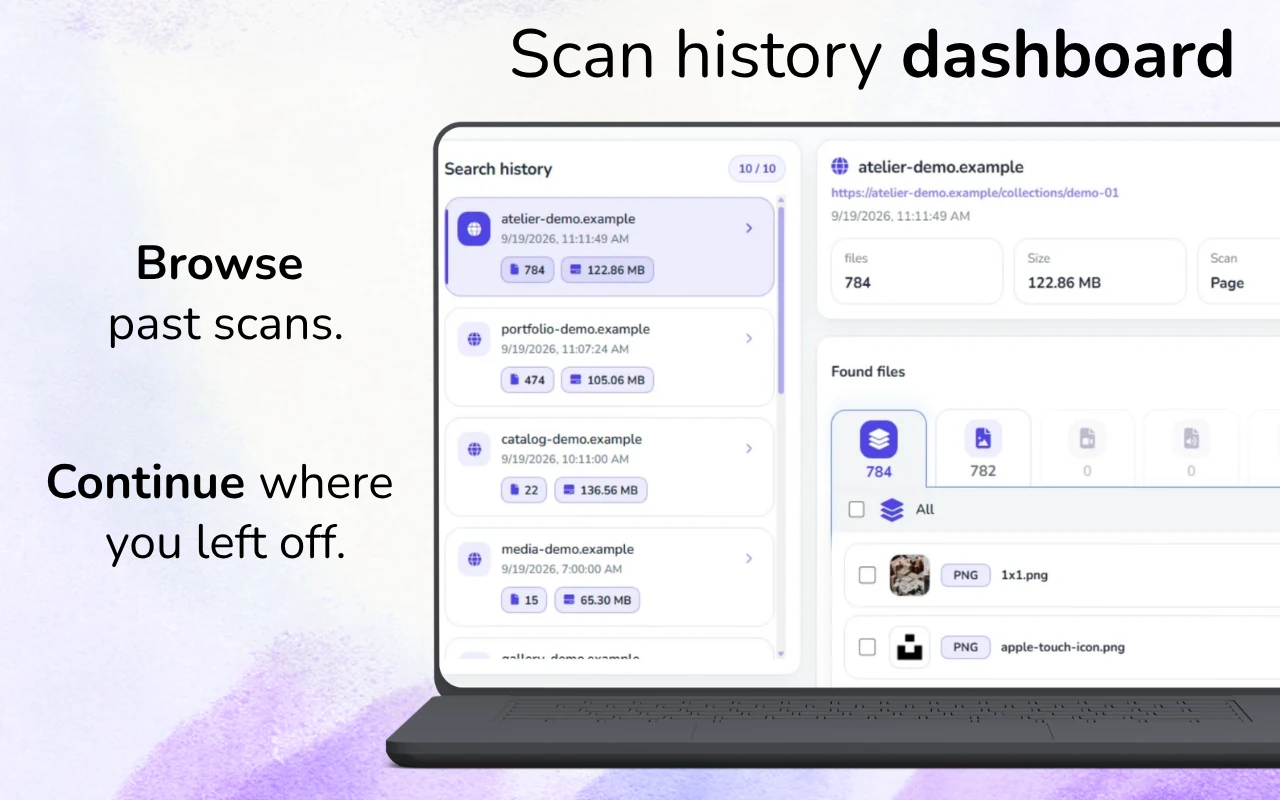
快速回答: 扫描列出文档的页面,将结果筛选为 PDF 或其他文档格式,然后选择并下载所需文件。批量扫描可以从多个打开的页面收集文档链接;导入页面 URL 列表需要高级版。
在网页上查找 PDF、Word 和电子表格下载。
从资源列表、报告归档或包含文档链接的课程页面开始。GrabAll 可以将可访问的 PDF、DOCX、XLSX、CSV 等文件 URL 收集到一个列表中。在保存多个文档之前,请检查文件名和源链接。
文档链接通常出现的位置
PDF 和办公文档通常来自资源列表、表格、下载按钮、卡片、脚注和归档页面。一些页面使用描述性锚文本,而其他页面仅显示通用按钮。
GrabAll 将文件链接收集到一个预览界面,使比较名称和格式比在每个单独标签页中打开文档更容易。
- PDF 报告和手册
- DOCX、ODT 和 RTF 文档
- XLSX电子表格和CSV数据
- PPTX 演示文稿和 ZIP 压缩包
一个干净的文档收集工作流程
打开包含所需文档的最窄页面。扫描它,过滤为文档格式,并排序列表以便相关文件名保持在一起。
在可用时预览 PDF 并在下载前检查文件名。如果名称通用,请单独记录链接文本或来源页面,以便将来文件仍可理解。
- 扫描资源或归档页面
- 过滤为 PDF 和文档扩展名
- 查看文件名、重复文件和文件大小
- 将所选批次下载到专用项目文件夹
嵌入的PDF查看器不同于直接链接
浏览器 PDF 查看器可以显示公共 PDF URL,但有些网站查看器通过脚本、临时令牌或验证 API 加载页面。在这些情况下,可见的查看器并不能证明存在永久的公共文件链接。
防止重复和过时的文档
归档可能列出修订版、语言变体、附录以及来自多个导航区域的重复链接。在保存所有内容之前,请比较文件名、日期、文件大小和附近页面标签。
对于合规或研究工作,请记录页面 URL 和访问日期。即使 URL 未更改,名为 report-final.pdf 的文件以后也可能被替换。
整理下载的文件集
将源文件与编辑后的副本分开。使用文件夹按项目、年份、文档类型或发布者分类,并在保留原始文件名后再改名。
常见问题解答
GrabAll 可以从一个页面下载多个 PDF 吗?
是的,当页面公开可访问的 PDF 链接时。将扫描结果筛选为 PDF,选择相关文件,然后批量下载。
为什么嵌入的文档会丢失?
查看器可能使用临时、已认证、脚本化或分段的传输方式,而不是直接的公共文件 URL。
我也能收集电子表格和演示文稿吗?
是的。GrabAll 可以组织浏览器可访问的常见文档、电子表格、演示文稿、CSV 和归档链接。
我应该如何处理重复报告?
比较文件名、标签、日期、URL 和文件大小,然后保留与你的工作相关的版本。
GrabAll 扫描页面并将图片、文档、媒体和其他可下载文件列入清晰列表,以便您选择具体要保存的内容。