
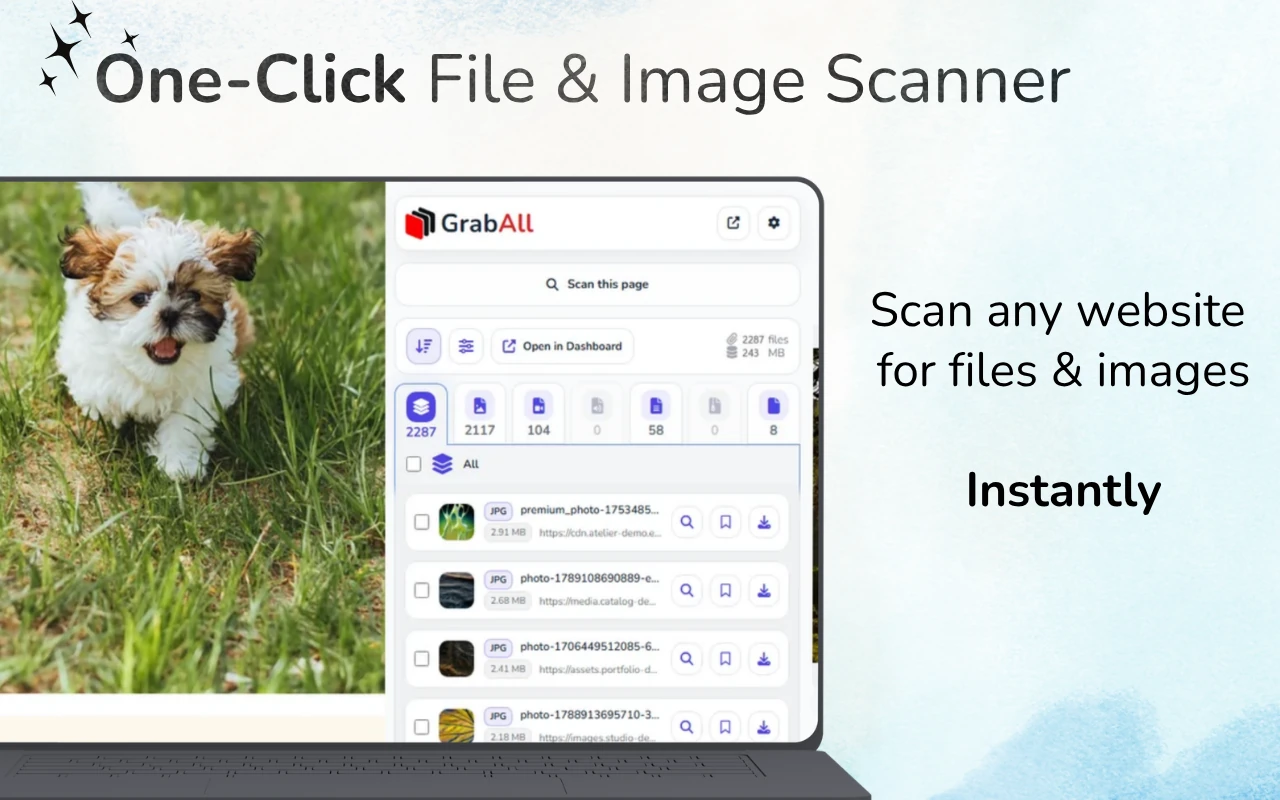
快速回答: 打开网页,加载相关内容并用 GrabAll 扫描。按类型或大小过滤检测到的文件,检查预览和文件名,然后保存或复制选定链接。有些资源只有在页面交互后才会出现。
在加载的页面中查找文件链接
下载按钮、文档列表、图片卡片和媒体元素都可能暴露文件。首先加载包含这些资源的部分,然后扫描并查看结果。扫描器只能列出网页提供给浏览器的资源。
什么算作可下载文件
可下载文件可以是链接文档、图像源、媒体元素、档案、电子表格或页面引用的其他公开资源。浏览器必须对该资源有足够的了解才能请求或显示它。
文件发现并不意味着服务器探索。GrabAll 仅处理当前页面和提供的 URL,而不处理私人目录或未列出的服务器内容。
- 文档和归档的锚点链接
- 图片的 src、srcset 和懒加载 (lazy-load) 属性
- 视频、音频、海报和源元素
- 页面文本或数据属性中存在的公共文件 URL
一个结构化的发现流程
优先扫描最相关的页面。按类型分组结果,然后检查文件扩展名、MIME 提示、尺寸、大小和来源域名。在可用时使用预览。
如果页面是动态的,请允许相关部分加载完毕后再进行扫描。避免在无关区域滚动,因为这可能会将推荐内容和导航资源添加到结果集中。
- 选择特定页面
- 加载与任务相关的内容
- 扫描并按类型分组结果
- 过滤、预览并选择有用文件
没有明显扩展名的 URL
某些下载使用像 /download?id=123 这样的路径,而不是以 .pdf 或 .zip 结尾的文件名。在服务器响应之前,这些链接可能更难分类。页面标签、响应头和浏览器下载行为可能提供更多信息。
不要假设每个长 URL 都是文件。跟踪、导航和 API 链接可能看起来相似。
何时扫描比查看源代码更好
查看 HTML 源代码可以帮助技术用户,但现代页面经常在初始文档加载后添加内容。浏览器扩展可以检查渲染后的上下文,并以审查为导向的界面呈现结果。
对于粘贴的 HTML 或离线源,请使用免费的批量文件 URL 提取器。对于实时页面,请使用 GrabAll,以便您结合发现、预览和下载选择。
设定现实的期望
需要身份验证的文件、在受保护的 API 调用后生成的文件、存储在私人系统中的文件或通过 DRM 提供的文件,均不在普通页面扫描器的范围内。请遵守访问规则,并在提供官方下载控制时使用之。
最好的结果来自那些故意公开资源链接、图库、附件、文档或普通媒体文件的页面。
常见问题解答
GrabAll 能找到页面上没有链接的文件吗?
不。它整理浏览器可用的资源和链接;它不会搜索私人服务器目录或显示未公开的文件。
我应该扫描主页还是特定页面?
尽可能使用最具体的页面。它会产生更少的不相关资源和更干净的结果。
如果URL没有文件扩展名怎么办?
它仍然可能生成下载,但在服务器响应之前,分类的可靠性较低。在不确定时,请查看页面标签并使用官方控件。
我可以从复制的 HTML 中提取链接吗?
是的。GrabAll 提供免费的批量文件 URL 提取器,可用于粘贴的 HTML、源代码和文本。
GrabAll 扫描页面并将图片、文档、媒体和其他可下载文件列入清晰列表,以便您选择具体要保存的内容。