
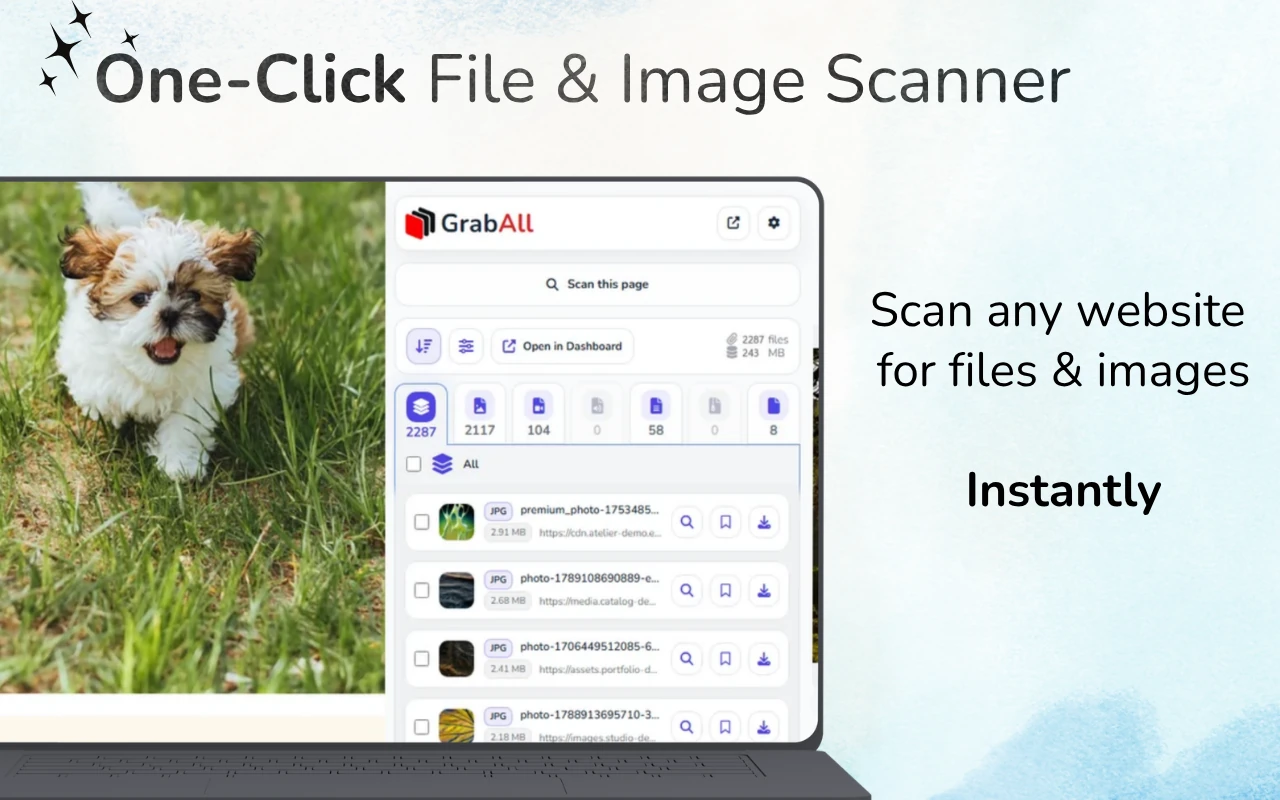
快速回答: 打开包含文件的页面,用 GrabAll 扫描,过滤列表并选择要下载的内容。使用 Premium 可以将选定的文件单独保存或打包为 ZIP。如果文件分布在多个页面上,可通过打开的标签页或导入的 URL 列表扫描这些页面。
逐步从网页下载链接文件
批量文件下载器会收集页面上的文件链接,以便你可以一起查看。请从实际列出下载内容的页面开始,例如资源库或产品页面。此工具下载选定的文件;它不会创建整个网站的离线副本。
为什么逐个下载文件效率低?
当页面仅包含一份文档或少量明显图片时,手动保存是合理的。当有用文件与缩略图、图标、重复链接、跟踪 URL、自适应图片变体及无关页面资产混合时,保存速度会变慢。
批量工作流程将查找文件与下载文件分开。你首先创建一个可审核的列表,然后决定哪些文件属于最终批次。这可以防止意外下载,并使过程更易于重复。
- 如 JPG、PNG、WebP、SVG、GIF 和 AVIF 格式的图片
- PDF、文档、电子表格、演示文稿、CSV 文件和归档
- 直接暴露给浏览器的视频和音频文件
- 页面或提供的 URL 列表中存在的其他公共文件链接
一个实用的逐步工作流程
打开包含您被允许收集的资源的确切页面。运行 GrabAll,等待扫描完成,并在开始下载之前检查结果。
先使用文件类型过滤器,然后使用大小和图像分辨率过滤器。预览模糊的项目,删除微小的装饰性资源,如果想在下载前保留记录,则复制最终链接。
- 扫描当前页面
- 按文件类型、大小或图像尺寸过滤
- 预览并仅选择相关结果
- 下载所选批次或在可用时使用ZIP导出
选择正确的扫描模式
当前页面扫描最适合单个画廊、产品页面、资源页面或文档页面。打开标签页扫描在相同研究任务跨越多个页面时非常有用。导入 URL 扫描针对需要可重复批量工作流程的准备列表设计。
从最小的有用范围开始。扫描更少、选择更好的页面会产生更干净的结果集合并减少重复文件。
文件缺失的常见原因
可见按钮并不总是指向直接文件。一些网站在API请求后生成下载文件,要求经过身份验证的会话,或者通过分段格式流式传输媒体。扫描器可以组织浏览器可用的资源,但不能制造页面从未公开过的公开文件URL。
如果结果缺失,请确认文件在当前浏览器会话中可以加载,允许页面完成呈现,并扫描最具体的页面,而不是宽泛的主页。
- 资产仅在交互后加载
- 链接是临时的或需要身份验证
- 页面使用受保护的流或 Blob URL
- 可见项目是 CSS 背景、缩略图或生成的预览。
常见问题解答
我能从任何网站下载所有文件吗?
不。GrabAll 可以整理浏览器可用的文件和链接。它不会绕过身份验证、付费墙、DRM、私人存储或技术访问限制。
我应该先过滤什么?
从文件类型开始,然后使用文件大小或图像分辨率去除图标、缩略图和不相关的资产。
GrabAll 能扫描多个页面吗?
是的。根据可用的工作流程和计划,对于浏览器中已经打开的页面,请使用打开标签页扫描;对于准备好的 URL 列表,请使用导入 URL 扫描。
我应该为每个批次使用 ZIP 导出吗?
ZIP 导出适用于有组织的批量处理,但当文件非常大或需要保持分开时,普通下载可能更好。
GrabAll 扫描页面并将图片、文档、媒体和其他可下载文件列入清晰列表,以便您选择具体要保存的内容。