
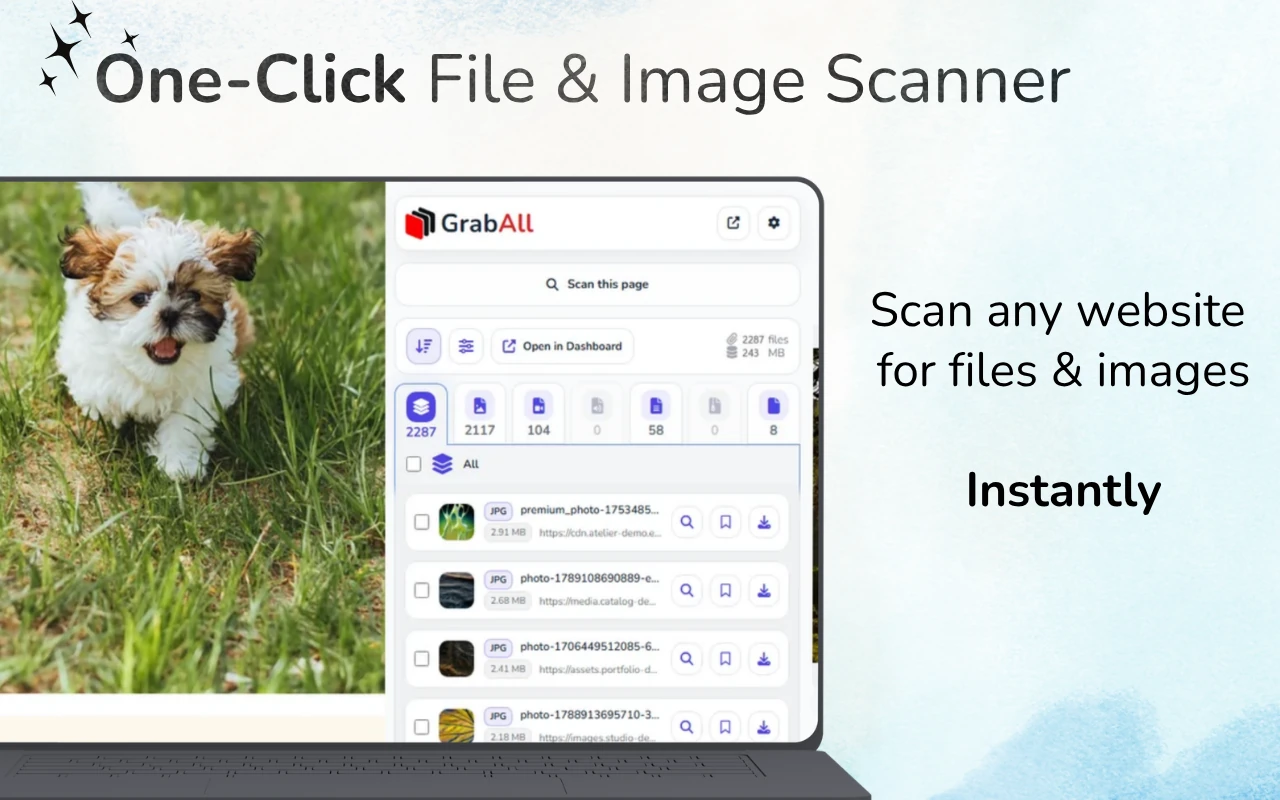
快速回答: 打开包含文件的页面,使用 GrabAll 批量扫描打开的标签页,然后过滤并检查收集到的结果。仅下载所需的文件。免费计划可使用打开标签页扫描,但受下载限制。
从多个浏览器标签页收集文件
为每个资源页面、产品页面或文档列表使用一个标签页进行扫描。Mass Scan 收集结果后,一起查看文件类型和来源。这可以减少当项目跨越多个网页时的重复扫描。
何时选择打开标签页扫描
当你已经在浏览器中选定了一组可管理的页面时,打开标签页扫描效果很好。例如:某供应商的多个产品页面、一组报告、短画廊合集或某项目的文档页面。
它不太适合处理数百个未经审核的 URL。对于准备好的大列表,导入 URL 扫描提供了更清晰的工作流程。
- 一次研究会话中的多个页面
- 少量报告或产品页面集合
- 打开需要当前浏览器会话的资源
- 扫描前需要最终视觉检查的页面
扫描前准备标签页
关闭无关的社交、电子邮件、仪表板和搜索标签页。在一个浏览器窗口中分组目标页面,确认每个页面正确加载,并在开始前移除重复页。
此准备工作可防止无关图标、附件和媒体进入合并结果集。
- 为任务使用一个浏览器窗口
- 关闭无关和重复标签页
- 允许相关页面内容加载
查看组合结果集
扫描完成后,按项目所需的文件类别筛选。必要时按来源、文件名、文件大小或图像尺寸排序。当多个页面共享导航资产或相同的产品图片时,可能会出现重复的 URL。
扫描后不要立即下载。短时间的复查通常可以删除大量重复的界面内容。
控制带宽和存储
多标签页扫描可以显示许多大文件。估算批量大小,只选择相关项目,并将非常大的下载分成较小的组。
较小的批次更容易重试和整理。它们还能减少浏览器下载限制或服务器速率控制中断任务的可能性。
保持来源可追溯
当来自多个页面的文件被合并时,源上下文可能丢失。在重命名前保留URL或导出文件列表。使用记录站点、主题或收集日期的项目文件夹结构。
常见问题解答
我一次应该扫描多少个标签页?
使用能代表一个任务的最小组。较小的专注集更易于审查,处理更快,并且不太可能包含重复项。
为什么打开标签页扫描会包含重复文件?
同一网站上的页面通常会重复使用标志、导航资源、缩略图和共享文档。
GrabAll 能扫描需要认证的标签页吗?
在允许的当前浏览器环境中它可以工作,但它不会绕过账户限制或授予下载私人材料的权限。
我什么时候应该使用导入的URL?
使用已导入的 URL 处理准备好的列表,当列表太大或结构复杂而无法舒适地作为打开的标签页管理时。
GrabAll 扫描页面并将图片、文档、媒体和其他可下载文件列入清晰列表,以便您选择具体要保存的内容。