
快速回答: 准备您要扫描的网页 URL,将它们导入 GrabAll Premium 并运行批量扫描。查看这些页面上找到的文件链接,筛选结果并下载所选内容。提供的列表控制扫描哪些页面。
使用页面 URL 列表进行批量扫描
页面URL指向要扫描的网页;直接文件URL指向文件本身。围绕包含所需资源的页面准备列表。GrabAll不会自动发现域上的每个页面,因此请明确包含相关页面。
从干净的 URL 列表开始
删除空白行、重复、片段、跟踪参数和明显的导航 URL。每行保留一个 URL,并尽可能使用完整的 HTTPS 地址。
GrabAll 免费的 URL 列表清理器可以在 URL 列表用于更大工作流程之前进行去重和排序。
- 每行一个完整 URL
- 没有重复或不相关的页面
- 一致的协议和域名格式
将大型项目拆分为逻辑批次
按网站、类别、客户、日期或资源类型对 URL 进行分组。一批相关页面产生的结果比来自多个无关来源的混合列表更容易筛选和命名。
先从小样本开始,以确认页面是否暴露预期的文件。只有在样本产生有用结果后,才扩大批处理规模。
- 测试一个小的代表性样本
- 将相似的 URL 分组
- 设置实际批量大小
- 将失败或重定向的页面单独记录
处理重定向、失败和动态页面
某些网址会重定向、需要认证、返回错误,或仅在交互后加载重要内容。将这些视为例外,而不是反复扫描整个列表。
如果一个页面需要手动会话或视觉确认,请将其移动到开放标签工作流程。导入扫描在稳定、可直接访问的页面上效果最佳。
查看来自多个来源的文件
合并结果可能包含共享的标志、重复下载、缩略图以及多个页面链接到的相同文档。按类型和大小筛选,然后按 URL 和可见元数据去重。
在下载前保留输入列表和导出链接的副本。如果需要稍后检查批次,这会创建可重复记录。
对自动批处理要考虑周到
大型扫描会向网站发出请求。保持批量合理,避免不必要的重复,如果网站显示速率限制或要求使用其他访问方式,请停止。
常见问题解答
我应该如何格式化导入的 URL 列表?
每行使用一个完整的 HTTP 或 HTTPS URL,删除重复项,并使列表集中于与某一任务相关的页面。
为什么要先测试小样本?
示例可以确认页面类型公开有用文件,并帮助您在处理更大批量之前选择筛选器。
需要互动的页面我应该怎么处理?
将它们移动到开放标签工作流,在扫描之前手动加载和确认内容。
URL 扫描会绕过认证吗?
不。它仅适用于通过允许的浏览器工作流可访问的页面和文件。
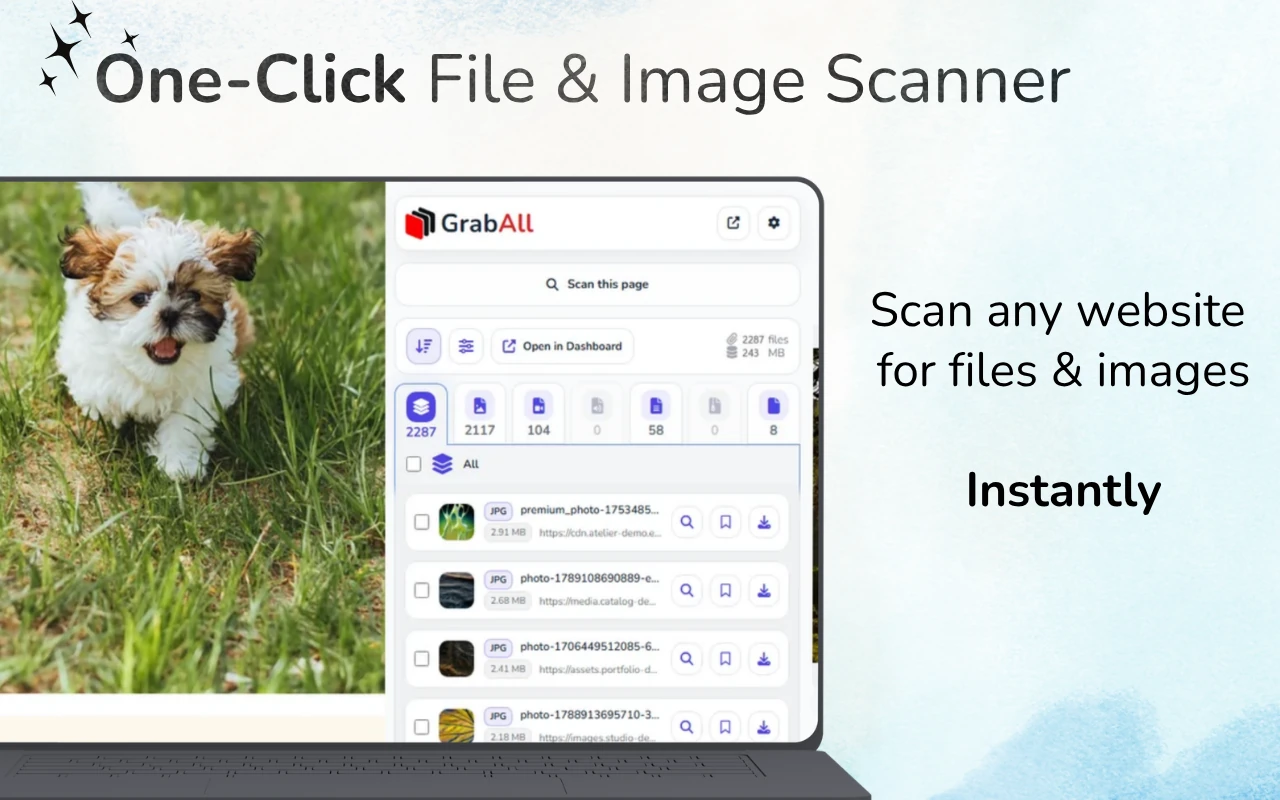
GrabAll 扫描页面并将图片、文档、媒体和其他可下载文件列入清晰列表,以便您选择具体要保存的内容。