

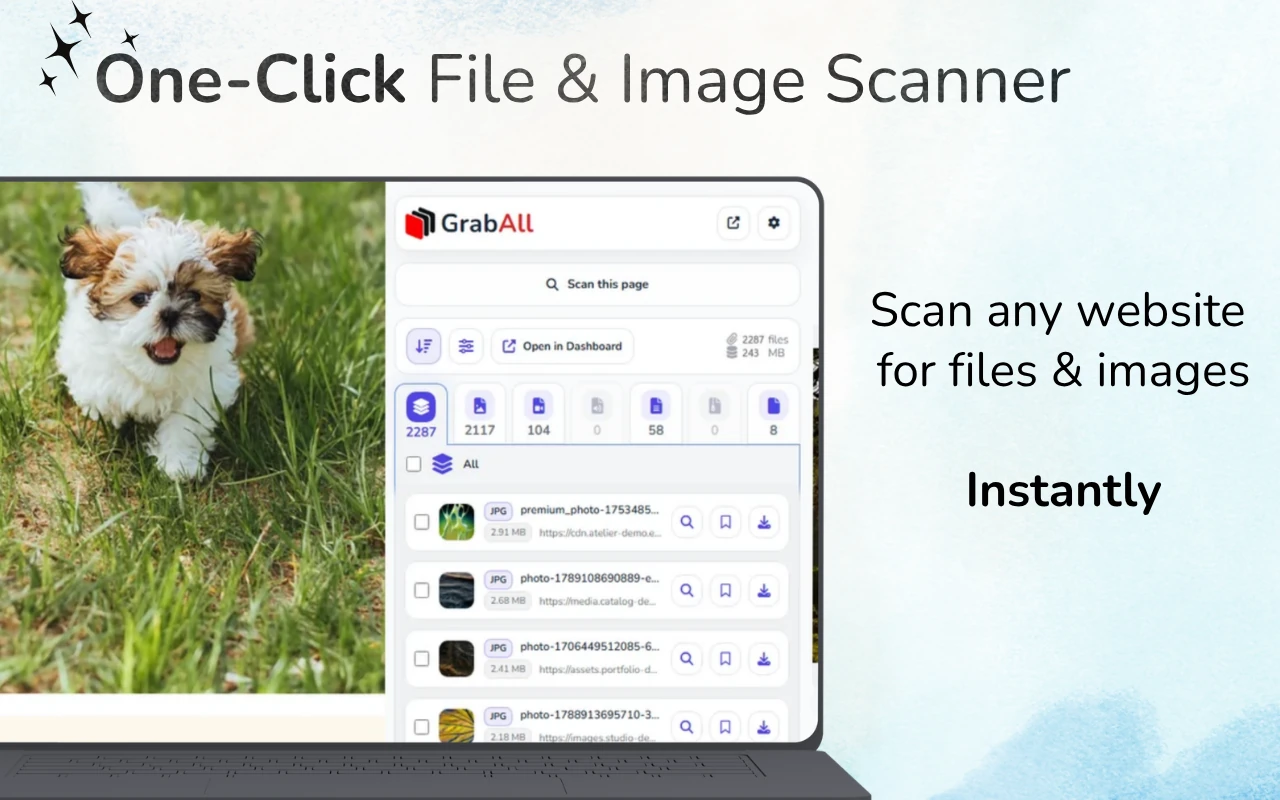
Бърз отговор: Отворете уеб страницата, заредете съответното съдържание и го сканирайте с GrabAll. Филтрирайте откритите файлове по тип или размер, проверете визуализациите и имената на файловете, след което запазете или копирайте избраните връзки. Някои ресурси се появяват само след взаимодействие със страница.
Търсете връзки към файлове в заредената страница
Бутоните за изтегляне, списъците с документи, картите с изображения и медийните елементи могат да разкрият файлове. Започнете със зареждане на секцията, съдържаща ресурсите, след което сканирайте и прегледайте резултатите. Скенерът може да изброява само ресурси, които страницата прави достъпни за браузъра.
Какво се счита за файл за изтегляне
Файл за изтегляне може да бъде свързан документ, източник на изображение, медиен елемент, архив, електронна таблица или друг публичен актив, посочен от страницата. Браузърът трябва да знае достатъчно за ресурса, за да го поиска или покаже.
Откриването на файл не означава изследване на сървъра. GrabAll работи с текущата страница и предоставените URL адреси, а не с частни директории или непосочено съдържание на сървъра.
- Връзки към документи и архиви
- Image src, srcset и lazy-load атрибути
- Видео, аудио, плакати и изходни елементи
- URL адресите на публичните файлове, присъстващи в текста на страницата или атрибутите на данни
Структуриран процес на откриване
Първо сканирайте най-подходящата страница. Групирайте резултатите по тип, след което проверете файловите разширения, MIME подсказките, размерите, размерите и изходните домейни. Използвайте визуализации, където има такива.
Ако страницата е динамична, позволете на съответната секция да се зареди преди сканиране. Избягвайте да превъртате през несвързани области, защото това може да добави препоръки и навигационни активи към набора от резултати.
- Изберете конкретна страница
- Заредете съдържанието, подходящо за задачата
- Сканиране и групиране на резултатите по тип
- Филтриране, преглед и избор на полезните файлове
URL адреси без очевидни разширения
Някои изтегляния използват маршрути като /download?id=123 вместо имена на файлове, завършващи на .pdf или .zip. Тези връзки могат да бъдат по-трудни за класифициране, преди сървърът да отговори. Етикетите на страниците, заглавките на отговорите и поведението при изтегляне на браузъра може да предоставят повече информация.
Не приемайте, че всеки дълъг URL е файл. Връзките за проследяване, навигация и API може да изглеждат подобно.
Когато сканирането е по-добро от преглеждането на източника
Прегледът на HTML изходния код може да помогне на техническите потребители, но модерните страници често добавят съдържание след първоначалното зареждане на документа. Разширението на браузъра може да проверява изобразения контекст и да представя резултатите в интерфейс, ориентиран към преглед.
За поставен HTML или офлайн източник използвайте безплатния инструмент за извличане на URL адреси за групови файлове. За страницата на живо използвайте GrabAll, за да можете да комбинирате откриване с визуализации и избор на изтегляне.
Задайте реалистични очаквания
Файлове зад удостоверяване, генерирани след защитени API извиквания, съхранени в частни системи или доставени чрез DRM, са извън обхвата на нормалния скенер на страници. Спазвайте правилата за достъп и използвайте официалните контроли за изтегляне, където са предвидени.
Най-добрите резултати идват от страници, които умишлено излагат връзки към ресурси, галерии, прикачени файлове, документи или обикновени медийни файлове.
Често задавани въпроси
Може ли GrabAll да намира файлове, които не са свързани на страницата?
Не. Той организира ресурси и връзки, достъпни за браузъра; не търси директории на частни сървъри и не разкрива неизложени файлове.
Трябва ли да сканирам началната страница или конкретна страница?
Използвайте възможно най-конкретната страница. Той произвежда по-малко несвързани активи и по-чисти резултати.
Ами ако URL адресът няма файлово разширение?
Все пак може да доведе до изтегляне, но класифицирането е по-малко надеждно, докато сървърът не отговори. Прегледайте етикета на страницата и използвайте официалния контрол, когато не сте сигурни.
Мога ли вместо това да извличам връзки от копиран HTML?
Да. GrabAll предоставя безплатен Bulk File URL Extractor за поставен HTML, изходен код и текст.
GrabAll сканира страницата и поставя изображения, документи, медии и други файлове за изтегляне в един ясен списък, така че можете да изберете точно какво да запазите.