
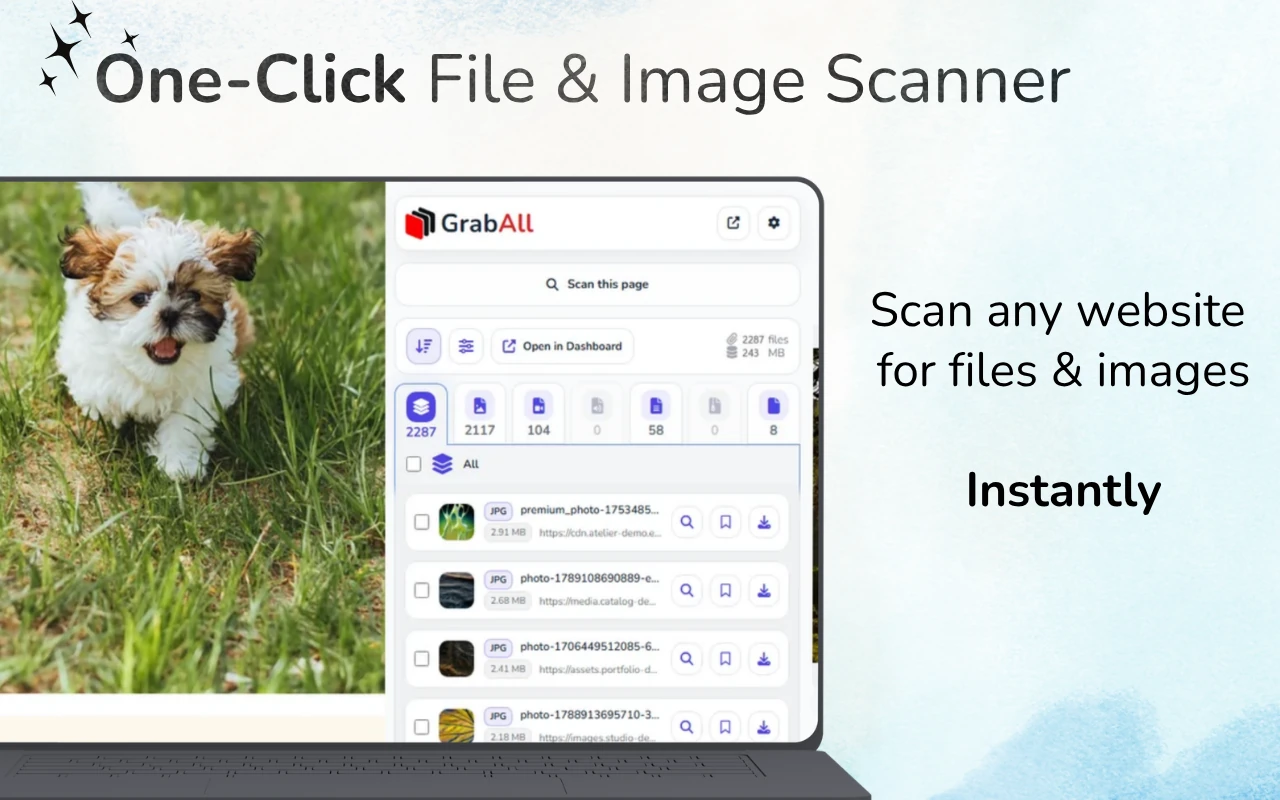
Rychlá odpověď: Pro živou webovou stránku použijte GrabAll ke skenování a zkopírujte detekované odkazy na soubory. Uložený HTML soubor nebo zkopírovaný zdrojový kód vložte do Nástroje pro hromadné získávání URL souborů. Pokud zdroj obsahuje relativní odkazy, uveďte základní URL.
Vyberte si mezi skenováním stránky a analýzou vloženého HTML
Skenováním načtené webové stránky můžete najít soubory dostupné v prohlížeči, zatímco online extraktor nebo text HTML pouze přečtete. Vyberte metodu, která odpovídá vašemu výchozímu bodu, a poté zkontrolujte výsledné adresy URL, než je použijete ke stažení.
Kde se v HTML objevují adresy URL souborů
Běžné odkazy používají href, zatímco obrázky a média běžně používají src. Responzivní obrázky mohou obsahovat několik kandidátů v srcset. Knihovny s pomalým načítáním často ukládají skutečné adresy URL do atributů data-src, data-original nebo vlastních dat.
Šablony stylů a inline CSS mohou odkazovat na pozadí prostřednictvím url(). Nezpracovaný text může také obsahovat úplné adresy URL, které nejsou připojeny k prvku HTML.
- odkazy href
- atributy src a plakátu
- kandidáti na sadu src a datovou sadu
- Hodnoty CSS url() a nezpracované absolutní adresy URL
Vyřešte správně relativní cesty
Hodnota, ze které stránka pochází pouze s významem ..pdf. Zadejte původní URL stránky jako základ, aby extraktor mohl změnit relativní cesty na úplné adresy.
Protokol-relativní odkazy obvykle začínají na HTTPS // Cesty relativní ke kořenu začínající / používají aktuální původ webu.
- Zachovejte původní adresu URL zdrojové stránky
- Použít jej jako základní adresu URL
- Normalizovat cesty relativní k protokolu a ke kořenu
- Před použitím seznamu zkontrolujte vyřešené domény
Filtrovat kandidátské adresy URL podle záměru
Ne každá adresa URL ve zdrojovém kódu je aktivum ke stažení. Stránky obsahují navigační odkazy, rozhraní API, analýzy, písma, skripty, šablony stylů a parametry sledování. Filtrujte podle relevantních přípon a kontrolujte nejednoznačné adresy URL.
Pro obrázky zahrňte moderní formáty jako WebP a AVIF. Pro dokumenty zvažte PDF, DOCX, XLSX, CSV, PPTX a archivy podle úkolu.
zdroj HTML versus vykreslená stránka
Zkopírovaný zdroj představuje pouze to, co jste dodali. Může chybět zdroje vložené po spuštění JavaScriptu, obsah načtený po rolování nebo adresy URL vytvořené během interakce.
Používejte offline extraktor pro zdrojové úryvky, exportovaný HTML, e-mailové šablony a kontrolu kódu. Použijte rozšíření GrabAll pro živě vykreslenou stránku a pracovní postupy v kontextu prohlížeče.
Před stažením ověřit
Zdeduplikujte seznam, prohlédněte si domény a otestujte malý vzorek. Odpovídající rozšíření v adrese URL nezaručuje, že je odpověď platná nebo že jste oprávněni ji použít.
Vyhněte se automatickému vyžadování velkých nezkontrolovaných seznamů. Ověření zabraňuje nefunkčním odkazům, nechtěným koncovým bodům sledování a zbytečnému zatížení.
Často kladené otázky
Může extraktor vyřešit ../ relativní odkazy?
Ano, pokud jako základní adresu uvedete původní URL stránky.
Zahrnuje extrakce HTML obrázky srcset?
Nástroj GrabAll kontroluje běžné atributy zdroje a responzivního obrázku, včetně kandidátů srcset.
Proč v zkopírovaném HTML chybí některé soubory živých stránek?
JavaScript je může přidat po počátečním načtení HTML. Použijte živé rozšíření prohlížeče pro vykreslený a dynamicky načítaný obsah stránky.
Jsou všechny extrahované adresy URL bezpečné ke stažení?
Ne. Než použijete seznam výsledků, zkontrolujte domény, typy souborů, oprávnění a malý vzorek.
GrabAll prohledá stránku a přenese obrázky, dokumenty, média a další soubory ke stažení do jednoho přehledného seznamu, takže si můžete přesně vybrat, co uložit.