
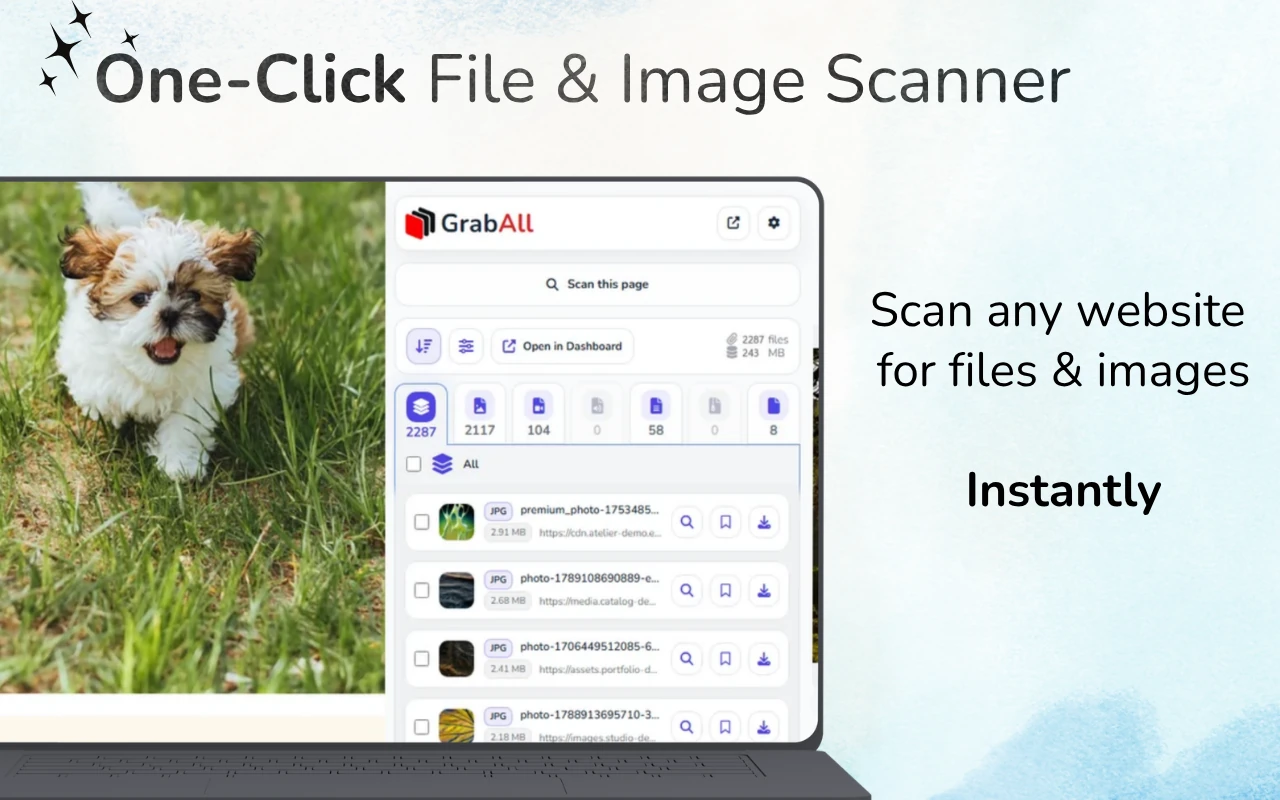
Kiire vastus: Elaval veebilehel skaneeri GrabAlliga ja kopeeri tuvastatud faililinkid. Salvestatud HTML-i või kopeeritud lähtekoodi puhul kleebi see Bulk File URL Extractorisse. Lisa baas-URL, kui allikas sisaldab suhtelisi linke.
Vali lehe skaneerimise ja kleebitud HTML-i parsimise vahel
Laetud veebilehe skaneerimine võib leida brauseris saadaval olevaid faile, samas kui veebipõhine ekstraktor loeb ainult HTML-i või teksti, mille sa kleebid. Vali meetod, mis sobib sinu lähtespunktiga, ja vaata tulemuseks saadud URL-e enne nende kasutamist allalaadimiseks.
Kus failide URL-id HTML-is kuvatakse
Tavalised lingid kasutavad href, samas kui pildid ja meedia kasutavad tavaliselt src. Reageerivad pildid võivad loetleda mitu kandidaati srcset'is. Laisklaadimise raamatukogud salvestavad sageli tegelikud URL-id data-src, data-original või kohandatud andmeatribuutidesse.
Töötluslehed ja sisemine CSS võivad taustadele viidata läbi url(). Ka tekstiline sisu võib sisaldada täielikke URL-e, mis ei ole HTML-elementidega seotud.
- href lingid
- src ja poster atribuudid
- srcset ja data-srcset kandidaadid
- CSS URL() väärtused ja toor-absoluutsed URL-id
Lahendage suhtelised teed õigesti
Väärtus nagu ../files/report.pdf on tähenduslik ainult suhtega lehele, kust HTML pärineb. Esitage originaallehe URL baasina, et ekstraktor saaks muuta suhtelised teed täielikeks aadressideks.
Protokolli suhtelised lingid, mis algavad //, pärivad tavaliselt turvalisel lehel HTTPS. Juure suhtelised teed, mis algavad /, kasutavad praeguse veebisaidi päritolu.
- Hoiake algallika lehe URL-i
- Kasutage seda baas-URL-ina
- Normeerige protokoll-relatiivsed ja juur-relatiivsed teed
- Vaata enne nimekirja kasutamist lahendatud domeene
Filtreeri kandidaatide URL-e kavatsuse järgi
Kõik lähtekoodis olevad URL-id ei ole allalaaditavad varad. Lehtedel on navigatsioonilingid, API-d, analüütika, fondid, skriptid, stiililehed ja jälgimisparameetrid. Filtreerige asjakohaste laiendite järgi ja kontrollige ebaselgeid URL-e.
Piltide puhul lisa kaasaegseid formaate nagu WebP ja AVIF. Dokumentide puhul mõtle PDF, DOCX, XLSX, CSV, PPTX ja arhiivide peale vastavalt ülesandele.
HTML allikas versus renderdatud leht
kopeeritud lähtekood esindab ainult seda, mida sa esitasid. See võib jätta vahele ressursid, mis lisatakse pärast JavaScripti käivitamist, sisu laadimist pärast kerimist või URL-e, mis on loodud suhtluse käigus.
Kasutage allalaadimisel välja lõikude, eksporditud HTML-i, e-posti mallide ja koodikontrolli jaoks võrguühenduseta lõikurit. Kasutage GrabAll laiendust reaalajas renderdatud lehe ja brauseri kontekstiga töövoogude jaoks.
Kontrolli enne allalaadimist
Deduplicateeri nimekiri, kontrolli domeene ja testi väikest valimit. URL-i sobiva laienduse olemasolu ei taga, et vastus on kehtiv ega et sul on luba seda kasutada.
Vältige automaatset suurte kontrollimata nimekirjade pärimist. Kinnitus takistab katkiseid linke, soovimatuid jälgimisotsapunkte ja tarbetut koormust.
Korduma kippuvad küsimused
Kas ekstraktor suudab lahendada .. / suhtelisi ühendusi?
Jah, kui annad algse lehe URL-i baas-aadressina.
Kas HTML-ekstraktsioon sisaldab srcset-pilte?
GrabAll tööriist kontrollib tavalisi allika ja vastuvõtlike piltide atribuute, sealhulgas srcset kandidaate.
Miks mõned live-lehe failid kopeeritud HTML-ist puuduvad?
JavaScript võib need lisada pärast esialgse HTML-i laadimist. Kasutage renderdatud ja dünaamiliselt laetud lehe sisu jaoks otse brauseri laiendust.
Kas kõik väljavõetud URL-id on ohutud allalaadimiseks?
Ei. Vaadake üle domeenid, failitüübid, õigused ja väike proov enne tulemilisti kasutamist.
GrabAll skannib lehte ja koondab pildid, dokumendid, meedia ja muud allalaaditavad failid ühte selgesse nimekirja, nii et saate täpselt valida, mida salvestada.