
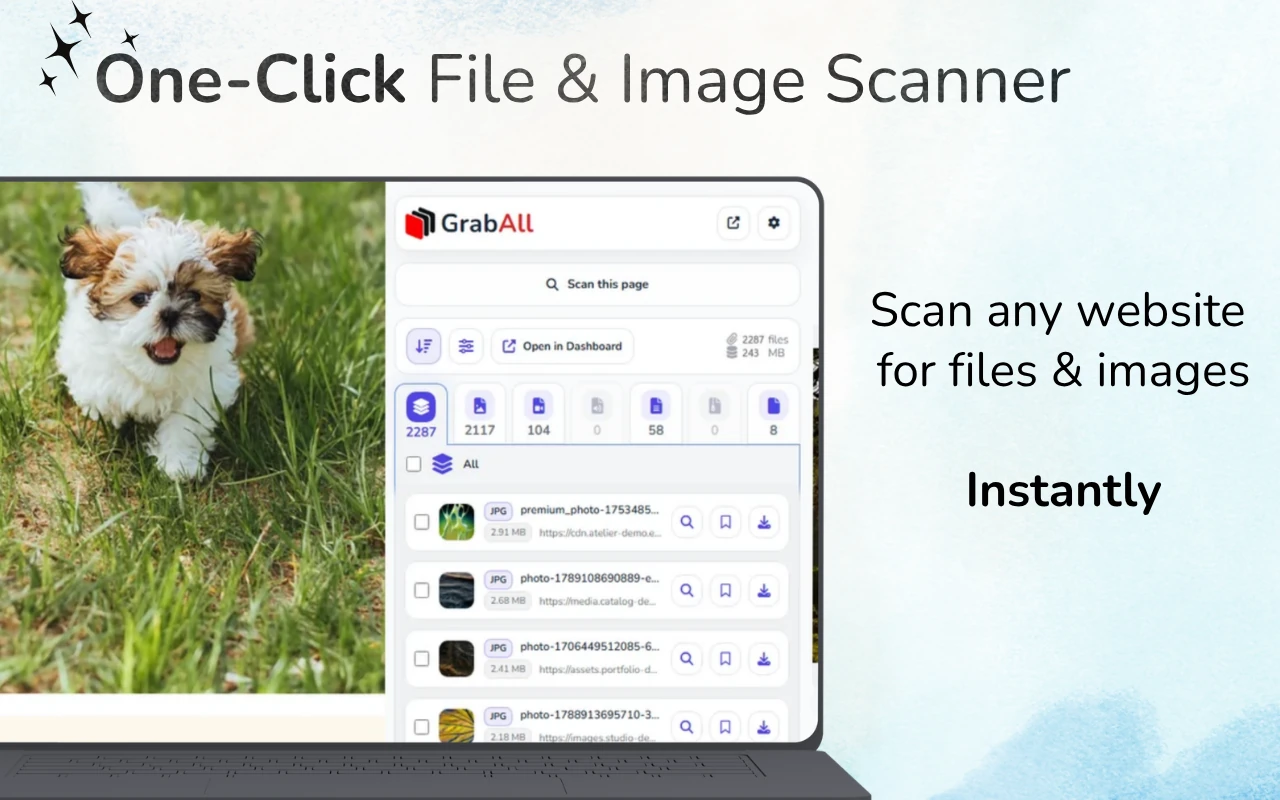
پاسخ سریع: برای یک صفحه وب زنده، با GrabAll اسکن کرده و لینکهای فایل شناساییشده را کپی کنید. برای HTML ذخیرهشده یا کد منبع کپیشده، آن را در Bulk File URL Extractor بچسبانید. هنگامیکه منبع شامل لینکهای نسبی است، یک URL پایه ارائه دهید.
بین اسکن یک صفحه و تجزیه HTML چسبیده انتخاب کنید
اسکن یک صفحه وب بارگذاری شده میتواند فایلهای موجود در مرورگر را پیدا کند، در حالی که استخراجکننده آنلاین تنها HTML یا متنی را میخواند که شما قرار میدهید. روشی را که با نقطه شروع شما مطابقت دارد انتخاب کنید و سپس URLهای حاصل را قبل از استفاده برای دانلود مرور کنید.
URLهای فایل در HTML کجا ظاهر میشوند
لینکهای معمولی از href استفاده میکنند، در حالی که تصاویر و رسانهها معمولاً از src استفاده میکنند. تصاویر واکنشگرا میتوانند چندین گزینه را در srcset فهرست کنند. کتابخانههای Lazy-loading اغلب URLهای واقعی را در data-src، data-original یا ویژگیهای داده سفارشی ذخیره میکنند.
برگههای سبک و CSS درونخطی ممکن است به پسزمینهها از طریق url() ارجاع دهند. متن خام نیز میتواند شامل URLهای کامل باشد که به هیچ عنصر HTML متصل نیستند.
- لینکهای href
- ویژگیهای src و poster
- نامزدهای srcset و data-srcset
- مقدار url() در CSS و URLهای مطلق خام
مسیرهای نسبی را بهدرستی حل کنید
مقداری مانند ../files/report.pdf تنها نسبت به صفحهای که HTML از آن آمده معنی دارد. URL صفحه اصلی را بهعنوان پایه ارائه دهید تا استخراجکننده بتواند مسیرهای نسبی را به آدرسهای کامل تبدیل کند.
لینکهای نسبی پروتکل که با // شروع میشوند، معمولاً HTTPS را در یک صفحه امن به ارث میبرند. مسیرهای نسبی ریشه که با / شروع میشوند، منشاء وبسایت فعلی را استفاده میکنند.
- URL صفحه منبع اصلی را نگه دارید
- از آن به عنوان URL پایه استفاده کنید
- مسیرهای نسبی به پروتکل و مسیرهای نسبی به ریشه را نرمالسازی کنید
- قبل از استفاده از فهرست، دامنههای حلشده را بررسی کنید
فیلتر کردن URLهای کاندید بر اساس هدف
هر URL در کد منبع یک دارایی قابل دانلود نیست. صفحات شامل لینکهای ناوبری، APIها، آنالیزها، فونتها، اسکریپتها، استایلها و پارامترهای ردیابی هستند. بر اساس پسوندهای مرتبط فیلتر کنید و URLهای مبهم را بررسی کنید.
برای تصاویر، فرمتهای مدرن مانند WebP و AVIF را شامل کنید. برای اسناد، فرمتهای PDF، DOCX، XLSX، CSV، PPTX و آرشیوها را بسته به وظیفه در نظر بگیرید.
منبع HTML در مقابل صفحه رندر شده
منبع کپی شده تنها آن چیزی را نشان میدهد که شما ارائه کردهاید. ممکن است منابعی که پس از اجرای جاوااسکریپت اضافه شدهاند، محتوای بارگذاریشده پس از اسکرول یا URLهایی که در طول تعامل ایجاد شدهاند، در آن نباشد.
برای قطعات منبع، HTML صادر شده، قالبهای ایمیل و بررسی کد از استخراجگر آفلاین استفاده کنید. برای صفحه رندر شده زنده و جریانهای کاری مبتنی بر مرورگر از افزونه GrabAll استفاده کنید.
قبل از دانلود اعتبارسنجی کنید
لیست را بدون تکرار کنید، دامنهها را بررسی کنید و نمونه کوچکی را آزمایش کنید. تطبیق افزونه در یک URL تضمینکننده معتبر بودن پاسخ یا اجازه استفاده شما نیست.
از درخواست خودکار فهرستهای بزرگ و بررسینشده خودداری کنید. اعتبارسنجی از شکسته شدن لینکها، نقاط ردیابی ناخواسته و بار اضافی جلوگیری میکند.
سؤالات متداول
آیا استخراجکننده میتواند لینکهای نسبی ../ را حل کند؟
بله، زمانی که شما URL صفحه اصلی را به عنوان آدرس پایه ارائه میدهید.
آیا استخراج HTML شامل تصاویر srcset میشود؟
ابزار GrabAll ویژگیهای منبع رایج و تصاویر پاسخگو را بررسی میکند، از جمله گزینههای srcset.
چرا برخی فایلهای صفحه زنده در HTML کپی شده، وجود ندارند؟
جاوااسکریپت ممکن است آنها را پس از بارگذاری اولیه HTML اضافه کند. از افزونه مرورگر زنده برای محتوای صفحه رندر شده و بهصورت پویا بارگذاری شده استفاده کنید.
آیا همه URLهای استخراج شده برای دانلود ایمن هستند؟
خیر. قبل از استفاده از فهرست نتایج، دامنهها، نوع فایلها، مجوزها و یک نمونه کوچک را بررسی کنید.
GrabAll صفحه را اسکن میکند و تصاویر، اسناد، رسانهها و سایر فایلهای قابل دانلود را در یک فهرست واضح جمعآوری میکند تا بتوانید دقیقاً انتخاب کنید چه چیزی را ذخیره کنید.