

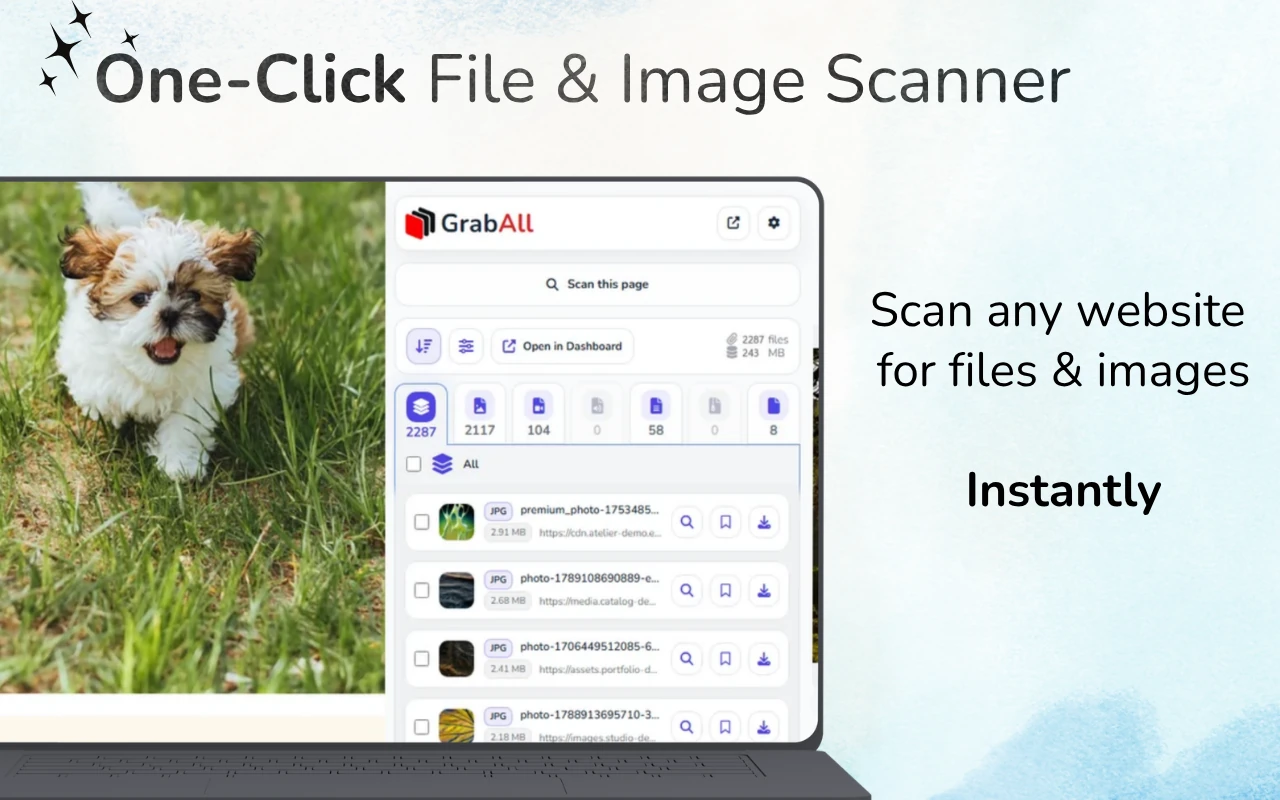
Nopea vastaus: Elävää verkkosivua varten skannaa GrabAllilla ja kopioi havaitut tiedostolinkit. Tallennettua HTML:ää tai kopioitua lähdekoodia varten liitä se Bulk File URL Extractoriin. Anna perus-URL, kun lähde sisältää suhteellisia linkkejä.
Valitse skannauksen välillä sivulla ja liitetyssä HTML:ssä
Ladatun verkkosivun skannaus voi löytää selaimessa saatavilla olevia tiedostoja, kun taas online-ekstraktori lukee vain liittämäsi HTML- tai tekstisisällön. Valitse menetelmä, joka vastaa lähtöpistettäsi, ja tarkista sitten tuloksena olevat URL-osoitteet ennen niiden käyttöä latauksiin.
Missä tiedosto-URL-osoitteet näkyvät HTML:ssä
Tavalliset linkit käyttävät href-attribuuttia, kun kuvat ja media käyttävät yleisesti src-attribuuttia. Väresponsive-kuvat voivat listata useita ehdokkaita srcsetissä. Lazy-loading-kirjastot tallentavat usein todelliset URL-osoitteet data-src-, data-original- tai mukautettuihin data-attribuutteihin.
Tyylitaulukot ja sisäinen CSS voivat viitata taustoihin url()-funktion kautta. Raakateksti voi myös sisältää täydellisiä URL-osoitteita, jotka eivät ole liitettyinä HTML-elementtiin.
- href-linkit
- src- ja poster-attribuutit
- srcset- ja data-srcset-ehdokkaat
- CSS url()-arvot ja raakat absoluuttiset URL-osoitteet
Ratkaise suhteelliset polut oikein
Arvo kuten .. /files/report.pdf on merkityksellinen vain suhteessa siihen sivuun, josta HTML on peräisin. Anna alkuperäinen sivun URL pohjaksi, jotta poimija voi muuttaa suhteelliset polut täydellisiksi osoitteiksi.
Protokollariippumattomat linkit, jotka alkavat //, perivät normaalisti HTTPS:n suojatulla sivulla. Juuriin suhteelliset polut, jotka alkavat /, käyttävät nykyisen verkkosivuston alkuperää.
- Pidä alkuperäinen lähdesivun URL
- Käytä sitä perus-URL-osoitteena
- Normalisoi protokollaan suhteelliset ja juureen suhteelliset polut
- Tarkista ratkaistut verkkotunnukset ennen listan käyttöä
Suodata ehdokas-URL-osoitteet intentin mukaan
Ei jokainen lähdekoodin URL-osoite ole ladattava aineisto. Sivut sisältävät navigointilinkkejä, API:ita, analytiikkaa, fontteja, skriptejä, tyylitiedostoja ja seuranta-parametreja. Suodata merkityksellisten laajennusten mukaan ja tarkista epäselvät URL-osoitteet.
Kuvien osalta sisällytä nykyaikaiset muodot, kuten WebP ja AVIF. Dokumenttien osalta harkitse PDF-, DOCX-, XLSX-, CSV-, PPTX- ja arkistomuotoja tehtävän mukaan.
HTML-lähde versus renderöity sivu
Kopioitu lähde edustaa vain sitä, mitä annoit. Se saattaa jäädä paitsi resursseista, jotka lisätään JavaScriptin suorittamisen jälkeen, sisällöstä, joka ladataan vierittämisen jälkeen, tai URL-osoitteista, jotka luodaan vuorovaikutuksen aikana.
Käytä offline-uuttajaa lähdekoodin katkelmiin, vietyyn HTML:ään, sähköpostimalleihin ja koodin tarkasteluun. Käytä GrabAll-laajennusta live-renderöidylle sivulle ja selaimen kontekstityönkulkuihin.
Varmista ennen latausta
Poista listan kaksoiskappaleet, tarkasta verkkotunnukset ja testaa pieni näyte. URL-osoitteen vastaava tiedostopääte ei takaa, että vastaus on kelvollinen tai että sinulla on oikeus käyttää sitä.
Vältä automaattisesti pyytämästä suuria tarkistamattomia listoja. Varmistus estää rikkinäisiä linkkejä, ei-toivottuja seurantalinkkejä ja tarpeetonta kuormitusta.
Usein kysytyt kysymykset
Voiko tietojenpoimija ratkaista ../ suhteelliset linkit?
Kyllä, kun annat alkuperäisen sivun URL-osoitteen perusosoitteena.
Sisältääkö HTML-poiminta srcset-kuvia?
GrabAll-työkalu tarkistaa yleisiä lähde- ja responsiivisen kuvan attribuutteja, mukaan lukien srcset-ehdokkaat.
Miksi tietyt live-sivun tiedostot puuttuvat kopioidusta HTML:stä?
JavaScript voi lisätä niitä HTML:n alkuperäisen latauksen jälkeen. Käytä live-selainlaajennusta renderöidyn ja dynaamisesti ladatun sivusisällön käsittelemiseen.
Ovatko kaikki poimitut URL-osoitteet turvallisia ladata?
Ei. Tarkista verkkotunnukset, tiedostotyypit, käyttöoikeudet ja pieni otos ennen tuloslistan käyttöä.
GrabAll skannaa sivun ja tuo kuvat, dokumentit, median ja muut ladattavat tiedostot yhteen selkeään listaan, jotta voit valita tarkalleen mitä tallennat.