

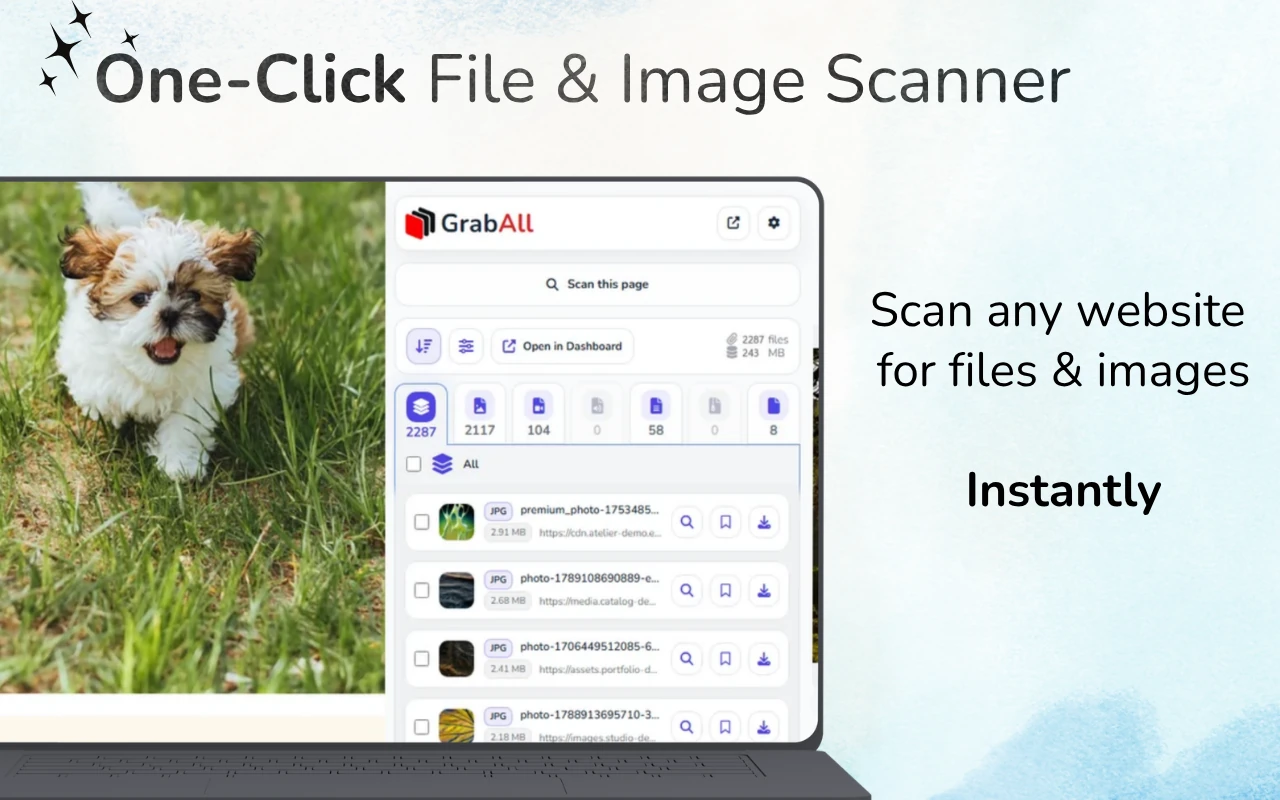
Mabilis na sagot: Para sa isang live na webpage, i-scan gamit ang GrabAll at kopyahin ang nadetekta na mga file link. Para sa nai-save na HTML o kinopyang source code, i-paste ito sa Bulk File URL Extractor. Magbigay ng base URL kapag ang source ay may relative links.
Pumili sa pagitan ng pag-scan ng pahina at pag-parse ng na-paste na HTML
Ang pag-scan ng isang loaded na webpage ay maaaring makahanap ng mga file na available sa browser, habang ang online extractor ay nagbabasa lamang ng HTML o text na iyong i-pe-paste. Piliin ang pamamaraan na tumutugma sa iyong panimulang punto, pagkatapos suriin ang mga resulting URLs bago gamitin ang mga ito para sa pag-download.
Saan lumilitaw ang mga URL ng file sa HTML
Ang karaniwang mga link ay gumagamit ng href, habang ang mga imahe at media ay karaniwang gumagamit ng src. Ang mga responsive na imahe ay maaaring maglista ng ilang kandidato sa srcset. Karaniwan ang lazy-loading libraries sa pag-iimbak ng tunay na URL sa data-src, data-original, o mga custom na data attributes.
Maaaring mag-refer ang mga stylesheet at inline CSS sa mga background sa pamamagitan ng url(). Maaari ring maglaman ang raw na teksto ng kumpletong mga URL na hindi naka-attach sa isang HTML element.
- href na mga link
- src at poster attributes
- srcset at data-srcset candidates
- Mga value ng CSS url() at raw na absolute na URL
Ayusin nang tama ang mga relative path
Ang isang halaga tulad ng ../files/report.pdf ay may kahulugan lamang kaugnay sa pahina kung saan nagmula ang HTML. Ibigay ang orihinal na URL ng pahina bilang base upang ang extractor ay maibahin ang mga relative path sa kumpletong address.
Ang mga protocol-relative na link na nagsisimula sa // ay karaniwang nagmamana ng HTTPS sa isang secure na pahina. Ang mga root-relative path na nagsisimula sa / ay gumagamit ng kasalukuyang pinagmulan ng website.
- Panatilihin ang orihinal na URL ng pahina ng pinagmulan
- Gamitin ito bilang base URL
- I-normalize ang protocol-relative at root-relative paths
- Suriin ang mga nalutas na domain bago gamitin ang listahan
I-filter ang mga kandidato na URL ayon sa layunin
Hindi lahat ng URL sa source code ay isang downloadable na asset. Naglalaman ang mga pahina ng mga navigation link, API, analytics, font, script, stylesheet, at tracking parameters. I-filter ayon sa kaugnay na extension at suriin ang mga ambiguous na URL.
Para sa mga larawan, isama ang mga modernong format tulad ng WebP at AVIF. Para sa mga dokumento, isaalang-alang ang PDF, DOCX, XLSX, CSV, PPTX, at mga archive ayon sa gawain.
HTML na pinagmulan kumpara sa na-render na pahina
Ang nakopyang source ay kumakatawan lamang sa iyong ibinigay. Maaaring hindi nito masaklaw ang mga resource na naipasok matapos patakbuhin ang JavaScript, nilalaman na na-load pagkatapos mag-scroll, o mga URL na nalikha sa panahon ng interaksyon.
Gamitin ang offline extractor para sa mga snippet ng pinagmulan, in-export na HTML, template ng email, at pagsusuri ng code. Gamitin ang GrabAll extension para sa live na na-render na pahina at mga workflow sa browser-context.
Suriin bago mag-download
Tanggalin ang duplicate sa listahan, inspeksyonin ang mga domain, at subukan ang maliit na sample. Ang pagkakatugma ng extension sa isang URL ay hindi garantiyang valid ang tugon o pinapayagan kang gamitin ito.
Iwasang awtomatikong humiling ng malalaking hindi naisusuring listahan. Pinipigilan ng beripikasyon ang mga sirang link, hindi gustong tracking endpoints, at hindi kailangang load.
Madalas itanong na mga tanong
Maaari bang i-resolve ng extractor ang .. / relative links?
Oo, kapag ibinigay mo ang orihinal na URL ng pahina bilang base address.
Kasama ba sa HTML extraction ang mga srcset na larawan?
Sinusuri ng GrabAll tool ang mga karaniwang source at responsive-image attributes, kabilang na ang mga srcset candidates.
Bakit ang ilang live-page na file ay nawawala mula sa kinopyang HTML?
JavaScript pagkatapos mag-load ang unang HTML. Gamitin ang live browser extension para sa rendered at dynamically loaded na nilalaman ng pahina.
Ligtas bang i-download ang lahat ng nakuha na URL?
Hindi. Suriin ang mga domain, uri ng file, permissions, at isang maliit na sample bago gamitin ang listahan ng resulta.
Ina-scan ng GrabAll ang pahina at inilalagay ang mga imahe, dokumento, media, at iba pang maida-download na file sa isang malinaw na listahan, upang maaari mong piliin eksakto kung ano ang nais i-save.