
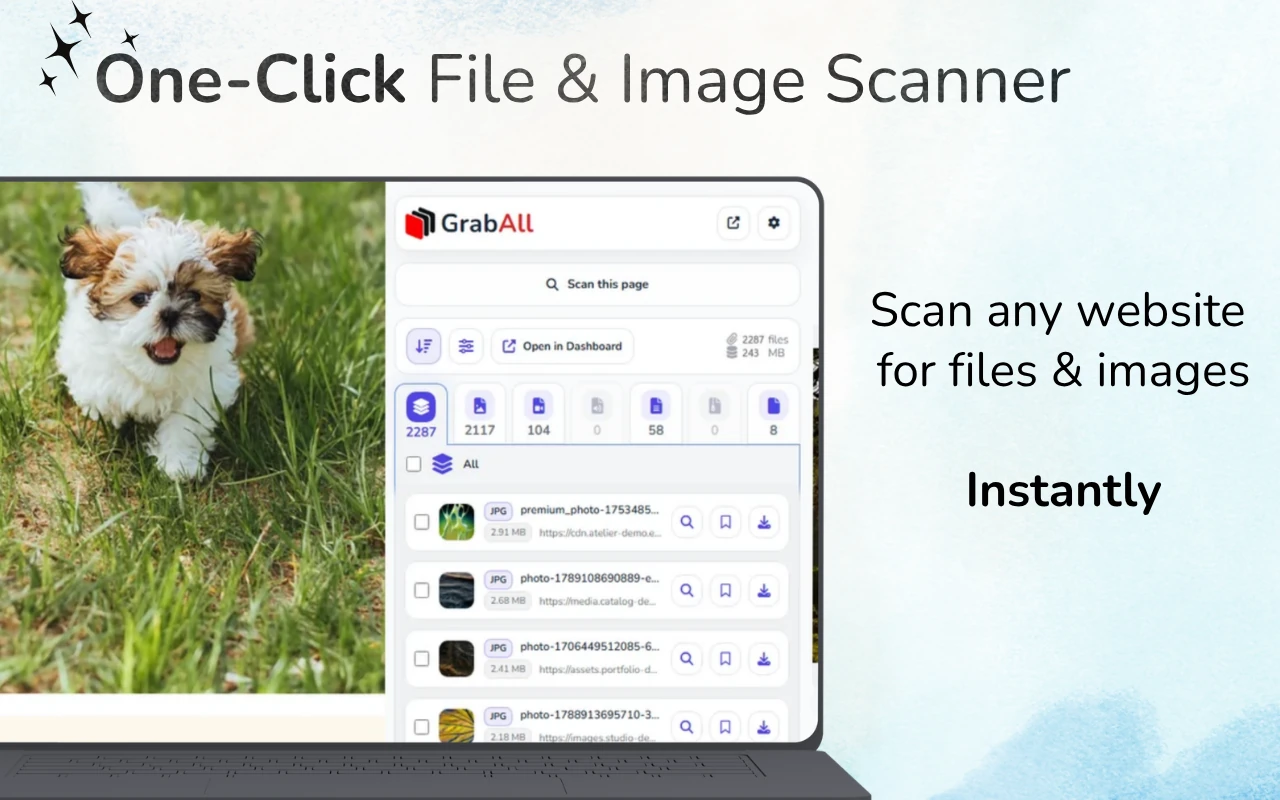
ઝડપી જવાબ: લાઇવ વેબપેજ માટે, GrabAll સાથે સ્કેન કરો અને શોધાયેલા ફાઇલ લિંક્સ કૉપિ કરો. સંગ્રહિત HTML અથવા કૉપિ કરેલો સોર્સ કોડ માટે, તેને Bulk File URL Extractor માં પેસ્ટ કરો. જ્યારે સોર્સમાં સાપેક્ષ લિંક્સ હોય ત્યારે બેઝ URL પૂરો પાડો.
પાનાંને સ્કેન કરવા અને ચોંટાડેલા HTML નું પદચ્છેદન કરવા વચ્ચે પસંદ કરો
લોડ થયેલ વેબપૃષ્ઠને સ્કેન કરવાથી બ્રાઉઝરમાં ઉપલબ્ધ ફાઇલો મળી શકે છે, જ્યારે ઑનલાઇન એક્સ્ટ્રેક્ટર માત્ર HTML અથવા તમારે પેસ્ટ કરેલી ટેક્સ્ટ વાંચે છે. શરૂઆતના બિંદુને અનુકૂલિત પદ્ધતિ પસંદ કરો, પછી ડાઉનલોડ માટે URL ઉપયોગ કરતા પહેલા તેનું સમીક્ષા કરો.
HTMLમાં ફાઈલ URL ક્યાં દેખાય છે
સામાન્ય લિંક્સ હ્રફનો ઉપયોગ કરે છે, જ્યારે છબીઓ અને મીડિયા સામાન્ય રીતે એસઆરસીનો ઉપયોગ કરે છે. પ્રતિભાવશીલ છબીઓ srcset માં ઘણા ઉમેદવારોની સૂચિ બનાવી શકે છે. આળસુ-લોડિંગ લાઇબ્રેરીઓ ઘણીવાર ડેટા-એસઆરસી, ડેટા-મૂળ અથવા કસ્ટમ ડેટા લક્ષણોમાં વાસ્તવિક યુઆરએલ સ્ટોર કરે છે.
સ્ટાઇલશીટ્સ અને ઇનલાઇન CSS url() દ્વારા પૃષ્ઠભૂમિના સંદર્ભ આપી શકે છે. કાચા ટેક્સ્ટમાં પણ સંપૂર્ણ URL હોઈ શકે છે જે HTML તત્વ સાથે જોડાયેલા નથી.
- href લિંક્સ
- src અને poster ગુણ
- srcset અને data-srcset ઉમેદવારો
- CSS url() મૂલ્યો અને કાચા પૂર્વનિર્ધારિત URLs
સાપેક્ષ પાથોને યોગ્ય રીતે ઉકેલવું
../files/report.pdf જેવા મૂલ્ય માત્ર તે પેજ માટે અર્થપૂર્ણ છે જ્યાંથી HTML આવ્યું છે. પૂરક પેજ URL બેસ તરીકે આપો જેથી એક્સટ્રેક્ટર સબંધિત માર્ગોને સંપૂર્ણ સરનામાંમાં ફેરવી શકે.
// થી શરૂ થતા પ્રોટોકોલ-સાપેક્ષ લિંક્સ સામાન્ય રીતે સુરક્ષિત પેજ પર HTTPS વારસાધાર કરે છે. / થી શરૂ થતા રૂટ-સાપેક્ષ પાથ હાલના વેબસાઇટ મૂળનો ઉપયોગ કરે છે.
- મૂળ સ્ત્રોત પૃષ્ઠ URL રાખો
- તેને基 URL તરીકે ઉપયોગ કરો
- પ્રોટોકોલ-સંબંધિત અને રુટ-સંબંધિત પાથને સામાન્ય બનાવો
- યાદી ઉપયોગ કરતાં પહેલા નિર્ધારિત ડોમેઇન્સની સમીક્ષા કરો
ઉદ્દેશ્ય દ્વારા ઉમેદવાર URL ફિલ્ટર કરો
સ્રોત કોડમાં દરેક URL ડાઉનલોડ કરી શકાય તેવી સંપત્તિ નથી. પૃષ્ઠોમાં નેવિગેશન લિંક્સ, APIs, એનાલિટિક્સ, ફોન્ટ, સ્ક્રિપ્ટ્સ, સ્ટાઇલશીટ્સ અને ટ્રેકિંગ પરિમાણો શામેલ છે. સંબંધિત એક્સ્ટેંશન્સ દ્વારા ફિલ્ટર કરો અને અસ્પષ્ટ URLનું નિરીક્ષણ કરો.
છબીઓ માટે, નવા ફોર્મેટ જેમ કે WebP અને AVIF શામેલ કરો. દસ્તાવેજો માટે, કામ મુજબ PDF, DOCX, XLSX, CSV, PPTX, અને આર્કાઇવ પર વિચાર કરો.
HTML સોર્સ અને રેન્ડર્ડ પેજ વચ્ચેનો તફાવત
નકલ કરેલા સ્ત્રોતમાંથી ફક્ત તમે આપેલા મુદ્દાઓ દર્શાવવામાં આવે છે. તેમાં JavaScript ચલાવ્યા પછી દાખલ કરવામાં આવેલા સંસાધનો, સ્ક્રોલ કર્યા પછી લોડ થયેલો સામગ્રી, અથવા ઇન્ટરએકશન દરમિયાન બનાવેલ URL ગહનતા હોઈ શકે છે.
સ્રોત સ્નિપેટ્સ, નિકાસ કરેલી HTML, ઇમેલ ટેમ્પલેટ્સ અને કોડ સમીક્ષા માટે ઑફલાઇન એકસ્ટ્રેક્ટરનો ઉપયોગ કરો. લાઇવ રેન્ડર પેજ અને બ્રાઉઝર-સંદર્ભ વર્કફ્લોઝ માટે GrabAll એક્સટેંશનનો ઉપયોગ કરો.
ડાઉનલોડ કરતા પહેલા માન્ય કરો
યાદીની નકલ દૂર કરો, ડોમેઇનની તપાસ કરો અને નાની નમૂના તપાસો. URL માં મળતું વિસ્તરણ પ્રતિસાદ માન્ય છે અથવા તમે તેનો ઉપયોગ કરવા માટે અધિકૃત છો તે ગેરંટી નથી.
મોટી અજમાઈ ન જોઈ ન થયેલી યાદી આપમેળે વિનંતી કરવી ટાળો. પ્રમાણિકરણ તૂટી ગયેલા લિંક્સ, અનચાહી ટ્રેકિંગ એન્ડપોઈન્ટ્સ અને અનાવશ્યક લોડને રોકે છે.
વારંવાર પૂછાતા પ્રશ્નો
એક્સ્ટ્રેક્ટર ઉકેલી શકે છે .. / સંબંધિત લિંક્સ?
હા, જ્યારે તમે મૂળ પેજ URL ને બેઝ એડ્રેસ તરીકે પ્રદાન કરો.
શું HTML એક્સ્ટ્રેક્શન srcset છબીઓને સમાવિષ્ટ કરે છે?
GrabAll સાધન સામાન્ય સ્ત્રોત અને પ્રતિસાદાત્મક-છબી ગુણધર્મો તપાસે છે, જેમાં srcset ઉમેદવારો શામેલ છે.
કોપી કરેલી HTML માં કેટલાક લાઇવ-પેજ ફાઇલો કેમ ગુમ છે?
જાવાસ્ક્રિપ્ટ તે પ્રારંભિક HTML લોડ થયે પછી ઉમેરવામાં આવી શકે છે. રેન્ડર અને ડાયનામિકલી લોડ થયેલ પૃષ્ઠ સામગ્રી માટે લાઇવ બ્રાઉઝર એક્સ્ટેંશનનો ઉપયોગ કરો.
અખાતર તમારાથી કાઢવામાં આવેલા બધા URLs ડાઉનલોડ કરવા સલામત છે?
નંબર. પરિણામ સૂચિનો ઉપયોગ કરતા પહેલા ડોમેન્સ, ફાઇલ પ્રકારો, પરવાનગીઓ અને નાના નમૂનાની સમીક્ષા કરો.
GrabAll પૃષ્ઠ સ્કેન કરે છે અને છબીઓ, દસ્તાવેજો, મીડિયા અને અન્ય ડાઉનલોડ કરવા જેવી ફાઈલોને એક ચોક્કસ સૂચિમાં લાવે છે, જેથી તમે ખબરપ્રમાણે એ સાચવી શકો.