
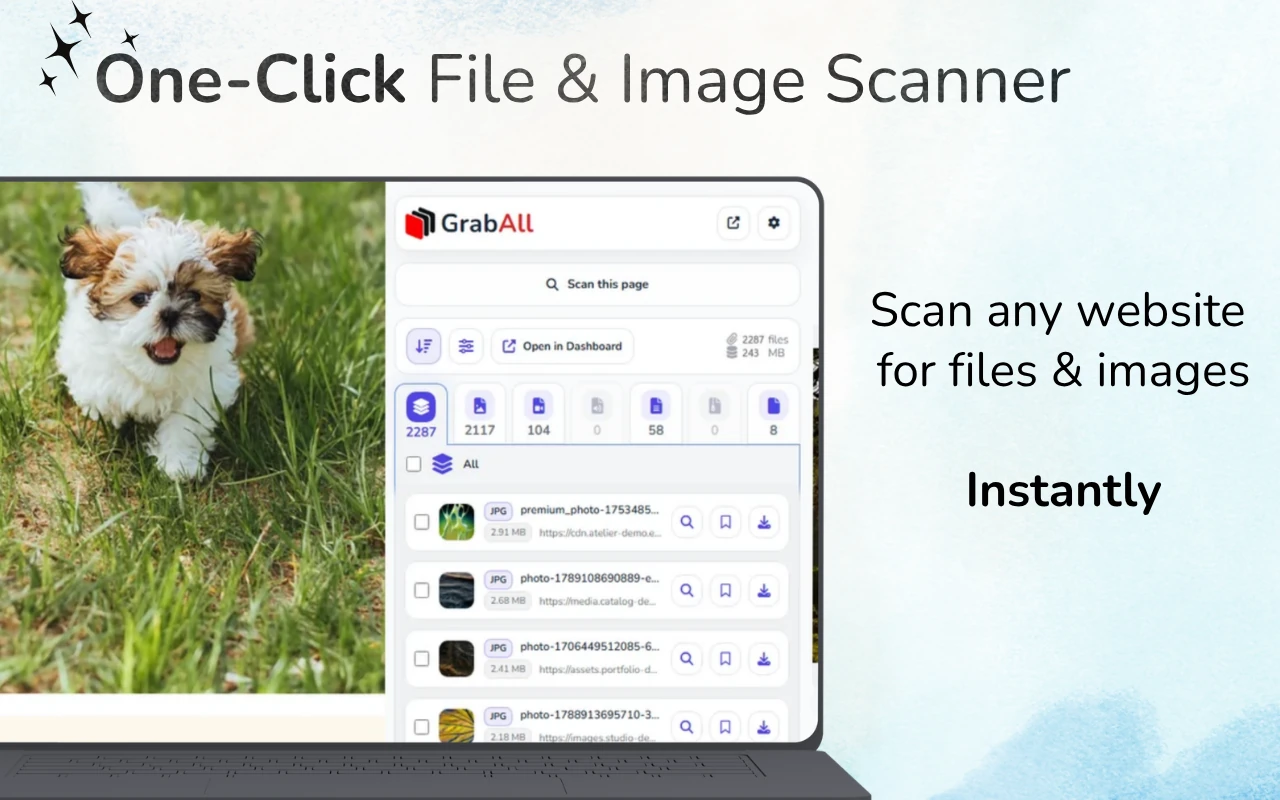
Risposta rapida: Per una pagina web live, scansiona con GrabAll e copia i link dei file rilevati. Per HTML salvato o codice sorgente copiato, incollalo nel Bulk File URL Extractor. Fornisci un URL base quando il codice sorgente contiene link relativi.
Scegli tra scansionare una pagina e analizzare HTML incollato
La scansione di una pagina web caricata può trovare file disponibili nel browser, mentre l'estrattore online legge solo l'HTML o il testo che incolli. Scegli il metodo che corrisponde al tuo punto di partenza, quindi rivedi gli URL risultanti prima di usarli per i download.
Dove compaiono gli URL dei file in HTML
I link ordinari usano href, mentre immagini e media comunemente usano src. Le immagini responsive possono elencare diversi candidati in srcset. Le librerie di lazy-loading spesso memorizzano gli URL reali in data-src, data-original o attributi dati personalizzati.
I fogli di stile e il CSS inline possono fare riferimento ai background tramite url(). Anche il testo grezzo può contenere URL completi che non sono associati a un elemento HTML.
- link href
- Attributi src e poster
- Candidati srcset e data-srcset
- CSS url() valori e URL assoluti grezzi
Risolvi correttamente i percorsi relativi
Un valore come ../files/report.pdf ha significato solo in relazione alla pagina da cui proviene l'HTML. Fornisci l'URL della pagina originale come base in modo che l'estrattore possa trasformare i percorsi relativi in indirizzi completi.
I link relativi al protocollo che iniziano con // normalmente ereditano HTTPS su una pagina sicura. I percorsi relativi alla root che iniziano con / utilizzano l'origine del sito web corrente.
- Mantieni l'URL della pagina originale
- Usalo come URL base
- Normalizza percorsi relativi al protocollo e alla radice
- Rivedi i domini risolti prima di usare la lista
Filtra URL candidati per intento
Non ogni URL nel codice sorgente è un file scaricabile. Le pagine contengono link di navigazione, API, analitiche, font, script, fogli di stile e parametri di tracciamento. Filtra per estensioni rilevanti e analizza URL ambigui.
Per le immagini, includi formati moderni come WebP e AVIF. Per i documenti, considera PDF, DOCX, XLSX, CSV, PPTX e archivi secondo il compito.
Sorgente HTML versus pagina renderizzata
Sorgente copiato rappresenta solo ciò che hai fornito. Potrebbe perdere risorse inserite dopo l'esecuzione di JavaScript, contenuti caricati dopo lo scorrimento o URL creati durante l'interazione.
Usa l'estrattore offline per frammenti di codice sorgente, HTML esportato, modelli di email e revisione del codice. Usa l'estensione GrabAll per la pagina renderizzata in tempo reale e i flussi di lavoro basati sul contesto del browser.
Valida prima del download
Deduplica la lista, ispeziona i domini e testa un piccolo campione. Un'estensione corrispondente in un URL non garantisce che la risposta sia valida o che tu sia autorizzato a usarla.
Evita di richiedere automaticamente liste non revisionate di grandi dimensioni. La validazione previene link rotti, endpoint di tracciamento indesiderati e carichi inutili.
Domande frequenti
L'estrattore può risolvere link relativi ../?
Sì, quando fornisci l'URL originale della pagina come indirizzo base.
L'estrazione HTML include le immagini srcset?
Lo strumento GrabAll verifica attributi comuni delle sorgenti e delle immagini responsive, inclusi i candidati srcset.
Perché alcuni file di pagine live mancano nell'HTML copiato?
JavaScript può aggiungerli dopo il caricamento iniziale dell'HTML. Usa l'estensione del browser in tempo reale per contenuti della pagina resi e caricati dinamicamente.
Tutti gli URL estratti sono sicuri da scaricare?
No. Controlla domini, tipi di file, permessi e un piccolo campione prima di usare una lista di risultati.
GrabAll scansiona la pagina e raccoglie immagini, documenti, media e altri file scaricabili in un'unica lista chiara, così puoi scegliere esattamente cosa salvare.