
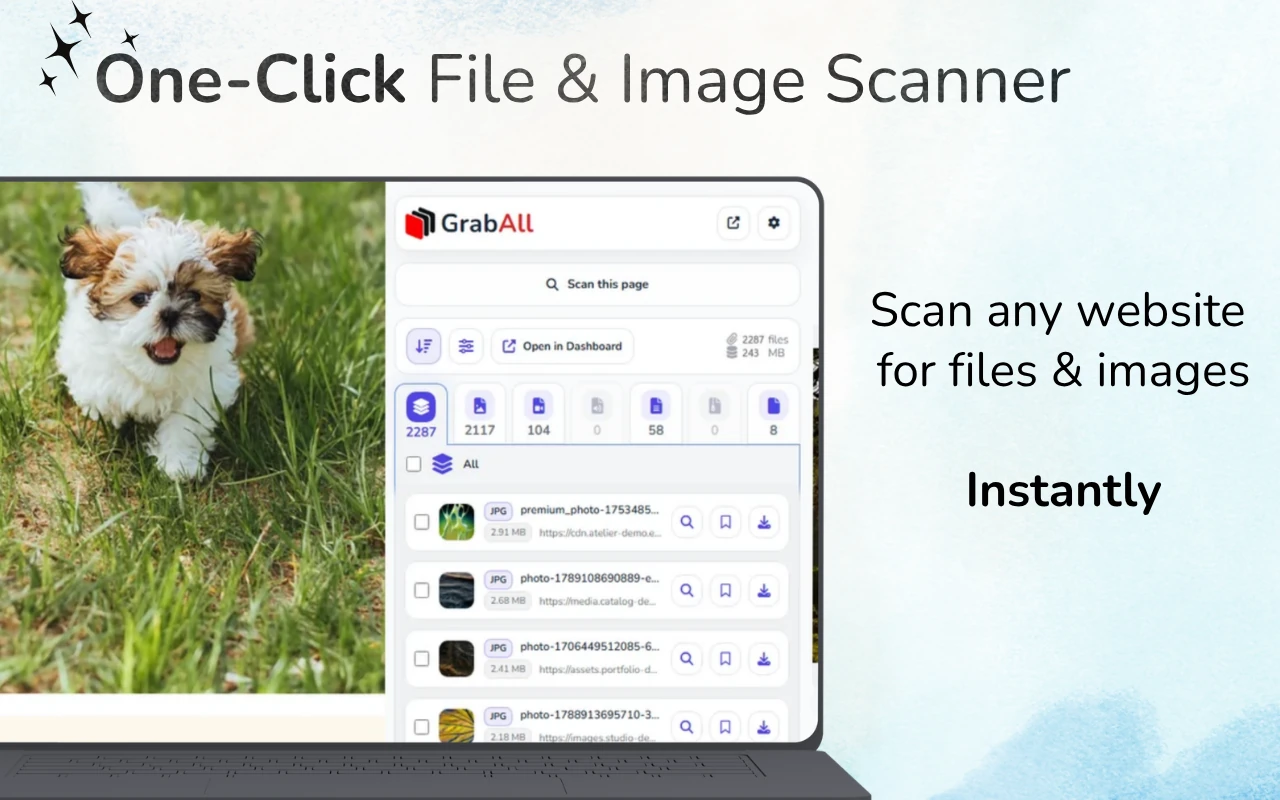
Snel antwoord: Open de webpagina, laad de relevante inhoud en scan deze met GrabAll. Filter gedetecteerde bestanden op type of grootte, controleer previews en bestandsnamen, en sla de geselecteerde links op of kopieer ze. Sommige resources verschijnen alleen na een interactie met de pagina.
Zoek naar bestandslinks op de geladen pagina
Downloadknoppen, documentlijsten, afbeeldingskaarten en media-elementen kunnen allemaal bestanden blootgeven. Begin met het laden van het gedeelte dat de bronnen bevat, scan vervolgens en beoordeel de resultaten. Een scanner kan alleen bronnen weergeven die de pagina beschikbaar maakt voor de browser.
Wat telt als een downloadbaar bestand
Een downloadbaar bestand kan een gekoppeld document, een afbeeldingsbron, een medialelement, een archief, een spreadsheet of een ander openbaar middel dat door de pagina wordt verwezen zijn. De browser moet voldoende weten over de bron om het op te vragen of weer te geven.
Bestandsdetectie betekent niet serververkenning. GrabAll werkt met de huidige pagina en opgegeven URL's, niet met privé-mappen of niet-gerapporteerde serverinhoud.
- Ankerlinks naar documenten en archieven
- Afbeelding src-, srcset- en lazy-load-attributen
- Video-, audio-, poster- en bron-elementen
- Publieke bestands-URL's die aanwezig zijn in paginatekst of data-attributen
Een gestructureerd ontdekkingsproces
Scan eerst de meest relevante pagina. Groepeer resultaten op type, controleer vervolgens de bestandsextensies, MIME-hints, afmetingen, groottes en bron-domeinen. Gebruik waar beschikbaar previews.
Als de pagina dynamisch is, laat dan het relevante gedeelte laden voordat u gaat scannen. Vermijd scrollen door niet-gerelateerde gebieden, omdat dit aanbevelingen en navigatie-elementen aan de resultaten kan toevoegen.
- Kies een specifieke pagina
- Laad de content die relevant is voor de taak
- Scan en groepeer resultaten op type
- Filter, bekijk een voorbeeld en selecteer de nuttige bestanden
URL's zonder duidelijke extensies
Sommige downloads gebruiken routes zoals /download?id=123 in plaats van bestandsnamen die eindigen op .pdf of .zip. Deze links kunnen moeilijker te classificeren zijn voordat de server reageert. Paginalabels, response headers en het downloadgedrag van de browser kunnen meer informatie bieden.
Ga er niet van uit dat elke lange URL een bestand is. Tracking-, navigatie- en API-links kunnen er hetzelfde uitzien.
Wanneer scannen beter is dan de bron bekijken
Het bekijken van de HTML-bron kan technische gebruikers helpen, maar moderne pagina's voegen vaak inhoud toe nadat het initiële document is geladen. Een browserextensie kan de gerenderde context inspecteren en resultaten presenteren in een beoordelingsgerichte interface.
Voor geplakte HTML of offline bron, gebruik de gratis Bulk File URL Extractor. Voor de live pagina, gebruik GrabAll zodat je ontdekking met previews en downloadselectie kunt combineren.
Stel realistische verwachtingen
Bestanden achter authenticatie, gegenereerd na beveiligde API-aanroepen, opgeslagen in privé-systemen, of geleverd via DRM vallen buiten het bereik van een normale paginascanner. Respecteer toegangsregels en gebruik officiële downloadcontrols waar beschikbaar.
De beste resultaten komen van pagina's die opzettelijk resource-links, galerijen, bijlagen, documenten of gewone mediabestanden blootstellen.
Veelgestelde vragen
Kan GrabAll bestanden vinden die niet op de pagina gelinkt zijn?
Nee. Het organiseert bronnen en links die beschikbaar zijn in de browser; het zoekt geen privéserverdirectories of onthult niet blootgestelde bestanden.
Moet ik de startpagina of een specifieke pagina scannen?
Gebruik de meest specifieke pagina mogelijk. Dit levert minder niet-gerelateerde bestanden op en schonere resultaten.
Wat als een URL geen bestandsextensie heeft?
Het kan nog steeds een download produceren, maar de classificatie is minder betrouwbaar totdat de server reageert. Controleer het paginalabel en gebruik de officiële bediening wanneer u onzeker bent.
Kan ik in plaats daarvan links uit gekopieerde HTML extraheren?
Ja. GrabAll biedt een gratis Bulk File URL Extractor voor geplakte HTML, broncode en tekst.
GrabAll scant de pagina en brengt afbeeldingen, documenten, media en andere downloadbare bestanden in één duidelijke lijst, zodat u precies kunt kiezen wat u wilt opslaan.