
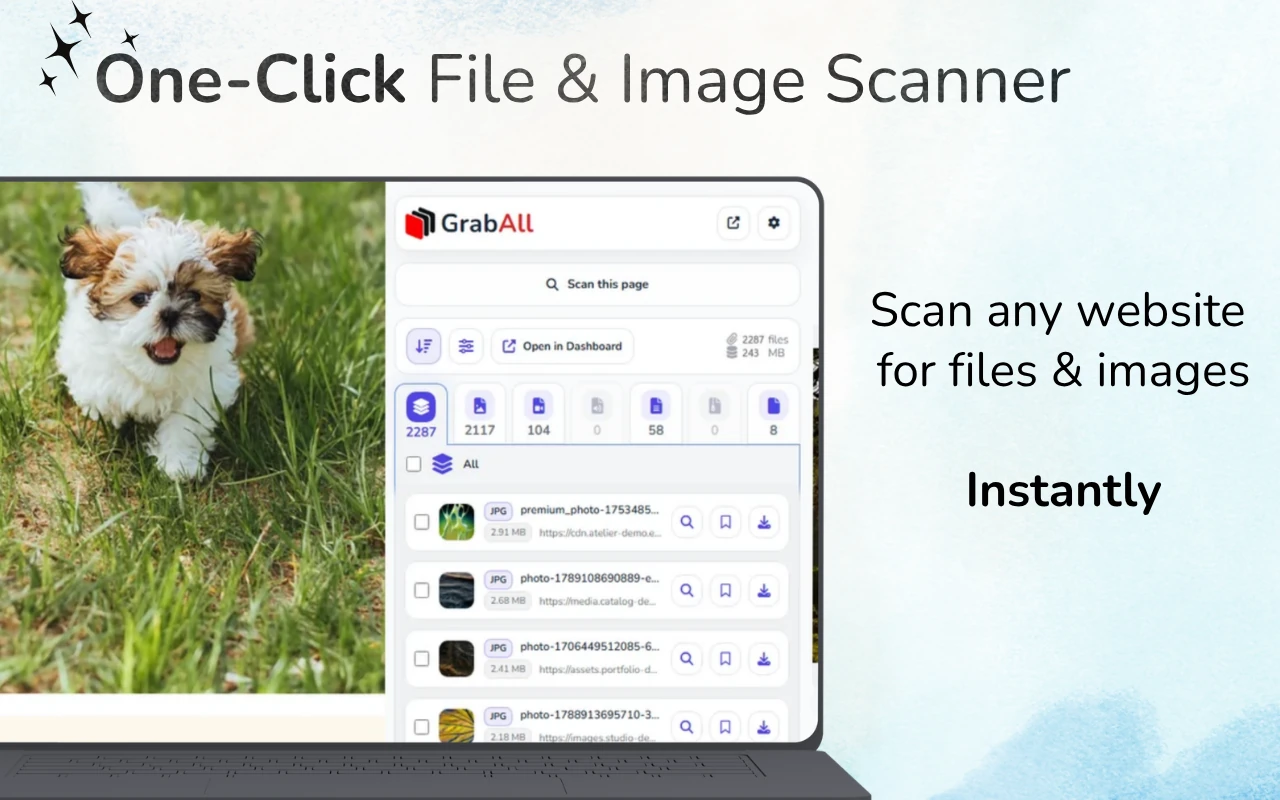
Raskt svar: For en live nettside, skann med GrabAll og kopier de oppdagede fil-URLene. For lagret HTML eller kopiert kildekode, lim det inn i Bulk File URL Extractor. Oppgi en base-URL når kilden inneholder relative lenker.
Velg mellom å skanne en side og analysere limt HTML
Skanning av en lastet nettside kan finne filer tilgjengelig i nettleseren, mens nettbasert ekstraktor kun leser HTMLen eller teksten du limer inn. Velg metoden som passer ditt utgangspunkt, og gå gjennom de resulterende URLene før du bruker dem til nedlastinger.
Hvor fil-URL-er vises i HTML
Vanlige lenker bruker href, mens bilder og media ofte bruker src. Responsive bilder kan liste flere kandidater i srcset. Lazy-loading biblioteker lagrer ofte de riktige URL-ene i data-src, data-original eller egendefinerte data-attributter.
Stilark og innebygd CSS kan referere bakgrunner via url(). Råtekst kan også inneholde komplette URL-er som ikke er knyttet til et HTML-element.
- href-koblinger
- src- og poster-attributter
- srcset- og data-srcset-kandidater
- CSS url()-verdier og rå absolutte URL-er
Løs relative stier korrekt
En verdi som ../files/report.pdf er bare meningsfull i forhold til siden HTML-en kom fra. Oppgi den opprinnelige side-URLen som base slik at ekstraktoren kan gjøre relative stier om til komplette adresser.
Protokollrelative koblinger som begynner med // arver normalt HTTPS på en sikker side. Rot-relative stier som begynner med / bruker nettstedets nåværende opprinnelse.
- Behold den opprinnelige kilde-URL-en
- Bruk det som basis-URL
- Normaliser protokollrelative og rot-relative stier
- Gjennomgå de løste domenene før du bruker listen
Filtrer kandidat-URLer etter hensikt
Ikke alle URL-er i kildekoden er nedlastbare ressurser. Sider inneholder navigasjonslenker, API-er, analyse, fonter, skript, stilark og sporingsparametere. Filtrer etter relevante filtyper og inspiser tvetydige URL-er.
For bilder, inkluder moderne formater som WebP og AVIF. For dokumenter, vurder PDF, DOCX, XLSX, CSV, PPTX og arkiver i henhold til oppgaven.
HTML-kilde versus den gjengitte siden
Kopiert kilde representerer kun det du leverte. Den kan mangle ressurser som ble satt inn etter at JavaScript kjørte, innhold lastet etter scrolling, eller URL-er opprettet under interaksjon.
Bruk den offline utvinneren for kildekoder, eksportert HTML, e-postmaler og kodegjennomgang. Bruk GrabAll-utvidelsen for live-renderte sider og nettleserbaserte arbeidsflyter.
Valider før nedlasting
Fjern duplikater fra listen, inspiser domener, og test et lite utvalg. En matchende filtype i en URL garanterer ikke at responsen er gyldig eller at du har rett til å bruke den.
Unngå å automatisk be om store uanmeldte lister. Validering forhindrer ødelagte lenker, uønskede sporingsendepunkter og unødvendig belastning.
Ofte stilte spørsmål
Kan utvinneren løse ../ relative lenker?
Ja, når du oppgir den opprinnelige side-URLen som grunnadresse.
Inkluderer HTML-ekstraksjon bilder fra srcset?
GrabAll-verktøyet sjekker vanlige kilde- og responsiv-bildeattributter, inkludert srcset-kandidater.
Hvorfor noen live-side-filer mangler fra kopiert HTML
JavaScript kan legge dem til etter at den opprinnelige HTML-en lastes. Bruk nettleserutvidelsen i sanntid for gjengitt og dynamisk lastet sideinnhold.
Er alle ekstrakterte URL-er trygge å laste ned?
Nei. Gå gjennom domener, filtyper, tillatelser og et lite utvalg før du bruker en resultatliste.
GrabAll skanner siden og samler bilder, dokumenter, media og andre nedlastbare filer i én tydelig liste, slik at du kan velge nøyaktig hva du vil lagre.